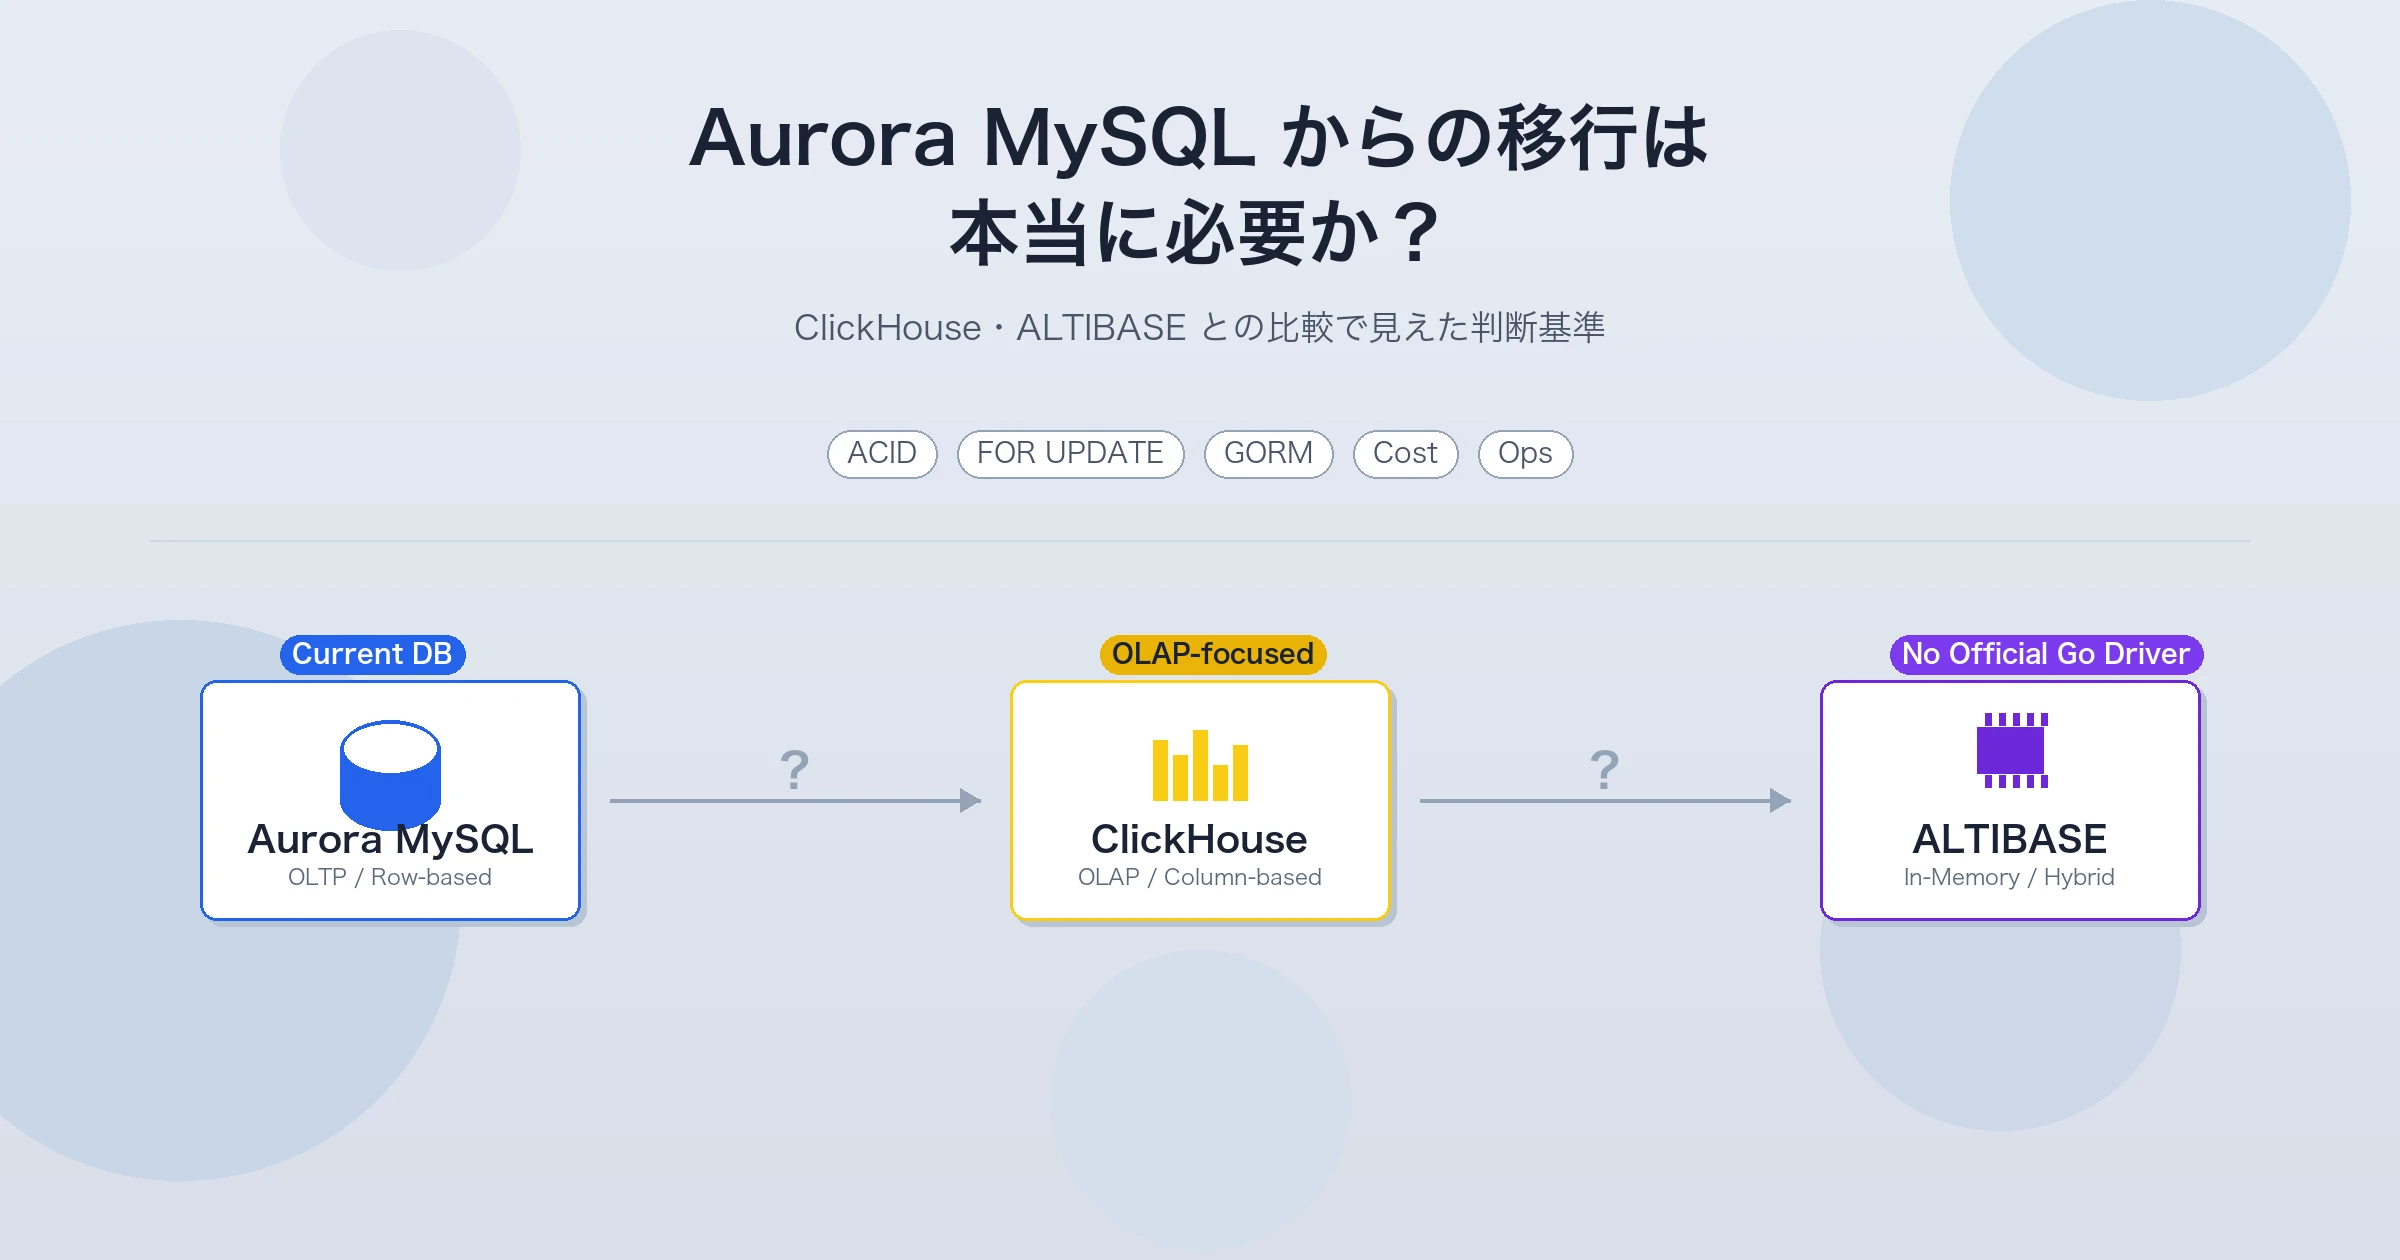
Aurora MySQL、ClickHouse、ALTIBASEの3つのデータベースを比較する概念図

Aurora MySQLからの移行は本当に必要か──ClickHouse・ALTIBASEとの比較で見えた判断基準

TL;DR Go + Gin + GORMで動くOLTPサービスを題材に、Aurora MySQLからClickHouse®・ALTIBASEへの全面移行を技術調査した。結論は「どちらも全面移行は非推奨」 ClickHouseはトランザクションが実験的機能で、ClickHouse Cloudでは使えない。SELECT ... FOR UPDATE もないため、行ロックに頼る処理を移せない(ClickHouse 25.8で実際に確認) ローカルで計測すると、1,000万行の集計はClickHouseがMySQLの約440〜840倍速かった。一方、主キー検索はMySQLが約5倍のスループットだった。同時に残高を減らす処理では、MySQLは FOR UPDATE で二重消費を防げたが、ClickHouseには防ぐ手段がなかった ALTIBASEはトランザクションに対応するが、Goの公式ドライバとGORM対応がなく、マネージドサービスもない 分析の要件がある場合に限り、Aurora MySQLにClickHouseを足すハイブリッド構成が合理的 判断の軸は「ワークロード特性」「トランザクション要件」「言語エコシステム」「運用体制」の4つ。この順に確認すると、早い段階で候補を絞れる はじめに こんにちは。and factory でバックエンドエンジニアをしている江州です。 「新しいDBのほうが速い」という話を聞くと、今のDBから乗り換えたくなります。しかし、速さだけで比べて移行を決めると、整合性や運用の問題は移行後に表面化します。 最近は、AIのワークロードに強く、大企業での採用も進んでいる新しいDBが次々に登場しています。私は2026年11月5日・6日に開催された「db tech showcase 2026」に参加し、さまざまなDBの説明会を聞いてきました。これをきっかけに、自社のサービスでも新しいDBが選択肢になるのかを調べることにしました。 もう1つの背景として、日頃から感じていた不満がありました。管理画面などで使う集計系のSQLは、対象の件数が増えるとどうしても遅くなります。私たちはスロークエリの閾値を0.3秒に設定していますが、大量のデータを対象にした複雑な集計では、1秒を超えるクエリがあります。閾値の3倍以上です。集計に強いDBを使えば、この不満を解消できるのではないかと考えました。 障害やコスト超過のような差し迫った課題があったわけではありません。事業部のサーバーエンジニア5人のチームとして、技術選定の判断材料を持っておくための技術調査です。本記事では、調査の過程と、同じ検討をする方が使える判断基準を共有します。 なぜClickHouseとALTIBASEを比べたのか 候補には、強みの方向が異なる2つのDBを選びました。どちらもAI時代の需要と大企業での採用実績を打ち出していますが、得意な処理は正反対です。 ClickHouse は列指向のOLAP向けDBで、大量データの集計を得意とします。 AI企業での採用: 2025年10月の公式発表によると、顧客は2,000社超。Anthropic、Meta、LangChain、Weights & BiasesなどのAI企業が、ClickHouse Cloudで業務上重要なシステムを動かしているとしている AI向けの機能: ベクトル検索、JSON、全文検索の機能を強化している。AIエージェントからデータを扱うためのMCPサーバーも提供している ALTIBASE はインメモリとディスクを1つのエンジンで扱う、ハイブリッド型のOLTP向けDBです。単一行の読み書きを得意とします。 大企業での採用: 公式サイトによると、顧客は700社以上で、Fortune Global 500の企業19社を含む。韓国の通信大手3社(SK Telecom、KT、LG U+)、Samsungグループの各社、大手銀行が採用しているとしている AIへの取り組み: 2025年10月のCTOインタビューで、標準SQLでベクトル演算を扱える次世代版を研究中と述べている 性格の異なる2つを同じサービスに当てはめると、どの条件で移行が成り立たなくなるかを明確にできます。後半で紹介する判断基準は、この条件をもとにしています。 対象サービスの前提 対象は、自社で運用しているOLTPサービスのバックエンドです。 項目 内容 言語・フレームワーク Go 1.27 + Gin v1.10 ORM・ドライバ GORM v1.30 + go-sql-driver/mysql v1.8 現行DB Amazon Aurora MySQL(ライター/リーダー構成) 実行環境 AWS(東京リージョン) 開発・運用体制 事業部のサーバーエンジニア5人 主な機能 認証、予約管理、ポイント管理、決済、レビュー トランザクションを使うファイル アプリケーション層で20ファイル スキーマの規模 全モジュール合計で200以上のマイグレーション トランザクションを使うファイル数は、リポジトリのアプリケーション層で Begin() を検索して数えました。認証・予約・決済・ポイントは、どれも単一行の読み書きが中心です。このサービスは典型的なOLTPワークロードだと言えます。 ...
2026年11月20日 · 読了時間: 5分 · 江州俊亮
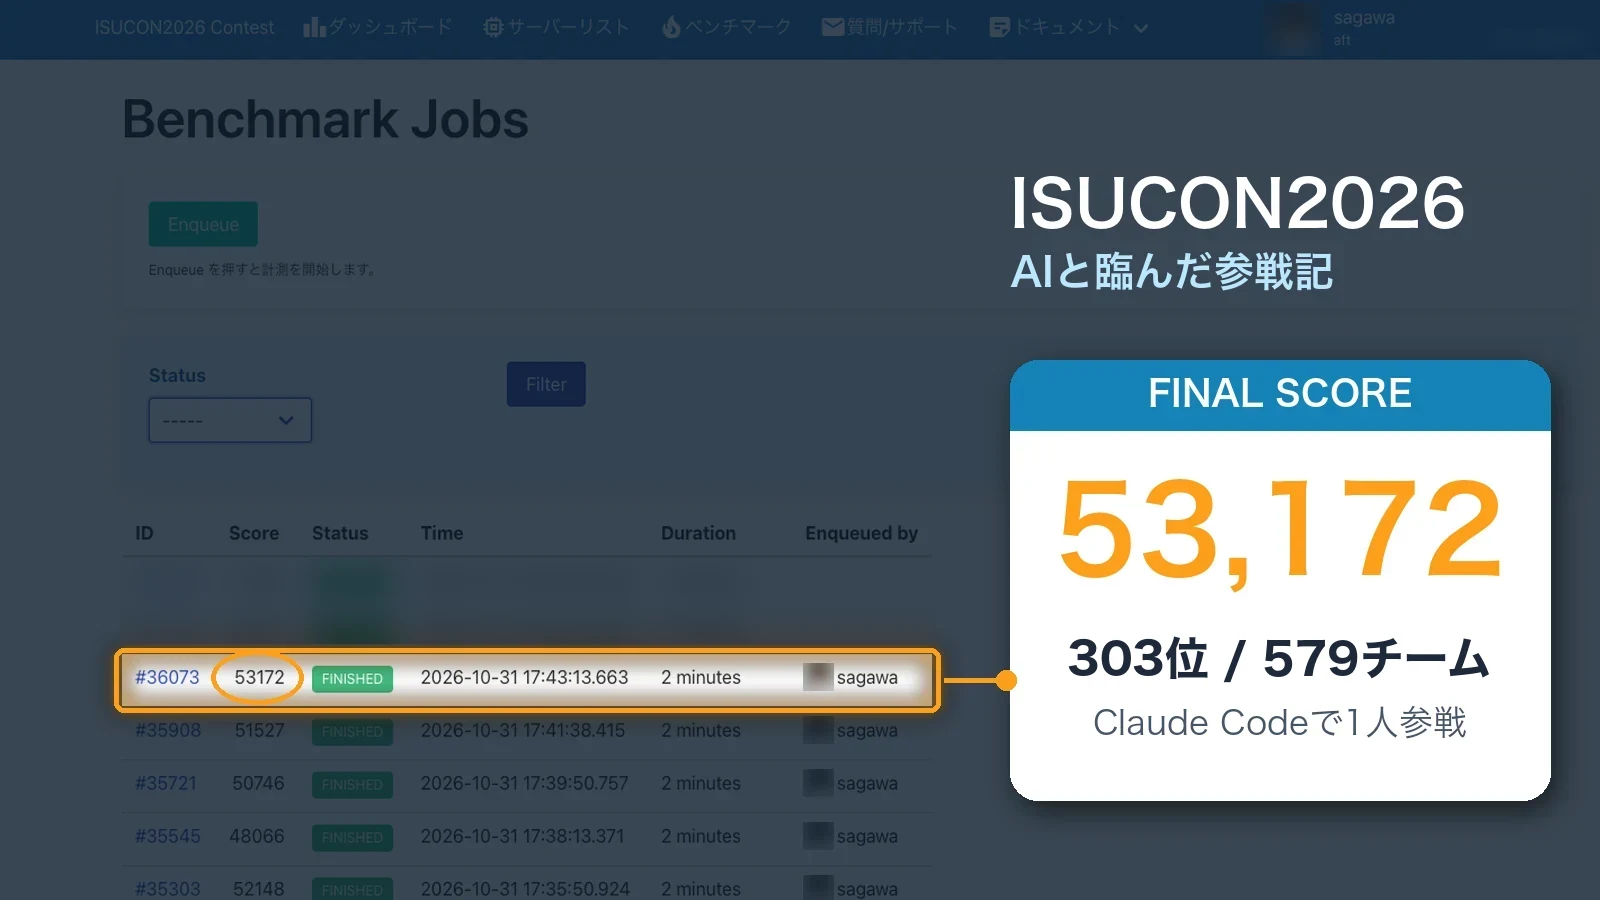
ISUCON2026ポータルのベンチマーク結果一覧のスクリーンショットで、最終スコア53,172点の行を強調し、303位/579チームと示したカバー画像

ISUCON2026に1人で参戦しました ── AIで準備は1時間、勝負は「AIに方向を考えさせる仕組み」へ

はじめに ISUCON2026に参加し、最終スコアは53,172点、順位は303位でした。参加は856チーム(負荷走行を実行したのは662チーム)で、失格にならず順位がついた579チーム(公式結果)のうち、ほぼ中央の順位です。 これまでは会社のメンバーとチームで出場していましたが、今回は1人での参戦です。今年は、一緒に出るメンバーの都合がつきませんでした。ただ、1人でもAIを使えば多少はできることがあるのではと考え、無理にメンバーを集めることはしませんでした。1人での参加は初めてでしたが、AIを活用したことで中央付近の順位に入れました。 今回はAIエージェントのClaude Code(モデルはClaude Opus 5.5)を全面的に使って臨みました。その結果、参加した感覚が今までとは大きく変わり、AIについて深く考えさせられる大会になりました。結論から言うと、次の2点です。 ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で、AIが終えられる。人間は「どう改善するか」に思考を集中できる 一方で、上位との差は「構成の方向」という全体設計の判断で開いた。AIの改善案は、すぐ手の届く箇所を優先する局所的なものに寄りがちで、AIに全体の方向を考えさせる問いかけや仕組みを用意するのが人間の役割になる この記事では、当日の流れとスコアの推移を紹介します。そのうえで、終了後に上位チームの参加記と比べて分かった「足りなかった部分」を、技術とAIの使い方の両面から整理します。最後に、その反省から導いた次回やること(ベンチマークをAIのループに入れる、構成案をAIに複数出させて午前中に方針を固める、など)をまとめます。 対象読者 ISUCONに参加したことがある、またはこれから参加したい方 AIを使ったパフォーマンスチューニングがどこまでできるのかを知りたい方 実際のプロダクトでのパフォーマンス改善にAIを活用したい方 前提となる環境 ISUCON2026の競技環境は、リージョンをまたいだ複数台構成でした。この記事に出てくるサーバーは次のとおりです。 サーバー 役割(最終構成) インスタンス asia1 アプリケーション(全リージョンの /api/ を集約) c5 asia2 DB(PostgreSQL) c5 europe / america nginx(/api/ を asia1 へ転送) c7i 使用した主な技術とバージョンは次のとおりです。nginxとOSのバージョンは、記録が残っていないため省略します。 種別 バージョン Go 1.26.5 Echo v5.3.1 pgx / sqlx v5.11.0 / v1.4.0 PostgreSQL 16 Claude Code 2.1系(当日の最新は2.1.316。モデルはClaude Opus 5.5) 1. 今までのISUCONと、今回のISUCON 1.1 今までの感覚 これまでのISUCONでは、序盤にとにかく時間を取られていました。 ドキュメントを読み込むのに時間がかかる セットアップやデプロイの仕組みづくりにも時間がかかる 簡単なボトルネックを取り終わった頃には、もう半分くらい時間が過ぎている 残り時間で何ができるか、という状態から本格的な改善が始まります。3人で取り組んでもやることが多く、手一杯でした。チームワークと、各自の総合的な技術力が勝敗を分ける競技だったと言えます。 1.2 今回の感覚 今回は、AIを活用して、ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で終えられました。 そのため、どうやって改善するかに思考を集中できました。さらに、AIの側からも多くの改善案が出てきます。自分の力だけでは届かない改善まで実現できてしまう感覚がありました。 今回のISUCONで大事だったのは、AIをうまく使いこなせることです。次の章では、具体的にどう進めたのかを時系列で紹介します。 2. 当日の流れ 2.1 最初の1時間で「速度改善だけに集中できる状態」を作る 最初に行ったのは、改善に集中するための土台づくりです。 ...

2026年11月17日 · 読了時間: 4分 · 佐川 豪
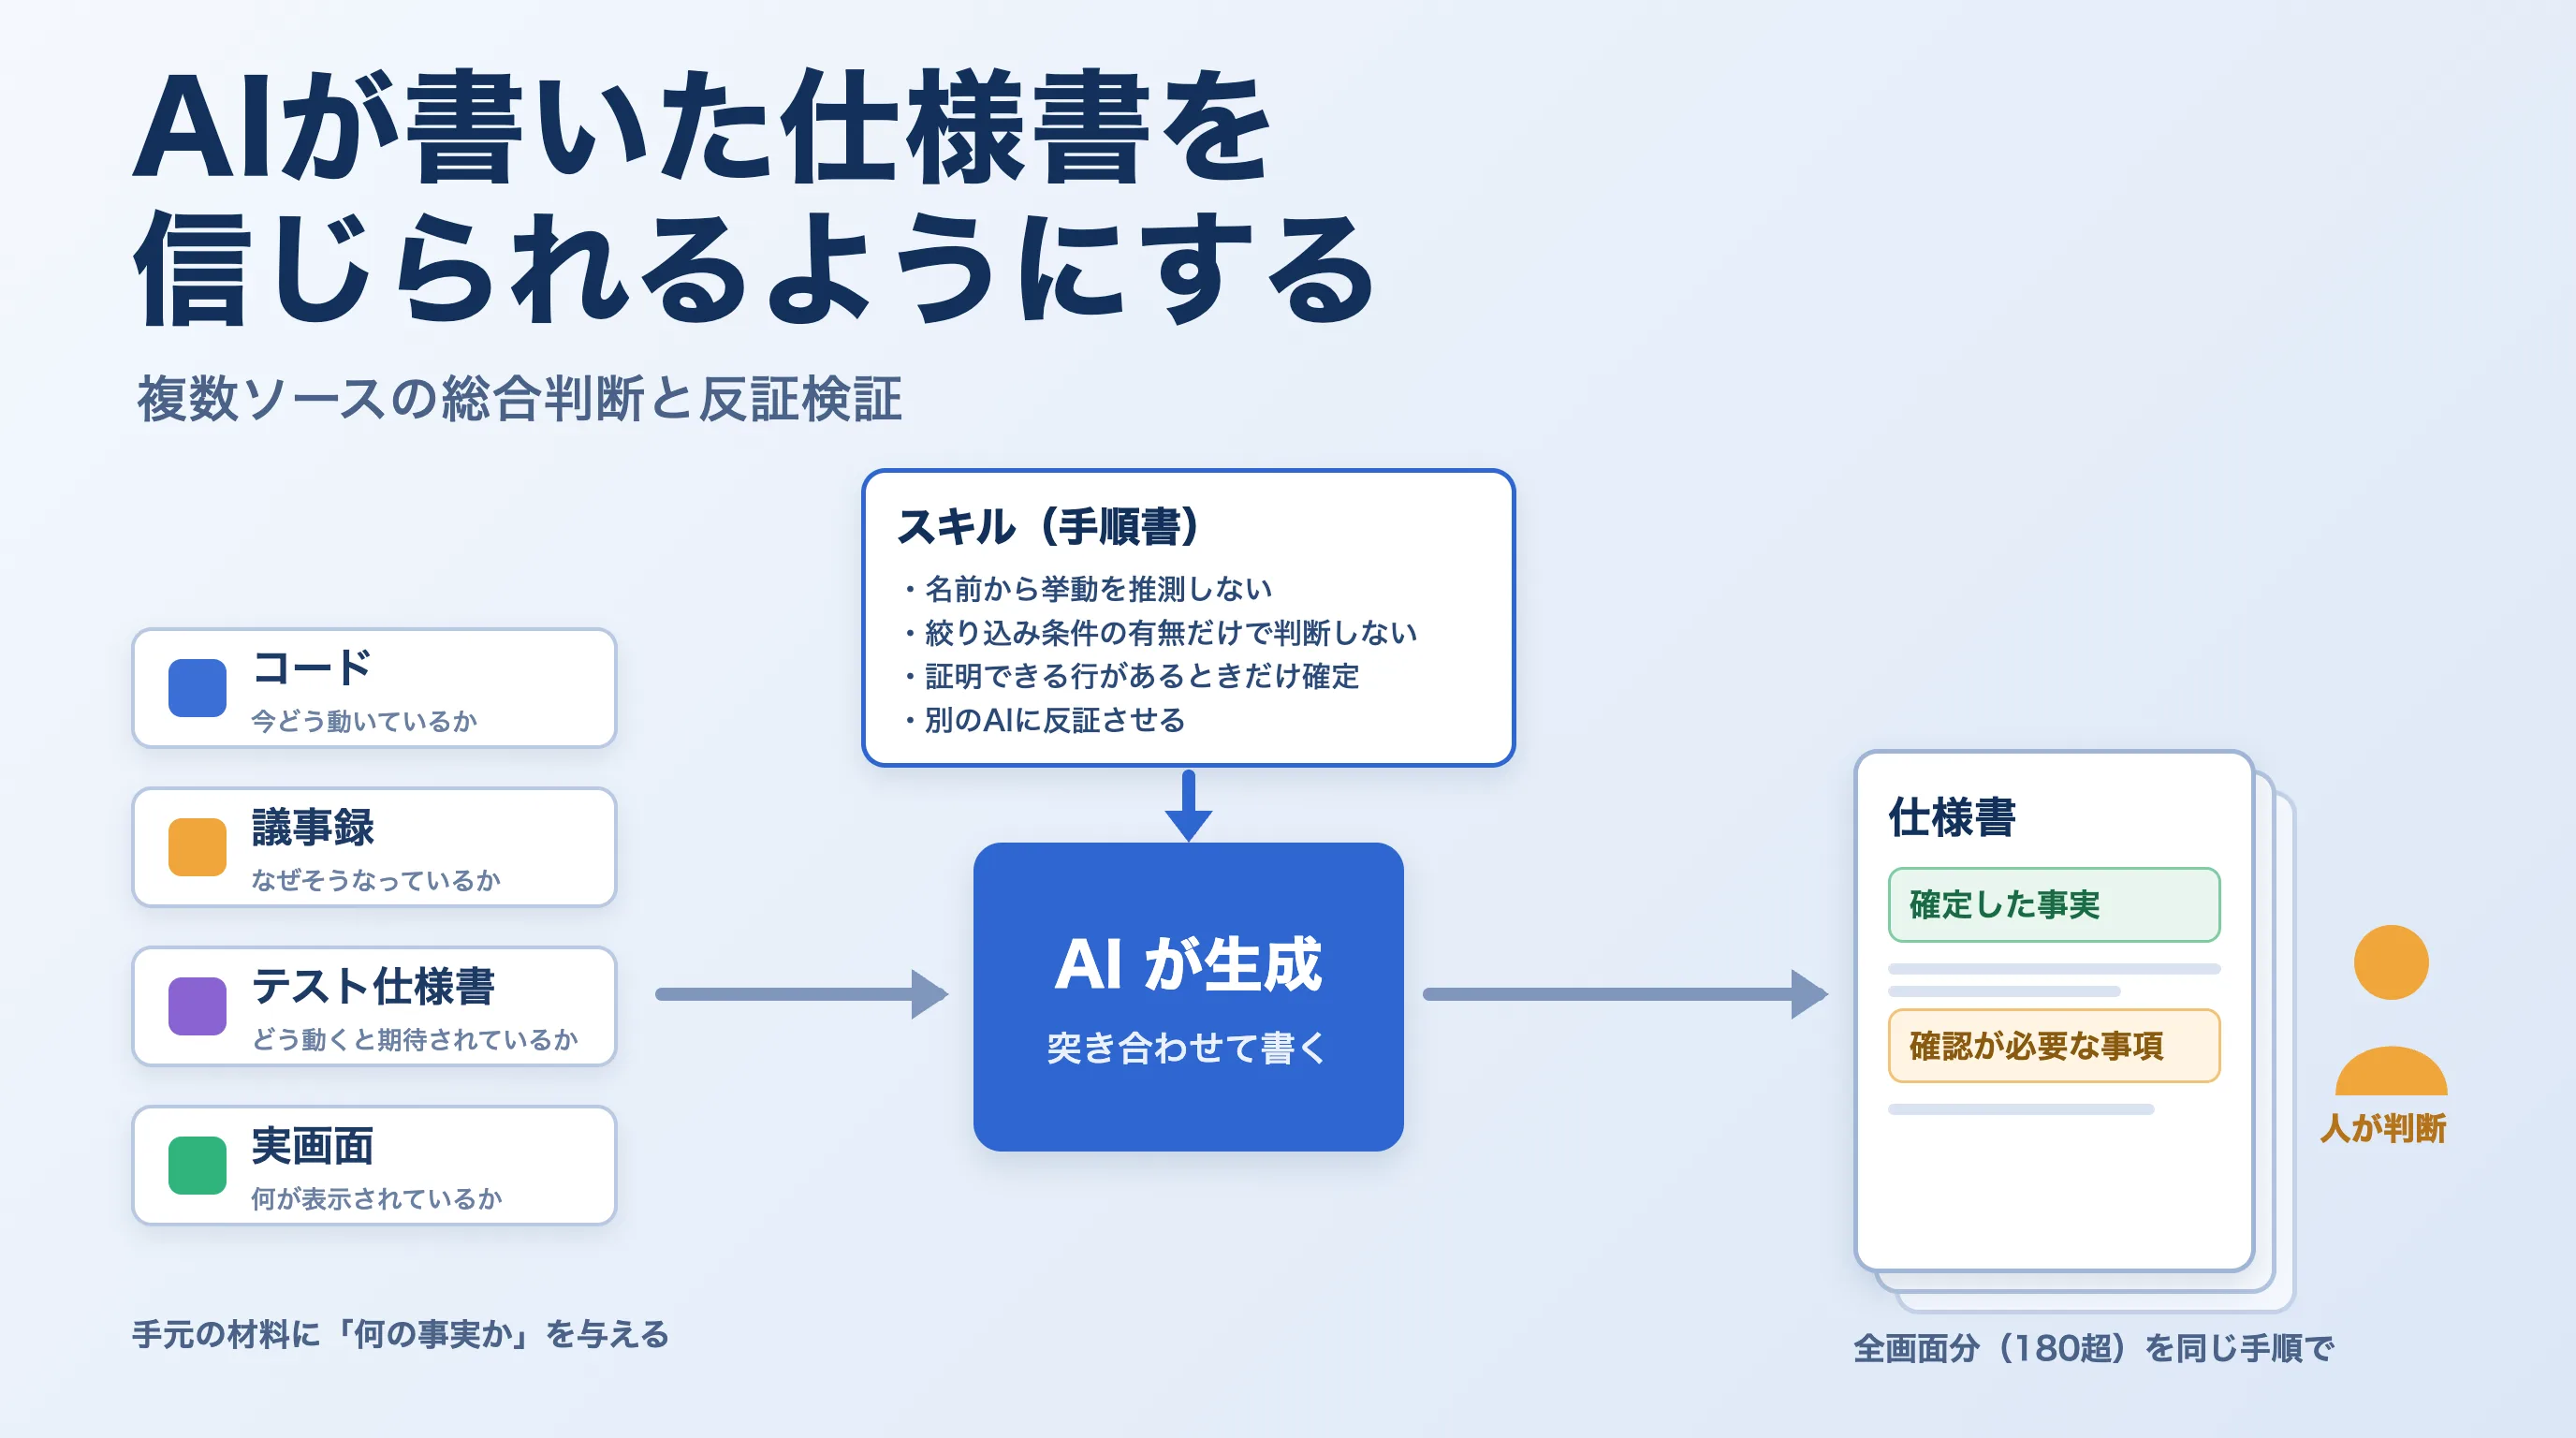
複数の材料をAIが突き合わせ、別のAIが反証してから仕様書に確定する流れのイメージ

AIが書いた仕様書を信じられるようにする ── 複数ソースの総合判断と反証検証

はじめに 私が担当するサービスには、画面ごとの仕様書がありませんでした。あるのは、QAのために書かれたテスト仕様書と、仕様を決めた会議の議事録、設計当時の資料だけです。設計資料はコードの変更に追いついていません。 この状態を、画面ごとに1枚、今どう動いていてなぜそうなっているかを書いた仕様書を全画面分そろえることで解消したいと考えました。画面は3つのサイトを合わせて180を超えます。人が手で書く時間はありません。そこでAIエージェントを書き手にしました。 AIは、もっともらしいが事実と違うことを平気で書きます。関数やテーブルの名前から挙動を推測し、確かめずに断定します。180を超える仕様書が速く出てきても、どれを信じてよいのか分からなければ、業務側に渡せません。 この記事は、その「信じてよいのか分からない」を減らすためにやったことをまとめたものです。結論から言うと、次の3つです。 コード・議事録・テスト仕様書・実画面という手元の材料に「何の事実か」という役割を与えて突き合わせ、食い違った事実と決まらないことは「確認が必要な事項」として人に渡す AIが間違える典型を名指しで禁止し、要になる主張は証明できるコード行があるときだけ確定させる 別のAIに反証させて根拠のない断定を撤回させ、この手順一式をスキルとして固定して全画面に回す 説明は最初から最後まで1つの例で通します。カスタマーサポート向けサイトの会員一覧に、退会した会員と削除された会員は表示されるのか。単純に見えますが、AIが最初に出した答えは間違っていました。 題材は、これまでの記事と同じ架空のオンラインレッスンプラットフォームです。会員向け・講師向け・カスタマーサポート向けの3つのサイトが、会員や講師といった共通のドメインを共有しています(構成はモジュラーモノリス構成の記事を参照してください)。バックエンドはGoで、ORMにGORMを使っています。AIエージェントはClaude Codeです。実際に起きた出来事を題材に置き換えて書いていますが、仕組みそのものは言語やツールに依存しません。 対象読者 Claude CodeなどのAIエージェントに定型作業を任せていて、成果物の質を担保したい方 仕様書が無い、または古いサービスを抱えていて、AIで整備できないかと考えている方 AIの出力に混ざる「もっともらしい誤り」を、実務でどう抑え込むかの具体例を知りたい方 この記事で得られること 全画面分の仕様書をAIに書かせるとき、作る文書と手元の材料をどう定義したか 材料に役割と優先順位を与え、食い違いを決める進め方 AIに推測で断定させないための具体ルールと、別のAIによる反証検証の仕組み 出力を業務の言葉に翻訳させることが、なぜ精度に効くのか 手順一式をスキルとして固定し、全画面を同じ品質で回す運用 動作確認環境 種別 バージョン Go 1.26.3 GORM v1.30 系 Claude Code 2.1 系 1. やりたかったこと ── 全画面分の仕様書を、人が確認できる形で 1.1 作る文書 まず、AIに何を作らせるのかを決めました。ここで言う仕様書は、画面1つにつき1枚の文書です。「この画面が今どう動いていて、なぜそうなっているか」を、業務側の人が読める言葉で書きます。画面の項目(表示する情報や操作のまとまり)ごとに「定義」「業務ルール」「なぜそうなっているか」を持ちます。 そして、仕様書の各項目に必ず「確認が必要な事項」の欄を置き、末尾に一覧として集約しました。AIが材料から確定できなかったこと、材料同士が食い違っていて人の判断が要ることを、ここに集めます。 この欄を最初から用意したのには理由があります。全画面分の仕様書をAIに書かせるとき、人がやるべき仕事は「全文を読んで正しいか確かめる」ことではありません。それでは人の負担がほとんど減りません。人がやる仕事は、AIが「決められなかった」と申告した箇所だけを判断することです。だから仕様書は、「確定した事実」と「確認が必要な事項」の2つに分かれていなければなりません。AIには「決められないことは推測で埋めず、この欄に回せ」と指示します。以降の章で「決める」「残す」と言うときは、この2つの欄のどちらに書くか、という話です。 1.2 全画面をどう回したか 画面は3サイトで180を超えます。進め方は次のとおりです。 各サイトの画面一覧を作り、画面名と画面のURLを列挙する 1画面ずつ、AIエージェントに仕様書を書かせる。手順はスキル(AIエージェント向けの手順書。8章)として固定する 出てきた仕様書の「確認が必要な事項」を人が見て、業務側に確認する 確認結果を仕様書に反映する 1画面あたりの人の作業を、最初の承認と「確認が必要な事項」の判断に絞れたので、全画面でも回りました。ただし、それは「確定した事実」の欄が本当に事実であってこそです。ここが崩れると、人は結局全文を疑って読むことになります。この記事の残りは、その欄を信じられるようにするための取り組みです。 2. 手元にある材料 仕様書は1つの材料からは作れません。手元にあった材料(記事タイトルで言う「ソース」)は次の4つで、どれも多くの会社にある種類のものです。 材料 何か 読者の会社での対応物 コード 実際に動いているプログラム リポジトリ 議事録 仕様を決めた会議のメモ 会議メモ、決定が残ったチャットのスレッド、チケットのコメント テスト仕様書 「この画面でこう操作するとこうなるはず」を書いた手順書 受け入れテスト手順書、QAのテストケース一覧 実画面 AIがブラウザ操作で検証環境を開いて読み取った画面 ステージング環境 名前が似ているので1つ注意があります。テスト仕様書は材料の1つで、仕様書はこれから作る文書です。この記事では両者を区別して使います。 ...

2026年9月28日 · 読了時間: 2分 · 高野智明
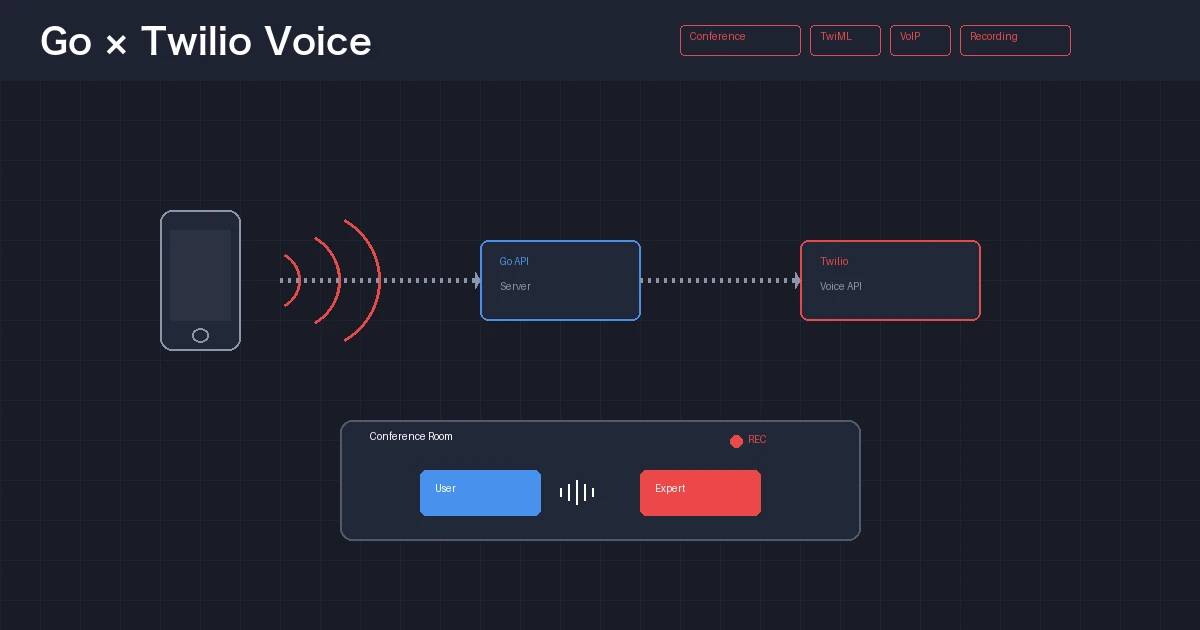
GoとTwilio Voice APIによる通話システムのアーキテクチャ図

GoとTwilioで通話システムを構築する ── Conference・TwiML・VoIP・録音の実装パターン

はじめに こんにちは。and factory でバックエンドエンジニアをしている江州です。 Twilioを使ってGoで通話機能を実装する方法を調べたとき、公式ドキュメントは充実しているもののNode.jsやPythonの例が多く、Goでの実装例はまだ少ないと感じました。 この記事では、Twilioの公式Go SDK(twilio-go)を使い、Conference(会議室)ベースの通話システムを構築するパターンを紹介します。単純な1対1の電話だけでなく、通話中のアナウンス・DTMF認証・VoIP/PSTN両対応・録音といった実用的な要素をカバーします。 対象読者 GoでTwilioを使った通話機能を構築しようとしている方 TwilioのConference / TwiML / VoIPの組み合わせを知りたい方 twilio-go SDKの具体的な使い方を知りたい方 動作確認環境 種別 バージョン Go 1.24 twilio-go v1 系 1. twilio-go SDK のセットアップ Twilioの公式Go SDK twilio-go をインストールします。 1 go get github.com/twilio/twilio-go REST APIクライアントの作成は次のとおりです。 1 2 3 4 5 6 import "github.com/twilio/twilio-go" client := twilio.NewRestClientWithParams(twilio.ClientParams{ Username: "ACxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx", // Account SID Password: "your_auth_token", // Auth Token }) 環境変数 TWILIO_ACCOUNT_SID と TWILIO_AUTH_TOKEN を設定しておけば、引数なしの twilio.NewRestClient() でもクライアントを作成できます。 ...

2026年8月6日 · 読了時間: 8分 · 江州俊亮
usecase層をmockで隔離してテストする構成のイメージ

Goのusecase層に一貫したユニットテストを根付かせる ── mockery v3 × testify × AAAとSkillによる量産設計

はじめに 私の担当するバックエンドでは、機能を積み増す一方で、ビジネスロジックの中心である usecase 層にユニットテストがほぼ無い状態を長らく抱えていました。しかも500を超えるusecaseに、複数人で少しずつテストを足していく必要があります。この規模で一番の敵は「人によってテストの書き方がバラバラになること」です。書き方が揃わないと、レビューは毎回スタイルの指摘に追われ、テスト自体の信頼性も安定しません。 結論から言うと、次のように解決しました。 mockery v3 + testify + AAAパターンでテストの「型」を固定する 書き方一式を Claude CodeのSkills(AIエージェント向けの手順書) として固定し、人が書いてもAIが書いても同じ形に揃える カバレッジをCIで自動計測し、テスト未整備の箇所を可視化する この記事は、その具体的な実装方法と、その形に決めるまでの設計判断をまとめたものです。 前提として、このバックエンドはClean Architecture + DDDをベースにした モジュラーモノリス構成のGoサービスです(構成そのものの詳しい話はこちらの記事をご確認ください)。 対象読者 GoでClean Architecture / DDD風のレイヤード構成を採っていて、アプリケーション層のテストをこれから増やしたい方 既存コードにテストを「後から・複数人で・大量に」足す局面にいる方 mockery v3 + testifyでのモックテストの具体的な書き方の落としどころを知りたい方 この記事で得られること usecase層を「何を境界として」テストするかの考え方(ブラックボックス検証) mockery / テストデータ / 引数検証を、なぜこの形にしたか AAAパターンでの具体的な書き方(引数マッチャーの読み書き分離・output比較・エラー検証) テストデータ生成ヘルパーの設計(newTest{Type} + Optionパターン) 書き方一式をSkillとして固定し、人もAIも同じ形に揃える運用 カバレッジをCIで自動可視化する仕組み 動作確認環境 種別 バージョン Go 1.26.3 mockery v3 系 testify v1 系(mock / assert) CI CircleCI 1. 前提: usecase 層とは何か(ざっくり) アーキテクチャの詳細は本筋ではないので前提だけ。レイヤーの依存方向はおおむね次のとおりです。 adapter(HTTP ハンドラ) → scenario(クライアント別の組み立て・トランザクション境界) → usecase(アプリケーションのユースケース) ← 今回テストする層 → repository IF / service IF(インターフェース) → infra 実装(DB・外部サービス) usecase 層は「1つの業務操作」を表す層です。リポジトリやドメインサービスをインターフェース越しに呼び、入力DTO(input)を受け取って、ドメインのルールに従い加工し、出力DTO(output)を返します。DBアクセスや外部通信の具体実装には依存しないのがポイントです。 ...

2026年7月10日 · 読了時間: 4分 · 高野智明
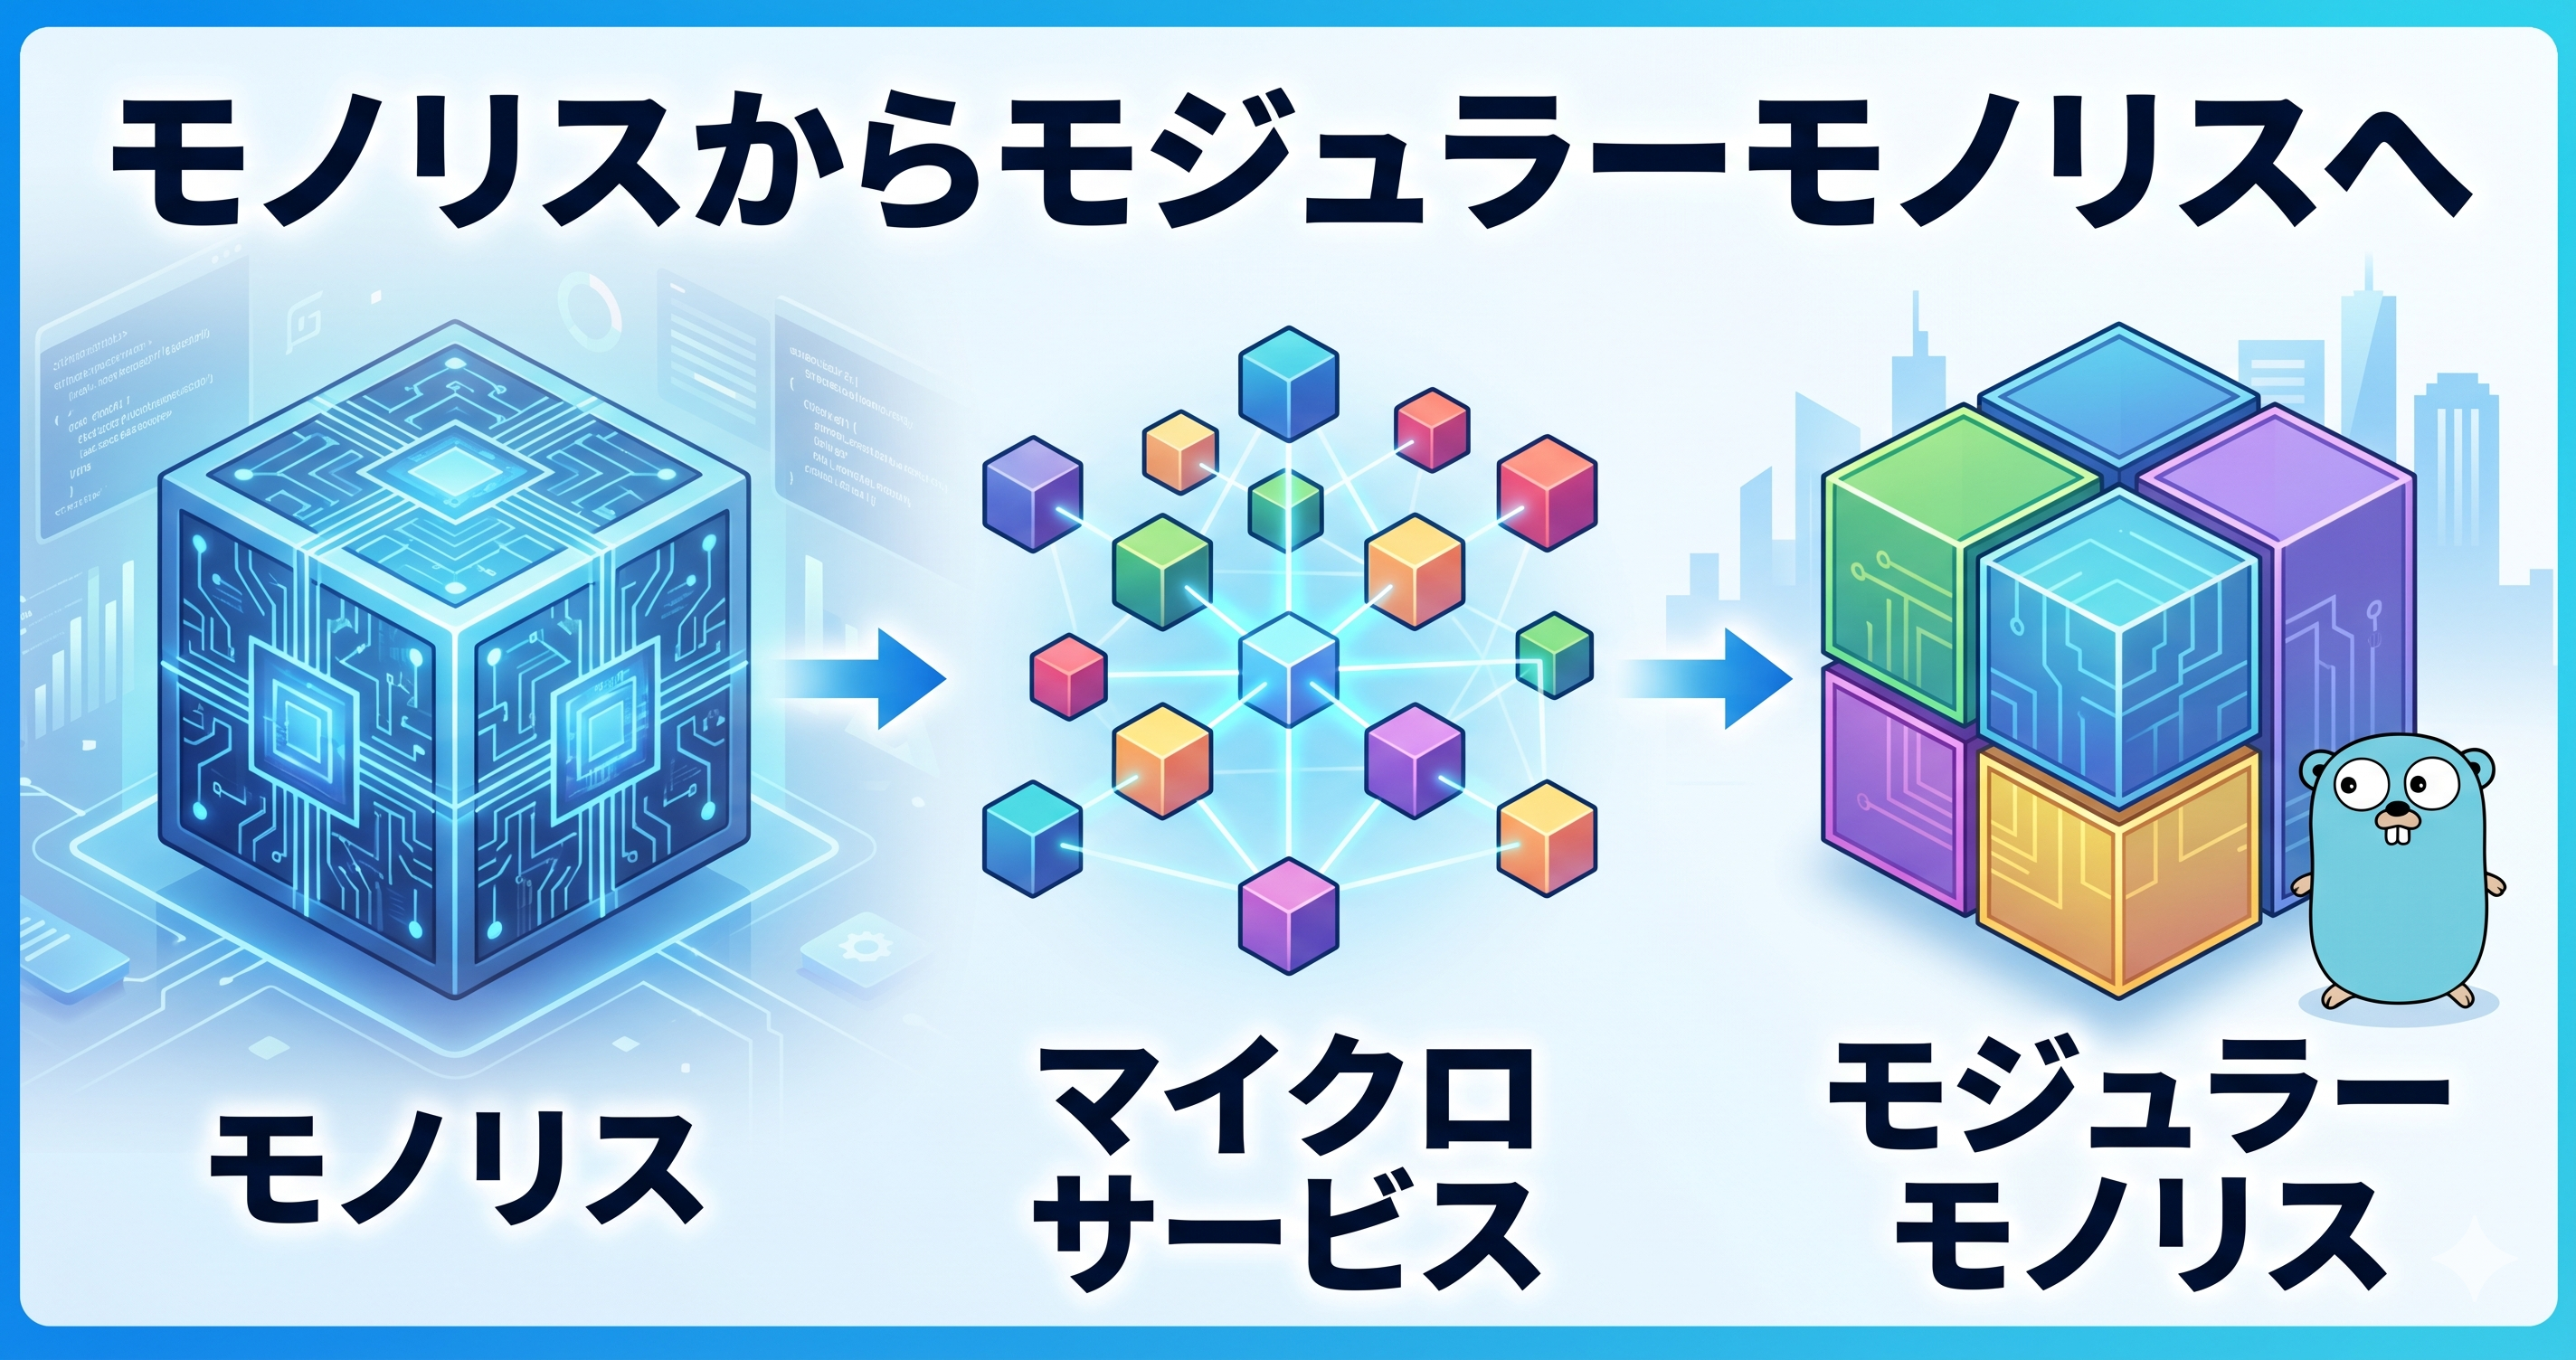
モノリスからマイクロサービス、モジュラーモノリスへの変遷を示す概念図

Goで実装するバックエンドのモジュラーモノリス構成

1. はじめに 私が担当しているサービスのバックエンドでは モジュラーモノリス を採用しています。本記事では、採用に至った判断軸、実際の構成、運用してみての所感を整理します。 以降の説明は、例として架空の オンラインレッスンプラットフォーム を題材に進めます。クライアントとしてはユーザー向けサイト・講師向けサイト・カスタマーサポート向けサイトを想定します。会員・講師・ポイント・レッスン予約・シフト・レビューといった共通のドメイン領域を、これら複数のクライアントが共有するサービスを思い浮かべてください。 クライアントごとに独立したバックエンドを並べる構成では、各バックエンドで類似の実装が増えがちです。ドメインの中核(会員管理、ポイント、受講履歴など)は本質的に1つしかないため、修正のたびに複数のリポジトリへ改修を加える必要があります。マイクロサービスとモジュラーモノリスの両方を比較した結果、最終的にモジュラーモノリスを採用する判断に至りました。 対象読者 複数のクライアント・チームから利用される中規模のバックエンドを設計し直そうとしている方 マイクロサービス化を検討しているが、本当に必要かを判断したい方 Goの go.work / go.mod でモジュール境界をどう引くかに興味がある方 TL;DR 対象は「ドメインは1つ、クライアントは複数」の構成。マイクロサービスのメリットより、単一トランザクションで処理できる利点のほうが大きかった 「業務モジュール群」と「クライアント別バックエンド」を分離した。業務モジュールは1つのリポジトリ(以降「コアモジュール群リポジトリ」と呼ぶ)の中で account / lesson / point / system などのサブモジュールに分けた。各バックエンドはそれらをGoの require 経由で取り込む モジュール単位で go.mod を切り、go.work で開発時だけ束ねる。本番ビルドではバージョン付きモジュールを取り込むので、依存方向と境界が物理的に強制される 将来マイクロサービス化したくなったら、モジュール単体を切り出しやすい構造にしておく、というのが導入時の合意事項 2. 当時の状況と課題 今回のアーキテクチャ刷新は、運用中のサービスを動かしながら行ったわけではなく、新規サービスの初期設計・実装を進めている途中で方針転換したものです。最初は従来どおり「クライアントごとに独立したバックエンドを並べる」構成で書き始めていました。しかし検討が深まるにつれて「このままリリースすると技術負債が制御できなくなる」と判断し、設計を全面的に見直しました。リリース後に修正するよりも、構築段階で構造を変えるほうが長期的に安いという見積もりです。 書き始めていた構成を具体的に示すと、次のとおりです。 ユーザー向けサイト用バックエンド・講師向けサイト用バックエンド・カスタマーサポート向けサイト用バックエンドがそれぞれ独立したリポジトリ 共通DBを直接参照する 共通処理は社内パッケージとして切り出していたが、ビジネスロジック層は各リポジトリ内に重複 この構成では、次のような状況が起きていました。 同じドメインルールが複数箇所に散らばる。「ポイント消費時の残高検証ロジック」のように、ユーザー向けサイトとカスタマーサポート向けサイトの双方から呼び出される処理が両リポジトリで似て非なる実装になりがち 修正の波及がレビューしきれない。テーブル定義を変えると、3〜4リポジトリでマイグレーションと修正をセットで進める必要がある トランザクション境界が曖昧。同じテーブルを別アプリから書き込むため、整合性は実質的にアプリ側の実装規律に依存 「サービスを分ける」方向に振るか、「中身を共通化する」方向に振るかをここで決める必要がありました。 3. マイクロサービスを比較対象として置いた 最初に検討したのはマイクロサービス化です。会員・講師・ポイント・レッスンをそれぞれ独立したサービスにして、gRPC経由で通信させる構成です。 マイクロサービスのメリット(私たちのケースで) 責任が分割されるので各サービスのソースコードはシンプルに保てる 将来、特定ドメインだけスケールアウトしたい場合に独立してスケーリングできる マイクロサービスのデメリット(私たちのケースで) 単一トランザクションで処理できない。ポイント残高・予約・受講履歴など同時に整合していないと厳しい業務が多く、課金系で部分失敗が起きた場合の運用設計をすべて自前で用意する必要がある ユーザー名やニックネームでの横断検索が一気に難しくなる。カスタマーサポートから「この名前で会員と講師を横断検索したい」というニーズは日常的にあり、サービス境界をまたいで実装するコストが大きい proto 定義に思いのほか時間がかかる。共通protoリポジトリにpush → 各サービスの go.mod を更新 → 反映、という流れがユースケース追加のたびに発生する そもそも私たちは複数チームで大規模な並列開発をするほどの規模ではない。マイクロサービス本来のメリットである「組織のスケール」が享受しにくい 「単純なモノリス」では戻したくない理由 一方で「全部1つの大きなアプリに戻す」という選択も適切ではありません。前述のとおり、アーキテクチャ刷新前の状態はまさに「重複のあるモノリス的運用」で、ドメインの境界が曖昧なまま規模だけ大きくなることの痛みは身をもって知っていたからです。 その中間として現実的なのは、1つのデプロイ単位の中で内部を明確に分割するモジュラーモノリスです。 4. モジュラーモノリスを選んだ判断軸 §2で挙げた課題と、本節で照らし合わせる観点は次のように対応します。 ...

2026年5月18日 · 読了時間: 5分 · 瀬戸敏文