古い管理画面が、ルールと自動検査のレールを通ってモダンな画面に生まれ変わる概念イラスト

2年目サーバーエンジニアがPHP製の社内管理画面をほぼ全自動でReactにリプレイスした

はじめに こんにちは。and factory でサーバーエンジニアをしている松ヶ浦です。 弊社では、自社アプリの広告関連の売上やKPIを管理する社内システムを内製しています。この管理画面はPHP(CodeIgniter 3)で作られていて、いわゆるレガシーな構成のまま運用されていました。PHPのバージョンは2022年11月にサポートが終わった7.4のままで、本来はバックエンドで守るべき権限の制御も画面側のコードで守っているような状態でした。それでも社内専用ということもあって、対応はずっと先送りにされていました。なお、今回のリプレイスでPHPの画面は停止して撤去し、権限の制御もバックエンド側で守るようにしています。 ただ、ここ最近でAIが十分に賢くなり、ハーネスエンジニアリングやソフトウェアファクトリーといった考え方も出てきました。そこで、今ならほぼ全自動でリプレイスできるのではないかと考え、React(Next.js)で作り直すことにしました。 僕はサーバーエンジニアで、フロントエンドを本格的に書いた経験はほとんどありません。そのため、実装はほぼすべてClaude Codeに任せると決めて、進め方の決まりと自動検査の仕組みを「ハーネス」として構築しました。 結果として、予定していた9画面の移植は、実装上のバグを出さずに終えられました。この記事では、作ったハーネスの構成と、実際に運用してみて見えてきた課題を紹介します。 プロジェクトの前提条件と技術スタック 対象は、エンドユーザーが触れない社内専用の管理画面です。売上の集計、KPIのダッシュボード、各種マスタ、管理ユーザーの管理などがあります。ほとんどがシンプルなCRUDで、バックエンドからフロントエンドまで、サーバーエンジニア1〜2名で開発、運用しています。 元のPHP版は、PHP 7.4とCodeIgniter 3.1でサーバー側がHTMLを組み立てる構成で、画面はjQuery、Bootstrap、DataTablesで作られていました。もともとPHPの画面がGoのバックエンドをgRPCで呼ぶ、PHPとGoのハイブリッド構成です。リプレイスに備えて、PHP側にあった集計などの処理はあらかじめGoに移植してありました。そのため、今回はREST APIを使うフロントエンドだけを、次の構成で作り直しています。 用途 採用技術 フレームワーク Next.js 16(App Router)、React 19、TypeScript データ取得 TanStack Query v5 フォーム周り react-hook-form、Zod UIスタイリング Tailwind CSS v4、shadcn/ui APIクライアント orval(OpenAPIからhooks・型・Zodスキーマを自動生成) テスト Vitest、Testing Library、Playwright、MSW CI GitHub Actions 実行環境 Node.js 24、pnpm なぜ「ハーネス」が必要だったのか チームにはフロントエンドの専任者がいないので、AIが生成したコードを人間が1行ずつ読んでレビューするのは難しいと考えました。かといって、チャット感覚でその都度AIに指示を出すと、出来上がりにブレが出そうです。既存のPHP版と挙動が変わったり、UIの崩れに気づけなかったりすることも心配でした。 そこで、人間がやることを次の3つに絞る仕組み(ハーネス)を作りました。 AIへ指示を出す(skillの実行) AIが作った実装計画のレビュー 最終的な画面の確認とマージ コードの実装、テストの追加、画面キャプチャの撮影までは、Claude Codeと自動検査(CI)に任せます。その代わり、任せた部分が勝手に崩れないよう、いくつかルールを決めました。 決めたことは、設計判断(ADR)や仕様書としてリポジトリに残し、口頭やチャットでの合意は仕様として扱いません。品質の合否は、コマンドで再現できる自動検査だけで判断し、手で埋めたチェックリストは根拠にしません。仕様も、実装しながら固めるのではなく、実装を始める前に画面仕様書で決めておきます。 さらに、Claude Code自身にも次のルールを守らせています。 実行していないテストを「合格」と書かない 失敗したテストをskipやリトライで無理やり通さない 承認された実装計画から勝手に外れない CIが落ちたときは専用のサブエージェントが直し、2往復しても直らなければ人間に戻す ハーネスの構成(3つのリポジトリとCI) ここで紹介するのは、運用しながら直したあとの形です。ハーネスは、役割ごとに3つのリポジトリに分けています。 1. リポジトリの役割分担 リポジトリ 役割・置いているもの docs 設計判断(ADR)、画面ごとの仕様、承認済みの実装計画、不変条件 skill Claude Codeを動かすためのskill(計画用skill、実装用skill) フロントエンド アプリケーションのコード、E2Eテスト、CIの定義 docs にある不変条件は、システムとして壊してはいけない性質をまとめたもので、全部で8件あります。たとえば「未ログインでは画面を見られない」「アクセス権のないデータは画面とCSVのどちらにも出さない」「自分自身は削除できず、権限の昇格もできない」といったものです。Claude Codeは、実装計画を立てる前に必ずこれを読み込みます。 ...
2026年11月18日 · 読了時間: 1分 · 松ヶ浦健
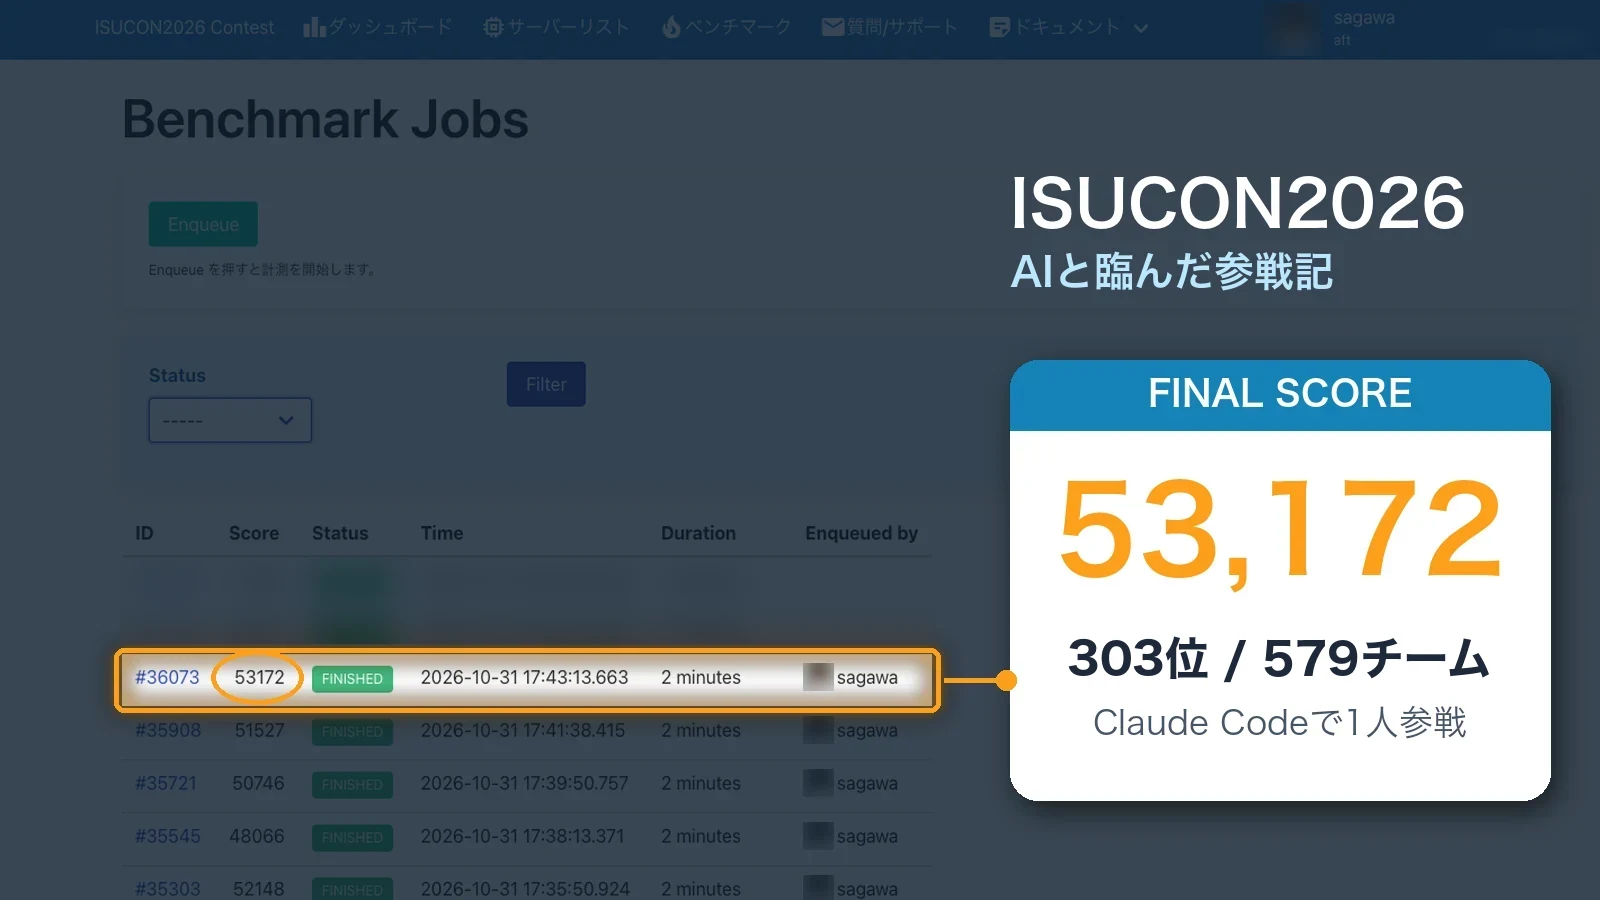
ISUCON2026ポータルのベンチマーク結果一覧のスクリーンショットで、最終スコア53,172点の行を強調し、303位/579チームと示したカバー画像

ISUCON2026に1人で参戦しました ── AIで準備は1時間、勝負は「AIに方向を考えさせる仕組み」へ

はじめに ISUCON2026に参加し、最終スコアは53,172点、順位は303位でした。参加は856チーム(負荷走行を実行したのは662チーム)で、失格にならず順位がついた579チーム(公式結果)のうち、ほぼ中央の順位です。 これまでは会社のメンバーとチームで出場していましたが、今回は1人での参戦です。今年は、一緒に出るメンバーの都合がつきませんでした。ただ、1人でもAIを使えば多少はできることがあるのではと考え、無理にメンバーを集めることはしませんでした。1人での参加は初めてでしたが、AIを活用したことで中央付近の順位に入れました。 今回はAIエージェントのClaude Code(モデルはClaude Opus 5.5)を全面的に使って臨みました。その結果、参加した感覚が今までとは大きく変わり、AIについて深く考えさせられる大会になりました。結論から言うと、次の2点です。 ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で、AIが終えられる。人間は「どう改善するか」に思考を集中できる 一方で、上位との差は「構成の方向」という全体設計の判断で開いた。AIの改善案は、すぐ手の届く箇所を優先する局所的なものに寄りがちで、AIに全体の方向を考えさせる問いかけや仕組みを用意するのが人間の役割になる この記事では、当日の流れとスコアの推移を紹介します。そのうえで、終了後に上位チームの参加記と比べて分かった「足りなかった部分」を、技術とAIの使い方の両面から整理します。最後に、その反省から導いた次回やること(ベンチマークをAIのループに入れる、構成案をAIに複数出させて午前中に方針を固める、など)をまとめます。 対象読者 ISUCONに参加したことがある、またはこれから参加したい方 AIを使ったパフォーマンスチューニングがどこまでできるのかを知りたい方 実際のプロダクトでのパフォーマンス改善にAIを活用したい方 前提となる環境 ISUCON2026の競技環境は、リージョンをまたいだ複数台構成でした。この記事に出てくるサーバーは次のとおりです。 サーバー 役割(最終構成) インスタンス asia1 アプリケーション(全リージョンの /api/ を集約) c5 asia2 DB(PostgreSQL) c5 europe / america nginx(/api/ を asia1 へ転送) c7i 使用した主な技術とバージョンは次のとおりです。nginxとOSのバージョンは、記録が残っていないため省略します。 種別 バージョン Go 1.26.5 Echo v5.3.1 pgx / sqlx v5.11.0 / v1.4.0 PostgreSQL 16 Claude Code 2.1系(当日の最新は2.1.316。モデルはClaude Opus 5.5) 1. 今までのISUCONと、今回のISUCON 1.1 今までの感覚 これまでのISUCONでは、序盤にとにかく時間を取られていました。 ドキュメントを読み込むのに時間がかかる セットアップやデプロイの仕組みづくりにも時間がかかる 簡単なボトルネックを取り終わった頃には、もう半分くらい時間が過ぎている 残り時間で何ができるか、という状態から本格的な改善が始まります。3人で取り組んでもやることが多く、手一杯でした。チームワークと、各自の総合的な技術力が勝敗を分ける競技だったと言えます。 1.2 今回の感覚 今回は、AIを活用して、ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で終えられました。 そのため、どうやって改善するかに思考を集中できました。さらに、AIの側からも多くの改善案が出てきます。自分の力だけでは届かない改善まで実現できてしまう感覚がありました。 今回のISUCONで大事だったのは、AIをうまく使いこなせることです。次の章では、具体的にどう進めたのかを時系列で紹介します。 2. 当日の流れ 2.1 最初の1時間で「速度改善だけに集中できる状態」を作る 最初に行ったのは、改善に集中するための土台づくりです。 ...

2026年11月17日 · 読了時間: 4分 · 佐川 豪
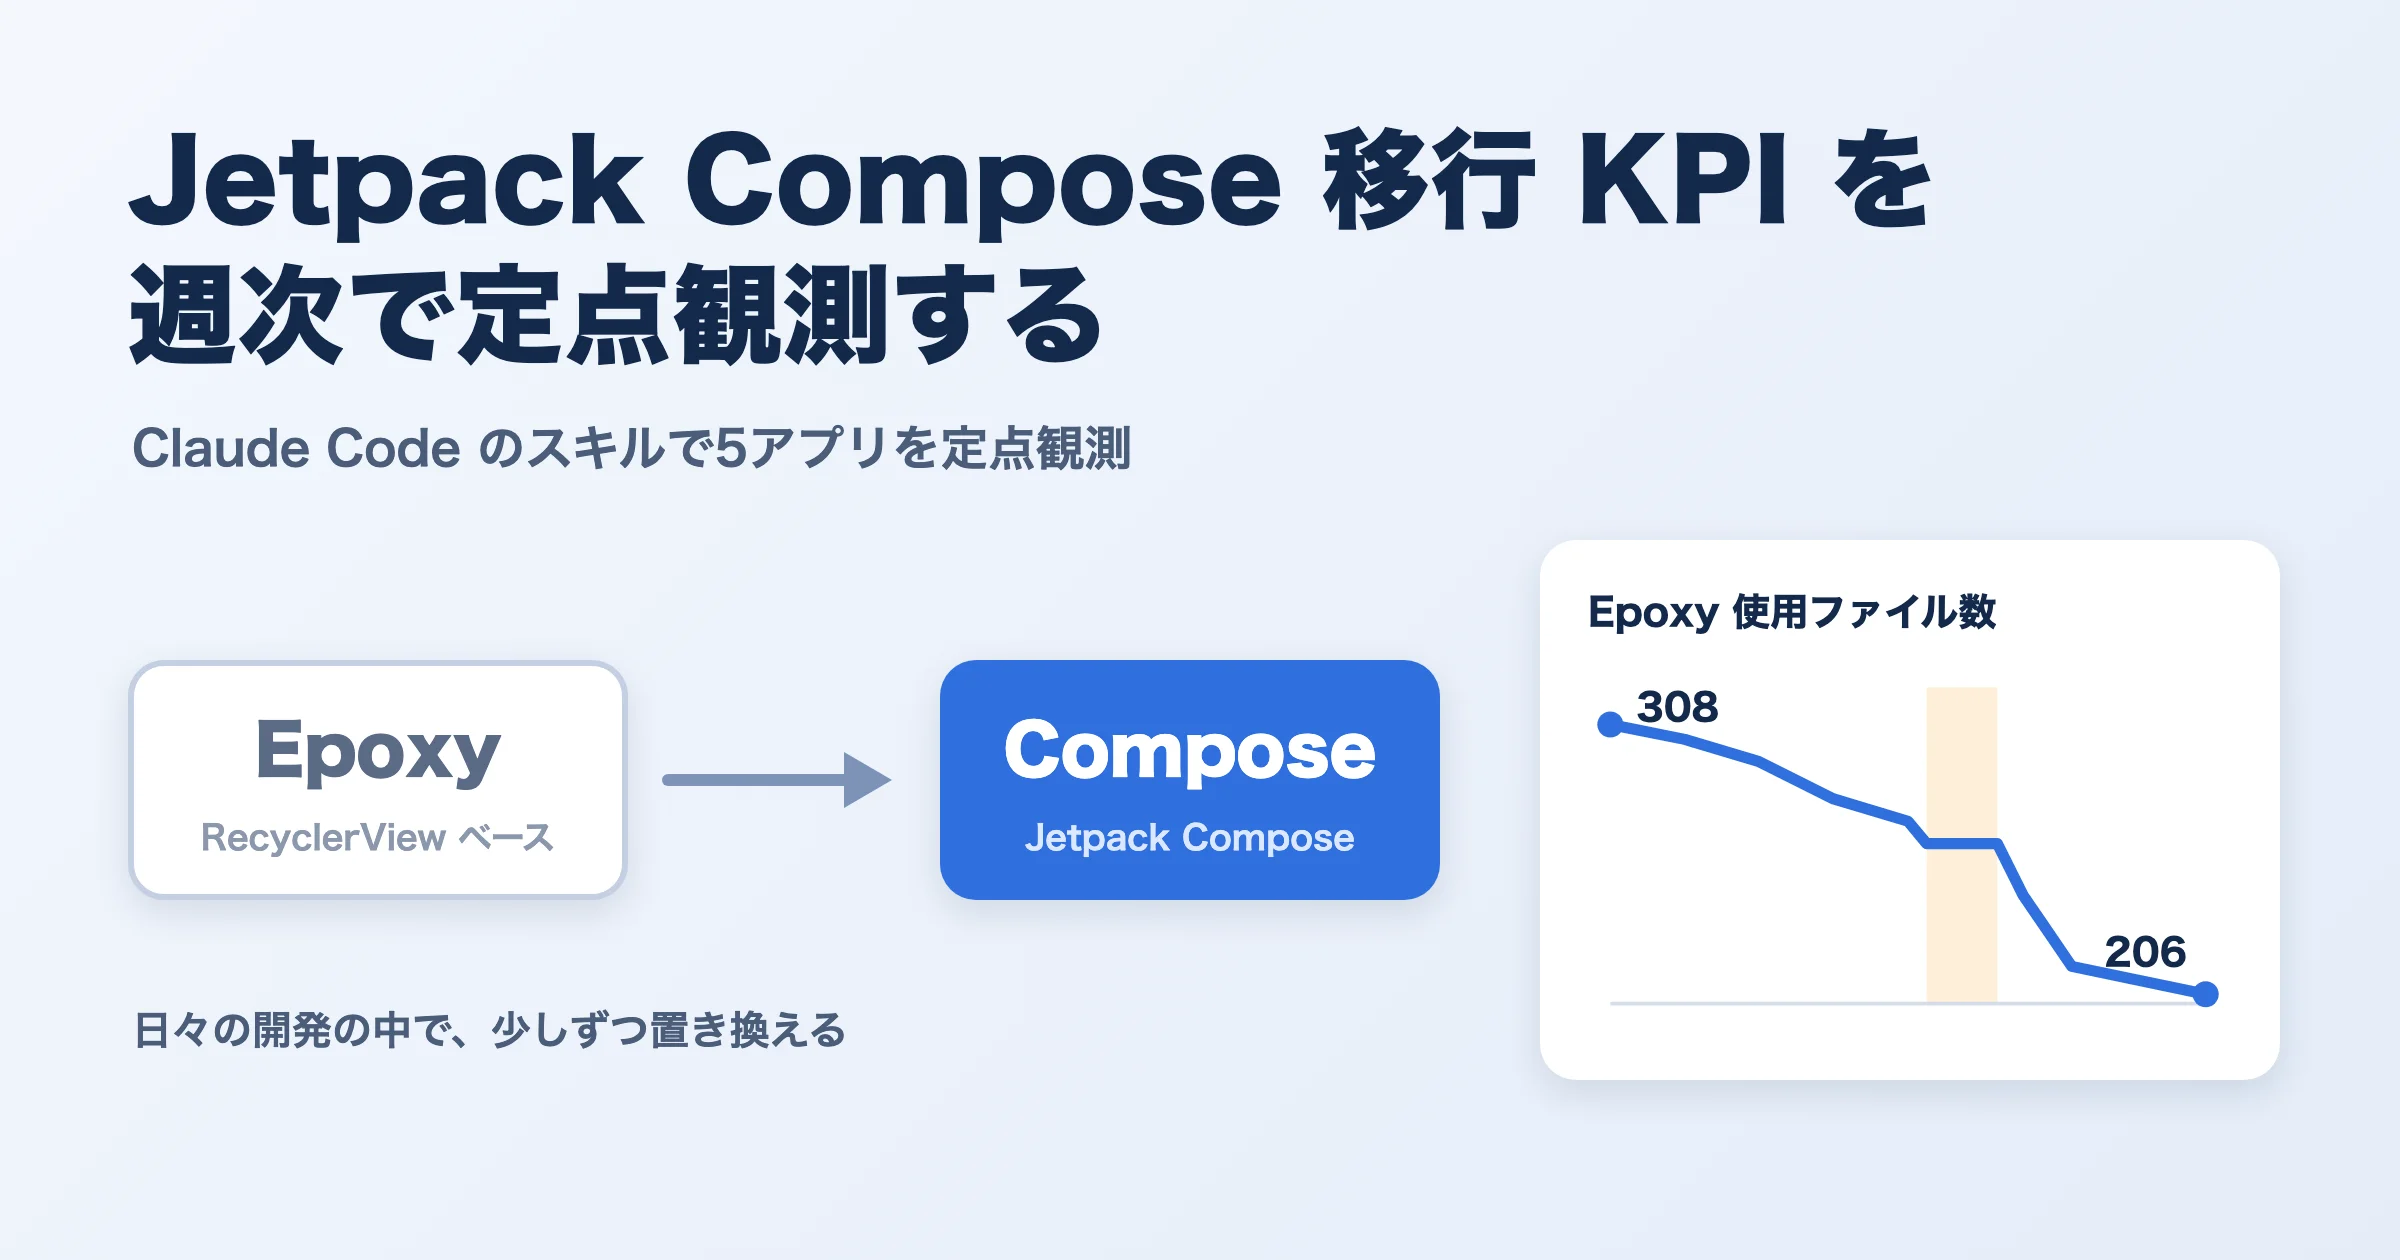
Epoxy で作られた画面を Jetpack Compose に置き換え、Epoxy 使用ファイル数の推移を週次で追うイメージ

Jetpack Compose 移行 KPI を週次で定点観測する仕組みの導入とふりかえり

はじめに and factory ではマンガアプリを複数開発しています。 Androidの既存アプリでは、Android ViewからJetpack Composeへの移行を進めています。 この記事ではその進捗計測の仕組みと、計測してからの推移を書きます。 移行の当面のゴールは、RecyclerViewベースのUIライブラリ Epoxy への依存をなくすことです。 Epoxyを使っているファイルは、5アプリ合計で3月末の308から11月初めの206まで減り、1アプリでは0になりました。 数年前から少しずつ置き換えてきたので、3月の時点でEpoxyのファイルはそれほど多くありませんでした。 EpoxyからJetpack Composeへの移行 Jetpack Composeが出てから比較的早い段階で積極的にComposeを使っていく方針にしました。 新しい画面はComposeで作成し、既存の画面は機能開発で触る際に置き換えています。 移行タスクはNotionで管理していましたが、いつまでに終えるかは決めていませんでした。 一覧画面やマンガビューワーなど既存画面の多くはEpoxyで作られているので、Compose移行の作業の中心はEpoxyで書かれた画面の書き直しです。 Compose移行のモチベーション Epoxyのバージョンはアプリによって3.xから5.xまでばらばらでした。 EpoxyがKSPに対応したのは5.0.0から、KSP2に対応したのは5.2.0からです(Epoxy の CHANGELOG)。 3.xや4.xのアプリでKSPに移るには、Epoxyのメジャーアップデートが必要です。 上げたあとも、KotlinやAGPを上げる際にEpoxyまわりの対応が必要になることがあります。 Epoxyを使い続ける限り、XMLレイアウトのメンテナンスも続きます。 こういった都合もあり2025年あたりから機能開発で触らない箇所も積極的にComposeへ置き換える方針を明確にしました。 実際、2026年8月にはアプリAでAGP 9.xとKSP2に対応するため、Epoxyを5.0.0から5.2.1に上げています。 KSP2との相性やコード生成の不具合を避けるための作業で、Epoxyのファイルは1つも減っていません。 進み具合を把握するため、2026年3月からは移行状況をほぼ毎週計測してAndroid定例で共有するようにしました。 計測の仕組み Claude Codeスキルによる計測 計測はClaude Codeのスキル /android-compose-kpi として作成し、各アプリのリポジトリに対して grep と find でファイル数を数えるようにしました。 数えるだけならシェルスクリプトでも足ります。 Claude Codeを使っているのは、数字が増減したときに、理由になったコミットをgitの履歴から調べてレポートに書くところまで任せられるからです。 SKILL.md に全体の流れを書いて、1アプリ分の計測手順は agents/kpi-measurer.md に分けています。 サブエージェントからの応答形式は KEY: 値 で固定して、5アプリ分の結果をMarkdownのレポートにまとめる処理を、ほぼ毎週実行しています(祝日や繁忙期は計測しない週もありました)。 指標は次の8つです。 実際のコマンドは、記事の最後の付録に載せています。 指標 数え方 Epoxy バージョン libs.versions.toml や build.gradle から検出 Epoxy 使用ファイル数 com.airbnb.epoxy を含む .kt EpoxyController 数 EpoxyController を含む .kt EpoxyModel 数 @EpoxyModelClass などを含む .kt EpoxyHolder 数 EpoxyHolder を含む .kt Compose ファイル数 @Composable を含む .kt(画面以外の部品やテストも含む) XML レイアウト数 res/layout*/ 配下の .xml Epoxy 依存モジュール数 epoxy を参照する Gradle ファイル ハマったところ build/ を除外し忘れていたり自動生成コードが入ってしまったりで、集計ごとに数が増減して最初は安定しませんでした。 1〜2週回すとミスにも気づけて、次の点に気をつけて計測するようにしました。 ...

2026年11月17日 · 読了時間: 2分 · 竹中 貴哉
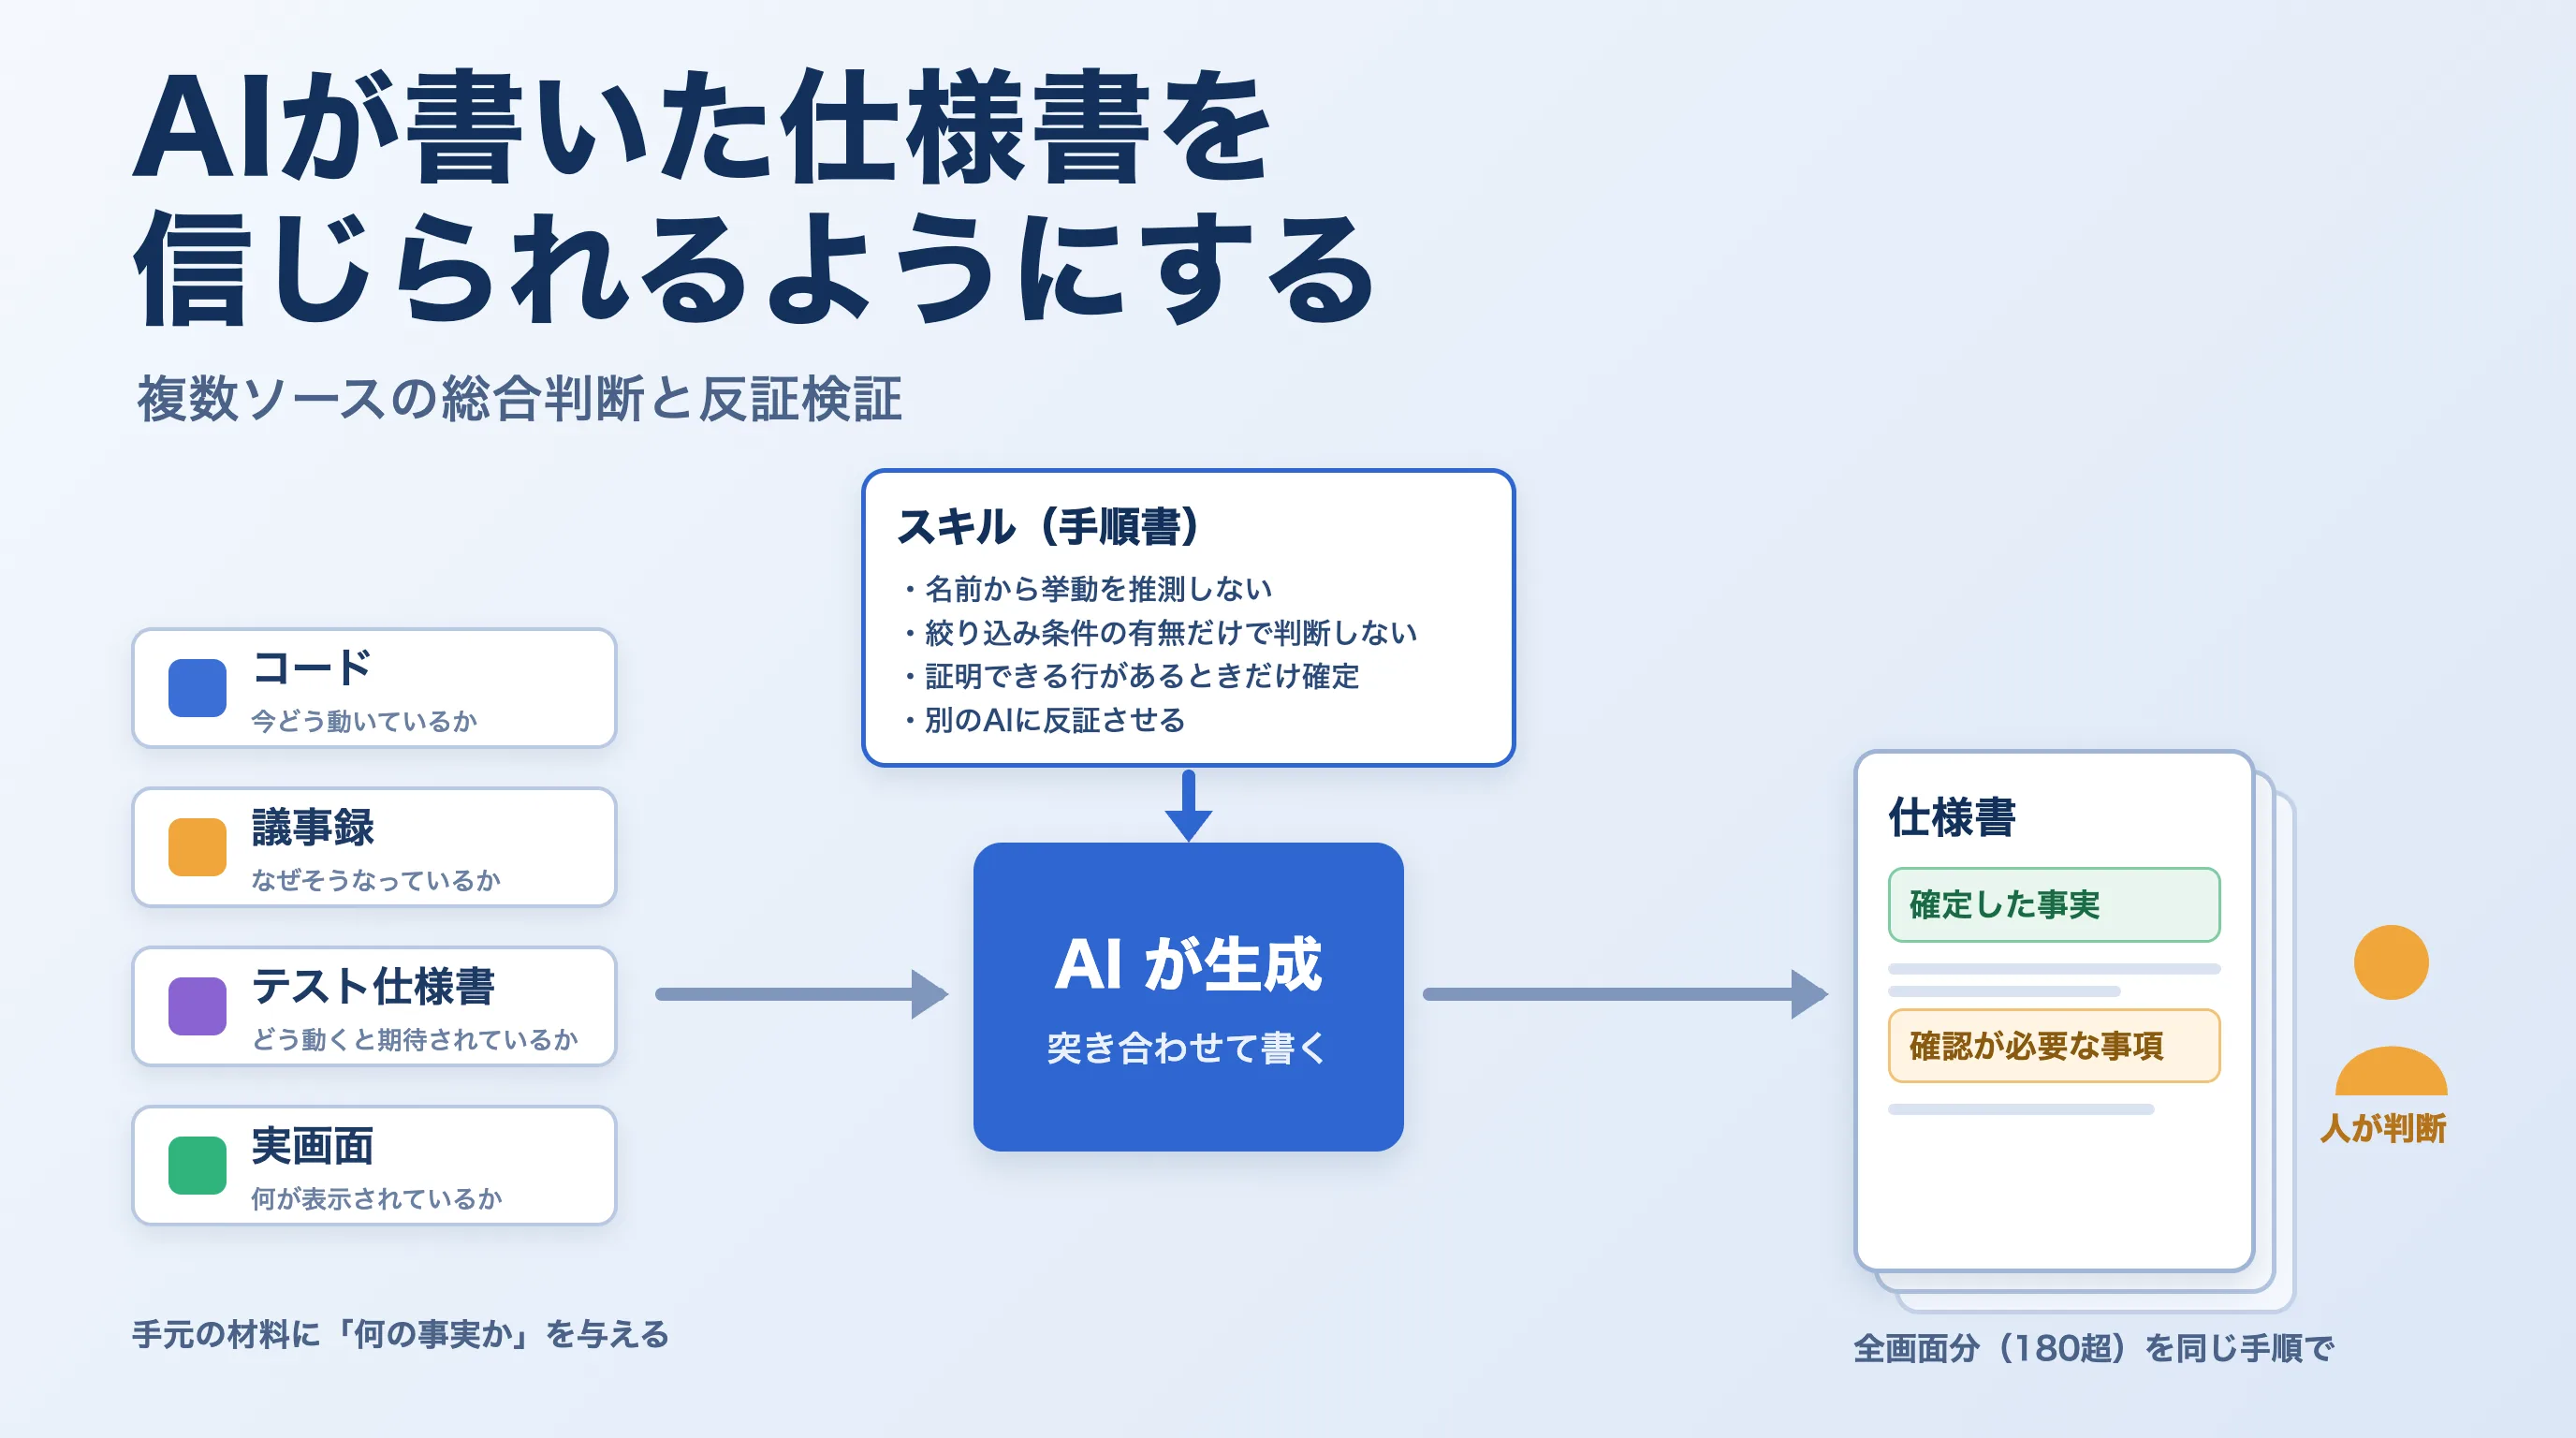
複数の材料をAIが突き合わせ、別のAIが反証してから仕様書に確定する流れのイメージ

AIが書いた仕様書を信じられるようにする ── 複数ソースの総合判断と反証検証

はじめに 私が担当するサービスには、画面ごとの仕様書がありませんでした。あるのは、QAのために書かれたテスト仕様書と、仕様を決めた会議の議事録、設計当時の資料だけです。設計資料はコードの変更に追いついていません。 この状態を、画面ごとに1枚、今どう動いていてなぜそうなっているかを書いた仕様書を全画面分そろえることで解消したいと考えました。画面は3つのサイトを合わせて180を超えます。人が手で書く時間はありません。そこでAIエージェントを書き手にしました。 AIは、もっともらしいが事実と違うことを平気で書きます。関数やテーブルの名前から挙動を推測し、確かめずに断定します。180を超える仕様書が速く出てきても、どれを信じてよいのか分からなければ、業務側に渡せません。 この記事は、その「信じてよいのか分からない」を減らすためにやったことをまとめたものです。結論から言うと、次の3つです。 コード・議事録・テスト仕様書・実画面という手元の材料に「何の事実か」という役割を与えて突き合わせ、食い違った事実と決まらないことは「確認が必要な事項」として人に渡す AIが間違える典型を名指しで禁止し、要になる主張は証明できるコード行があるときだけ確定させる 別のAIに反証させて根拠のない断定を撤回させ、この手順一式をスキルとして固定して全画面に回す 説明は最初から最後まで1つの例で通します。カスタマーサポート向けサイトの会員一覧に、退会した会員と削除された会員は表示されるのか。単純に見えますが、AIが最初に出した答えは間違っていました。 題材は、これまでの記事と同じ架空のオンラインレッスンプラットフォームです。会員向け・講師向け・カスタマーサポート向けの3つのサイトが、会員や講師といった共通のドメインを共有しています(構成はモジュラーモノリス構成の記事を参照してください)。バックエンドはGoで、ORMにGORMを使っています。AIエージェントはClaude Codeです。実際に起きた出来事を題材に置き換えて書いていますが、仕組みそのものは言語やツールに依存しません。 対象読者 Claude CodeなどのAIエージェントに定型作業を任せていて、成果物の質を担保したい方 仕様書が無い、または古いサービスを抱えていて、AIで整備できないかと考えている方 AIの出力に混ざる「もっともらしい誤り」を、実務でどう抑え込むかの具体例を知りたい方 この記事で得られること 全画面分の仕様書をAIに書かせるとき、作る文書と手元の材料をどう定義したか 材料に役割と優先順位を与え、食い違いを決める進め方 AIに推測で断定させないための具体ルールと、別のAIによる反証検証の仕組み 出力を業務の言葉に翻訳させることが、なぜ精度に効くのか 手順一式をスキルとして固定し、全画面を同じ品質で回す運用 動作確認環境 種別 バージョン Go 1.26.3 GORM v1.30 系 Claude Code 2.1 系 1. やりたかったこと ── 全画面分の仕様書を、人が確認できる形で 1.1 作る文書 まず、AIに何を作らせるのかを決めました。ここで言う仕様書は、画面1つにつき1枚の文書です。「この画面が今どう動いていて、なぜそうなっているか」を、業務側の人が読める言葉で書きます。画面の項目(表示する情報や操作のまとまり)ごとに「定義」「業務ルール」「なぜそうなっているか」を持ちます。 そして、仕様書の各項目に必ず「確認が必要な事項」の欄を置き、末尾に一覧として集約しました。AIが材料から確定できなかったこと、材料同士が食い違っていて人の判断が要ることを、ここに集めます。 この欄を最初から用意したのには理由があります。全画面分の仕様書をAIに書かせるとき、人がやるべき仕事は「全文を読んで正しいか確かめる」ことではありません。それでは人の負担がほとんど減りません。人がやる仕事は、AIが「決められなかった」と申告した箇所だけを判断することです。だから仕様書は、「確定した事実」と「確認が必要な事項」の2つに分かれていなければなりません。AIには「決められないことは推測で埋めず、この欄に回せ」と指示します。以降の章で「決める」「残す」と言うときは、この2つの欄のどちらに書くか、という話です。 1.2 全画面をどう回したか 画面は3サイトで180を超えます。進め方は次のとおりです。 各サイトの画面一覧を作り、画面名と画面のURLを列挙する 1画面ずつ、AIエージェントに仕様書を書かせる。手順はスキル(AIエージェント向けの手順書。8章)として固定する 出てきた仕様書の「確認が必要な事項」を人が見て、業務側に確認する 確認結果を仕様書に反映する 1画面あたりの人の作業を、最初の承認と「確認が必要な事項」の判断に絞れたので、全画面でも回りました。ただし、それは「確定した事実」の欄が本当に事実であってこそです。ここが崩れると、人は結局全文を疑って読むことになります。この記事の残りは、その欄を信じられるようにするための取り組みです。 2. 手元にある材料 仕様書は1つの材料からは作れません。手元にあった材料(記事タイトルで言う「ソース」)は次の4つで、どれも多くの会社にある種類のものです。 材料 何か 読者の会社での対応物 コード 実際に動いているプログラム リポジトリ 議事録 仕様を決めた会議のメモ 会議メモ、決定が残ったチャットのスレッド、チケットのコメント テスト仕様書 「この画面でこう操作するとこうなるはず」を書いた手順書 受け入れテスト手順書、QAのテストケース一覧 実画面 AIがブラウザ操作で検証環境を開いて読み取った画面 ステージング環境 名前が似ているので1つ注意があります。テスト仕様書は材料の1つで、仕様書はこれから作る文書です。この記事では両者を区別して使います。 ...

2026年9月28日 · 読了時間: 2分 · 高野智明
Figma Dev Mode MCPで画像書き出しを自動化してみた

Figma Dev Mode MCPで画像書き出しを自動化してみた ── 68点の一括取得とWebP変換で分かったこと

はじめに こんにちは。and factory フロントエンドエンジニアの坂内です。 施策バナーなどの画像をFigmaから書き出す作業が、地味に手間だと感じていました。1枚ずつ選択してエクスポートし、書き出したPNGを別のツールでWebPに変換して圧縮する。作業自体は難しくありませんが、工程が分断されているぶん、都度の切り替えコストがかかります。 直近の施策では15枚ほどを書き出しました。枚数だけ見れば多くありませんが、1枚ごとに書き出しと変換を往復すると、それなりの時間を取られます。 きっかけは、会社で契約しているツールをもっと使い倒せないか、コーディングまわりをもう少し楽にできないか、と考えたことでした。調べるうちにFigmaのDev Mode MCPサーバーに行き着き、Claude Codeとつないで検証しています。この記事はその記録です。 やってみると、事前の想像と違う結果がいくつも出てきました。想定していたより権限のハードルが低かった一方、単発なら手動のほうが速いという結果も出ています。「圧縮したのにファイルが大きくなる」という予想外の挙動もありました。 注意: 本記事に登場するFigmaのレイヤー名とファイル名のうち、施策名や機能名を含むものは仮名に置き換えています。スクリーンショットでも該当箇所を伏せています。数値はすべて実測値です。 結論 先に結果を3点にまとめます。 指定する範囲が速度をほぼ決める。ページ全体に近い範囲を渡すと68点を一括で取得できたが、時間がかかった 1枚だけなら手動のほうが速い。AIを挟む価値は書き出し単体ではなく、書き出しから変換までを1つの指示で通せる点にある WebP変換は画像の種類で品質を分ける必要がある。70ファイルで合計38.2%削減できた一方、4点は逆にサイズが増えた 検証環境 項目 内容 実施時期 2026年7月 OS macOS Figma デスクトップアプリ(Dev Mode MCPサーバーはデスクトップ版のみ対応) Figmaのプラン 有料プラン AIクライアント Claude Code 変換ツール sharp 0.35.3(npx 経由で実行。Node 20.9以上が必要) Node.js v20.9.0以上(sharp 0.35.3の要件) 対象 ある施策ページのデザイン(最終的に70ファイルを取得) その前に:URLを渡すだけでは足りなかった MCPの設定を始める前に、claude.aiにFigmaのデザインURLをそのまま渡して画像を取得できないか試しました。結果は Site blocked the request (bot detection) でブロックされ、ページ自体を読み取れません。Figmaは認証が必要なサービスなので、汎用のWeb閲覧機能では中身に到達できないためです。 画像を扱うには専用の接続が要ると分かったので、MCPの設定に進みます。 権限は思ったより障害にならなかった 次に気にしていたのが権限です。Figma MCPサーバーのガイドには、デスクトップ版サーバーの利用にDev/Fullシートを含む有料プランが必要と書かれています。この記述を読んで、管理者にシートのアップグレードを相談する必要があるかもしれない、と身構えていました。 ところが実際に画面を開いてみると、特別な手続きなしでMCPサーバーを有効化できました。管理者への確認は不要でした。 調べ直すと、別ページのRate limits & accessに補足がありました。View / Collabシートにも月6回までのツール呼び出し枠が用意されており、有料プランでもこの上限が適用されます。アクセスはプランとシート種別の両方で決まります。View / Collabシートはプランに関わらず月6回で頭打ちです。一方、Dev / Fullシートの上限はプランで変わります(Starter・Professionalは1日200回、Organizationは1日600回)。 つまり、Dev/Fullシートでなければ一切使えない、というわけではありません。回数は多くないものの、検証や小さく試す段階であれば足ります。 同じところで足踏みしている方もいそうなので書いておくと、権限の相談より先に、自分の環境で有効化できるかを試すほうが早いです。シート種別はチームや組織の管理画面から確認できます。ただ、まず動かしてみたほうが話の早い場面もあります。仮に権限が足りなかった場合も、デザイナーの環境で有効化してもらい、そこへ接続する方法が残っています。 ...

2026年7月30日 · 読了時間: 2分 · 坂内由梨
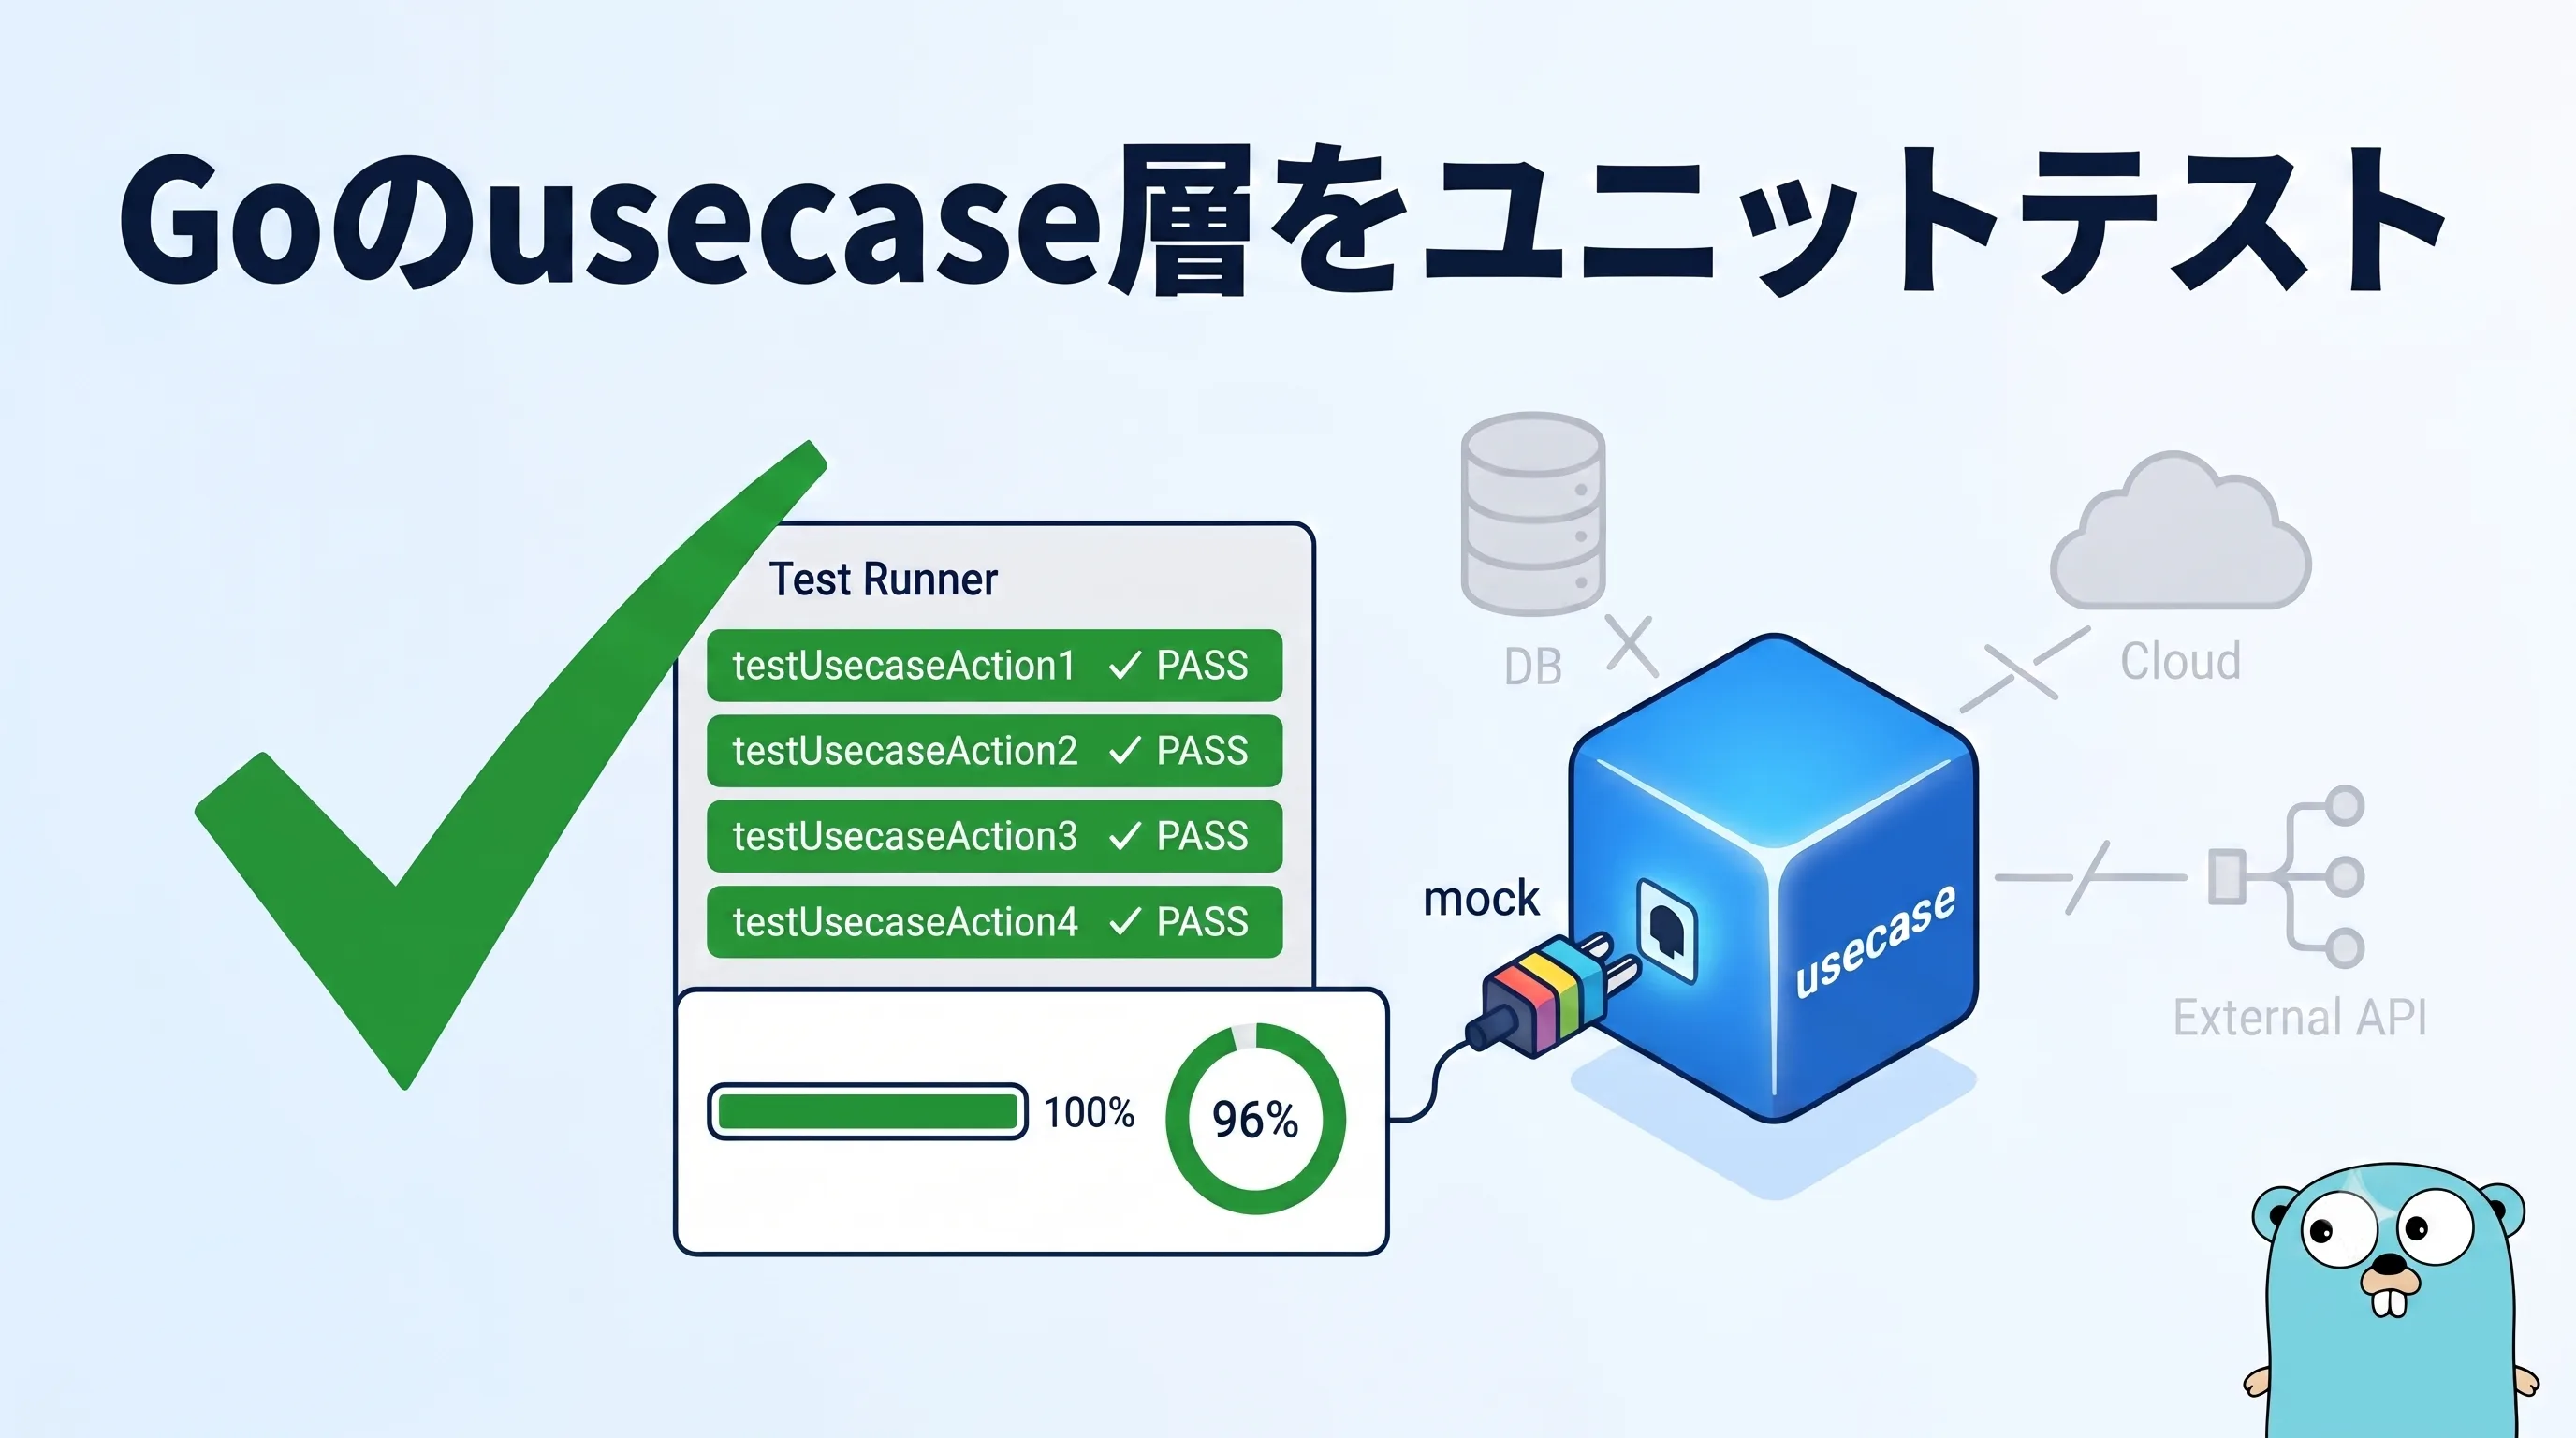
usecase層をmockで隔離してテストする構成のイメージ

Goのusecase層に一貫したユニットテストを根付かせる ── mockery v3 × testify × AAAとSkillによる量産設計

はじめに 私の担当するバックエンドでは、機能を積み増す一方で、ビジネスロジックの中心である usecase 層にユニットテストがほぼ無い状態を長らく抱えていました。しかも500を超えるusecaseに、複数人で少しずつテストを足していく必要があります。この規模で一番の敵は「人によってテストの書き方がバラバラになること」です。書き方が揃わないと、レビューは毎回スタイルの指摘に追われ、テスト自体の信頼性も安定しません。 結論から言うと、次のように解決しました。 mockery v3 + testify + AAAパターンでテストの「型」を固定する 書き方一式を Claude CodeのSkills(AIエージェント向けの手順書) として固定し、人が書いてもAIが書いても同じ形に揃える カバレッジをCIで自動計測し、テスト未整備の箇所を可視化する この記事は、その具体的な実装方法と、その形に決めるまでの設計判断をまとめたものです。 前提として、このバックエンドはClean Architecture + DDDをベースにした モジュラーモノリス構成のGoサービスです(構成そのものの詳しい話はこちらの記事をご確認ください)。 対象読者 GoでClean Architecture / DDD風のレイヤード構成を採っていて、アプリケーション層のテストをこれから増やしたい方 既存コードにテストを「後から・複数人で・大量に」足す局面にいる方 mockery v3 + testifyでのモックテストの具体的な書き方の落としどころを知りたい方 この記事で得られること usecase層を「何を境界として」テストするかの考え方(ブラックボックス検証) mockery / テストデータ / 引数検証を、なぜこの形にしたか AAAパターンでの具体的な書き方(引数マッチャーの読み書き分離・output比較・エラー検証) テストデータ生成ヘルパーの設計(newTest{Type} + Optionパターン) 書き方一式をSkillとして固定し、人もAIも同じ形に揃える運用 カバレッジをCIで自動可視化する仕組み 動作確認環境 種別 バージョン Go 1.26.3 mockery v3 系 testify v1 系(mock / assert) CI CircleCI 1. 前提: usecase 層とは何か(ざっくり) アーキテクチャの詳細は本筋ではないので前提だけ。レイヤーの依存方向はおおむね次のとおりです。 adapter(HTTP ハンドラ) → scenario(クライアント別の組み立て・トランザクション境界) → usecase(アプリケーションのユースケース) ← 今回テストする層 → repository IF / service IF(インターフェース) → infra 実装(DB・外部サービス) usecase 層は「1つの業務操作」を表す層です。リポジトリやドメインサービスをインターフェース越しに呼び、入力DTO(input)を受け取って、ドメインのルールに従い加工し、出力DTO(output)を返します。DBアクセスや外部通信の具体実装には依存しないのがポイントです。 ...

2026年7月10日 · 読了時間: 4分 · 高野智明
キーボードから一歩引き、宙に浮かぶコードやUIパネルを手で指揮するエンジニアの概念イラスト

コードを書かない新卒2年目の開発フロー 〜手書き世代が「判断と段取り」に全振りするまで〜

はじめに こんにちは。and factory で新卒2年目のサーバーサイドエンジニアをしている松ヶ浦です。 新卒2年目ですが、いまはもう、自分でコードをほとんど書いていません。エディタも「書く道具」というより「読む道具」になりました。 ただ、最初からそうだったわけではありません。大学1年の頃は、VS Codeで普通に手書きでコードを書いていました。 きっかけは大学2年で触れたGitHub Copilotでした。そこからAIに任せる比重は増え続け、4年の卒業研究では、VS Codeの拡張機能をほとんどvibe codingで作りました。入社後もこの流れは止まらず、Claude Codeを使うようになった頃には、自分でエディタにコードを打ち込むことはほとんどなくなっていました。 手書きでまともなプロダクトを作った経験はないので、「コーディング力がついた」という実感はもともとありません。 この記事で言いたいことは、2つです。 新卒の仕事は、「コードを書くこと」から「判断と段取り」に移った。 そのうえで厄介なのは、AIが、自分の理解できていないことまで隠してしまうこと。だから僕は、実装に入る前の見積もりで理解を詰め切ることに時間を使っている。 以下では、1つのタスクを概念からPRまでどう進めているかを、実際の流れに沿って書きます。まずは全体像です。各ステップで「人(僕)が握る」か「AIに逃がす」かも併記しました。 flowchart TB A["① タスク受領 〔人〕<br/>何をする機能かを言語化し<br/>設計の方向性を固める"] B["② 見積もり 〔人主体 + AI〕<br/>実装より先に理解を詰め切る<br/>Devin = 一次調査 / Claude Code = 厳密調査"] C["③ 実装 〔AI主体〕<br/>Claude Code が実装<br/>Plan は人が確認"] D["④ PR前確認 〔人〕<br/>コードを読んで検証する"] E["⑤ 動作確認 〔AI + 人〕<br/>自作 skill で実行し手でも触る"] F["⑥ PR提出 〔AI〕<br/>push 〜 PR作成 / Draft は人が Open"] A --> B --> C --> D --> E --> F この図のとおり、コードを書く部分はAIに任せ、僕は「理解」「確認」「判断」に回ります。それでは、各ステップを順に見ていきます。 ...

2026年6月22日 · 読了時間: 1分 · 松ヶ浦健
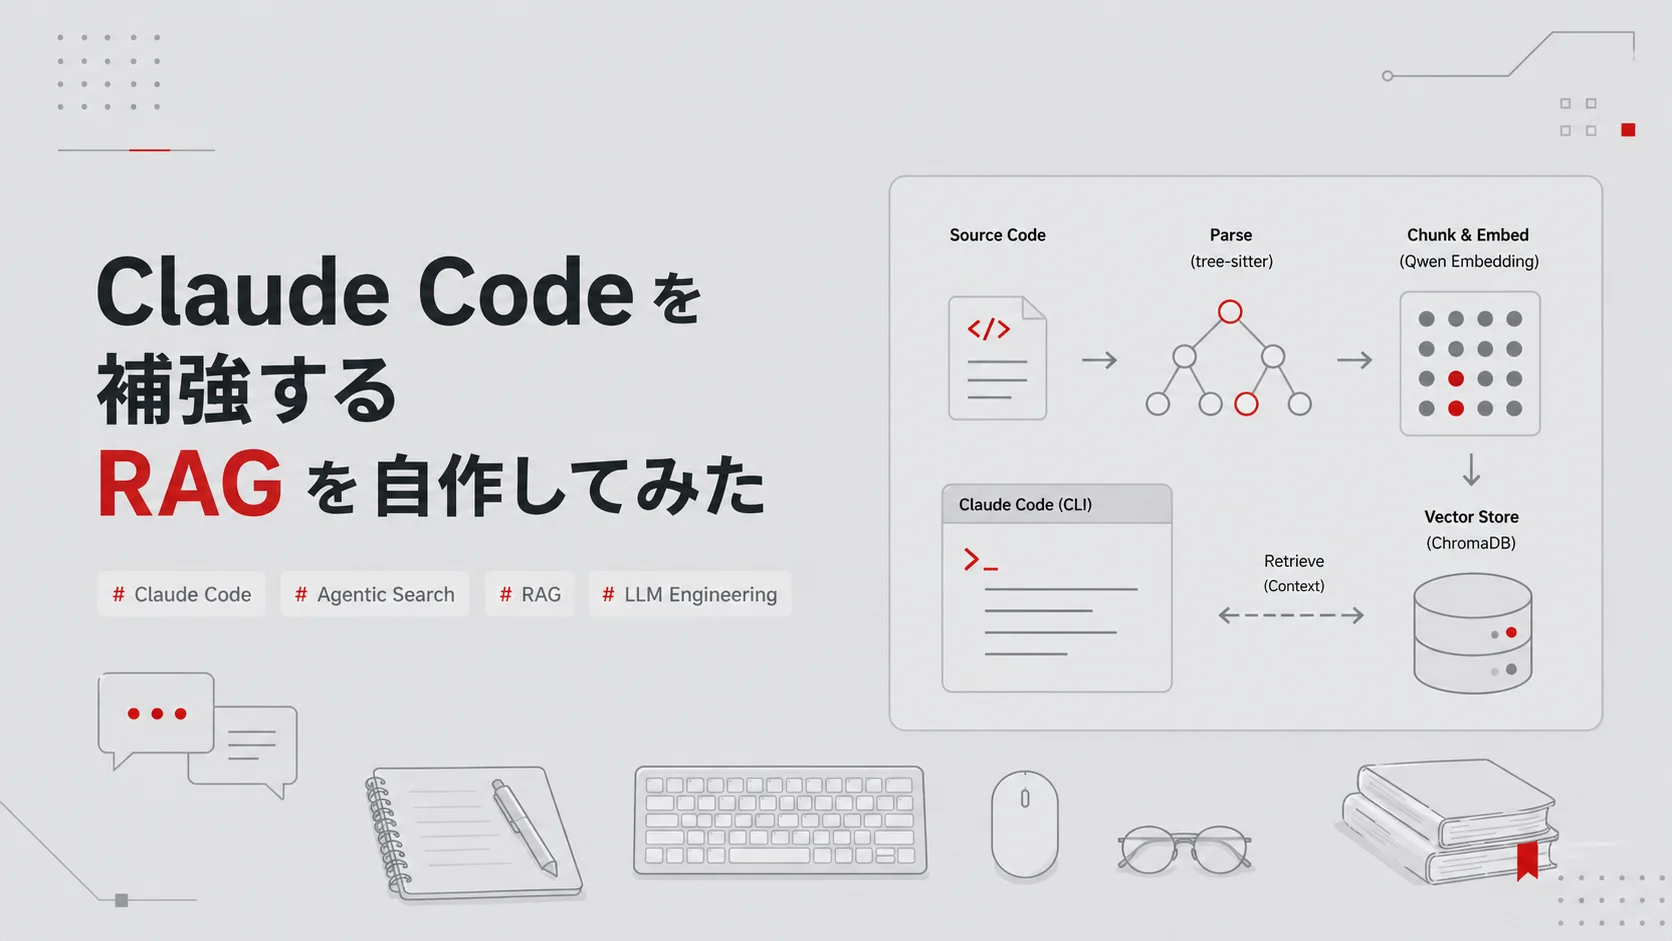
tree-sitter・Qwen Embedding・ChromaDB で組んだコード RAG CLI の構成イメージ

Claude Code を補強する RAG を自作してみた

1. はじめに こんにちは。and factory バックエンドエンジニアの木梨です。 Claude Codeを大規模コードベースで使っていると、「この機能はどこで実装されているか」のような広い問いで Grep や Explore が何度も走り、待ち時間が長くなりがちです。私が触っているGo / PHP / JSが混在する大規模モノレポでも、広い問いで数分待たされるのが日常的に発生していました。 改善策を探していた背景には2つの体験があります。1つは、社内にDevinが導入されたときにDeepWikiでコードベースに広い問いを投げた際の回答速度の速さです。一次情報は見つけられませんでしたが、応答の仕方からして内部でRAGを使っているのではと推測しています。もう1つは、Cursorのブログで報告されているセマンティック検索の導入効果です。どちらも「セマンティック検索を前段に置けば広い問いが軽くなる」という方向を示しています。同じ発想で最小構成のRAGをClaude Codeの前段に置いてみたのが本記事で紹介する構成です。 本記事では、tree-sitter・Qwen Embedding・ChromaDB で組んだ最小構成の RAG CLI を Claude Code から呼ぶまでを手順として共有します。約220行のPythonで動きます。既存のRAGライブラリを使う選択肢もありました。それでも今回自作の形にしたのは、Claude Code用にCLIとして統一したかった点と、中身が見える最小構成のほうが細かい調整をしやすい点の2つが理由です。 対象読者は Claude Code を日常的に使っており、RAG の基本概念(埋め込みベクトル、近傍検索)は既知の方を想定しています。 TL;DR 構成: tree-sitter + Qwen3 Embedding + ChromaDB + Python CLI。約220行 使い方: Claude Codeから検索CLI(例: myrag search)を呼び、候補を Read / Grep で裏取り 効果: 広い問いで待ち時間が体感で明確に短縮された。参考計測では中央値でRAG前段75秒 / Explore very thorough 132秒 / Explore medium 172秒。実行時間の安定性でもRAGが優位。詳細は6章「実際の効果」参照 注意: チャンク化したコードを外部APIへ送る構成。業務利用前に法務・セキュリティ確認が必要。詳細は事前に確認したいことを参照 事前に確認したいこと チャンク化したコードはAlibaba Cloud(DashScope)に送信されます。業務リポジトリで適用する場合は、先に社内の法務・セキュリティ窓口でコード外部送信ポリシーを確認してください。以下は最低限のチェックポイントです。 検証時は匿名化済みコードのみを使う APIキー、秘密鍵、認証トークン、個人情報、契約情報を含むファイルは投入しない .env や秘密鍵は EXCLUDE_PATTERNS(後述)に含まれているので、社内固有の機密ファイルがあれば同じ要領でパターンを足す 機密性が高くそもそも外部送信を避けたい場合は、embedder.py を sentence-transformers 等のローカル埋め込みに差し替えれば同じ構成で動きます。 ...

2026年4月23日 · 読了時間: 14分 · 木梨太一朗
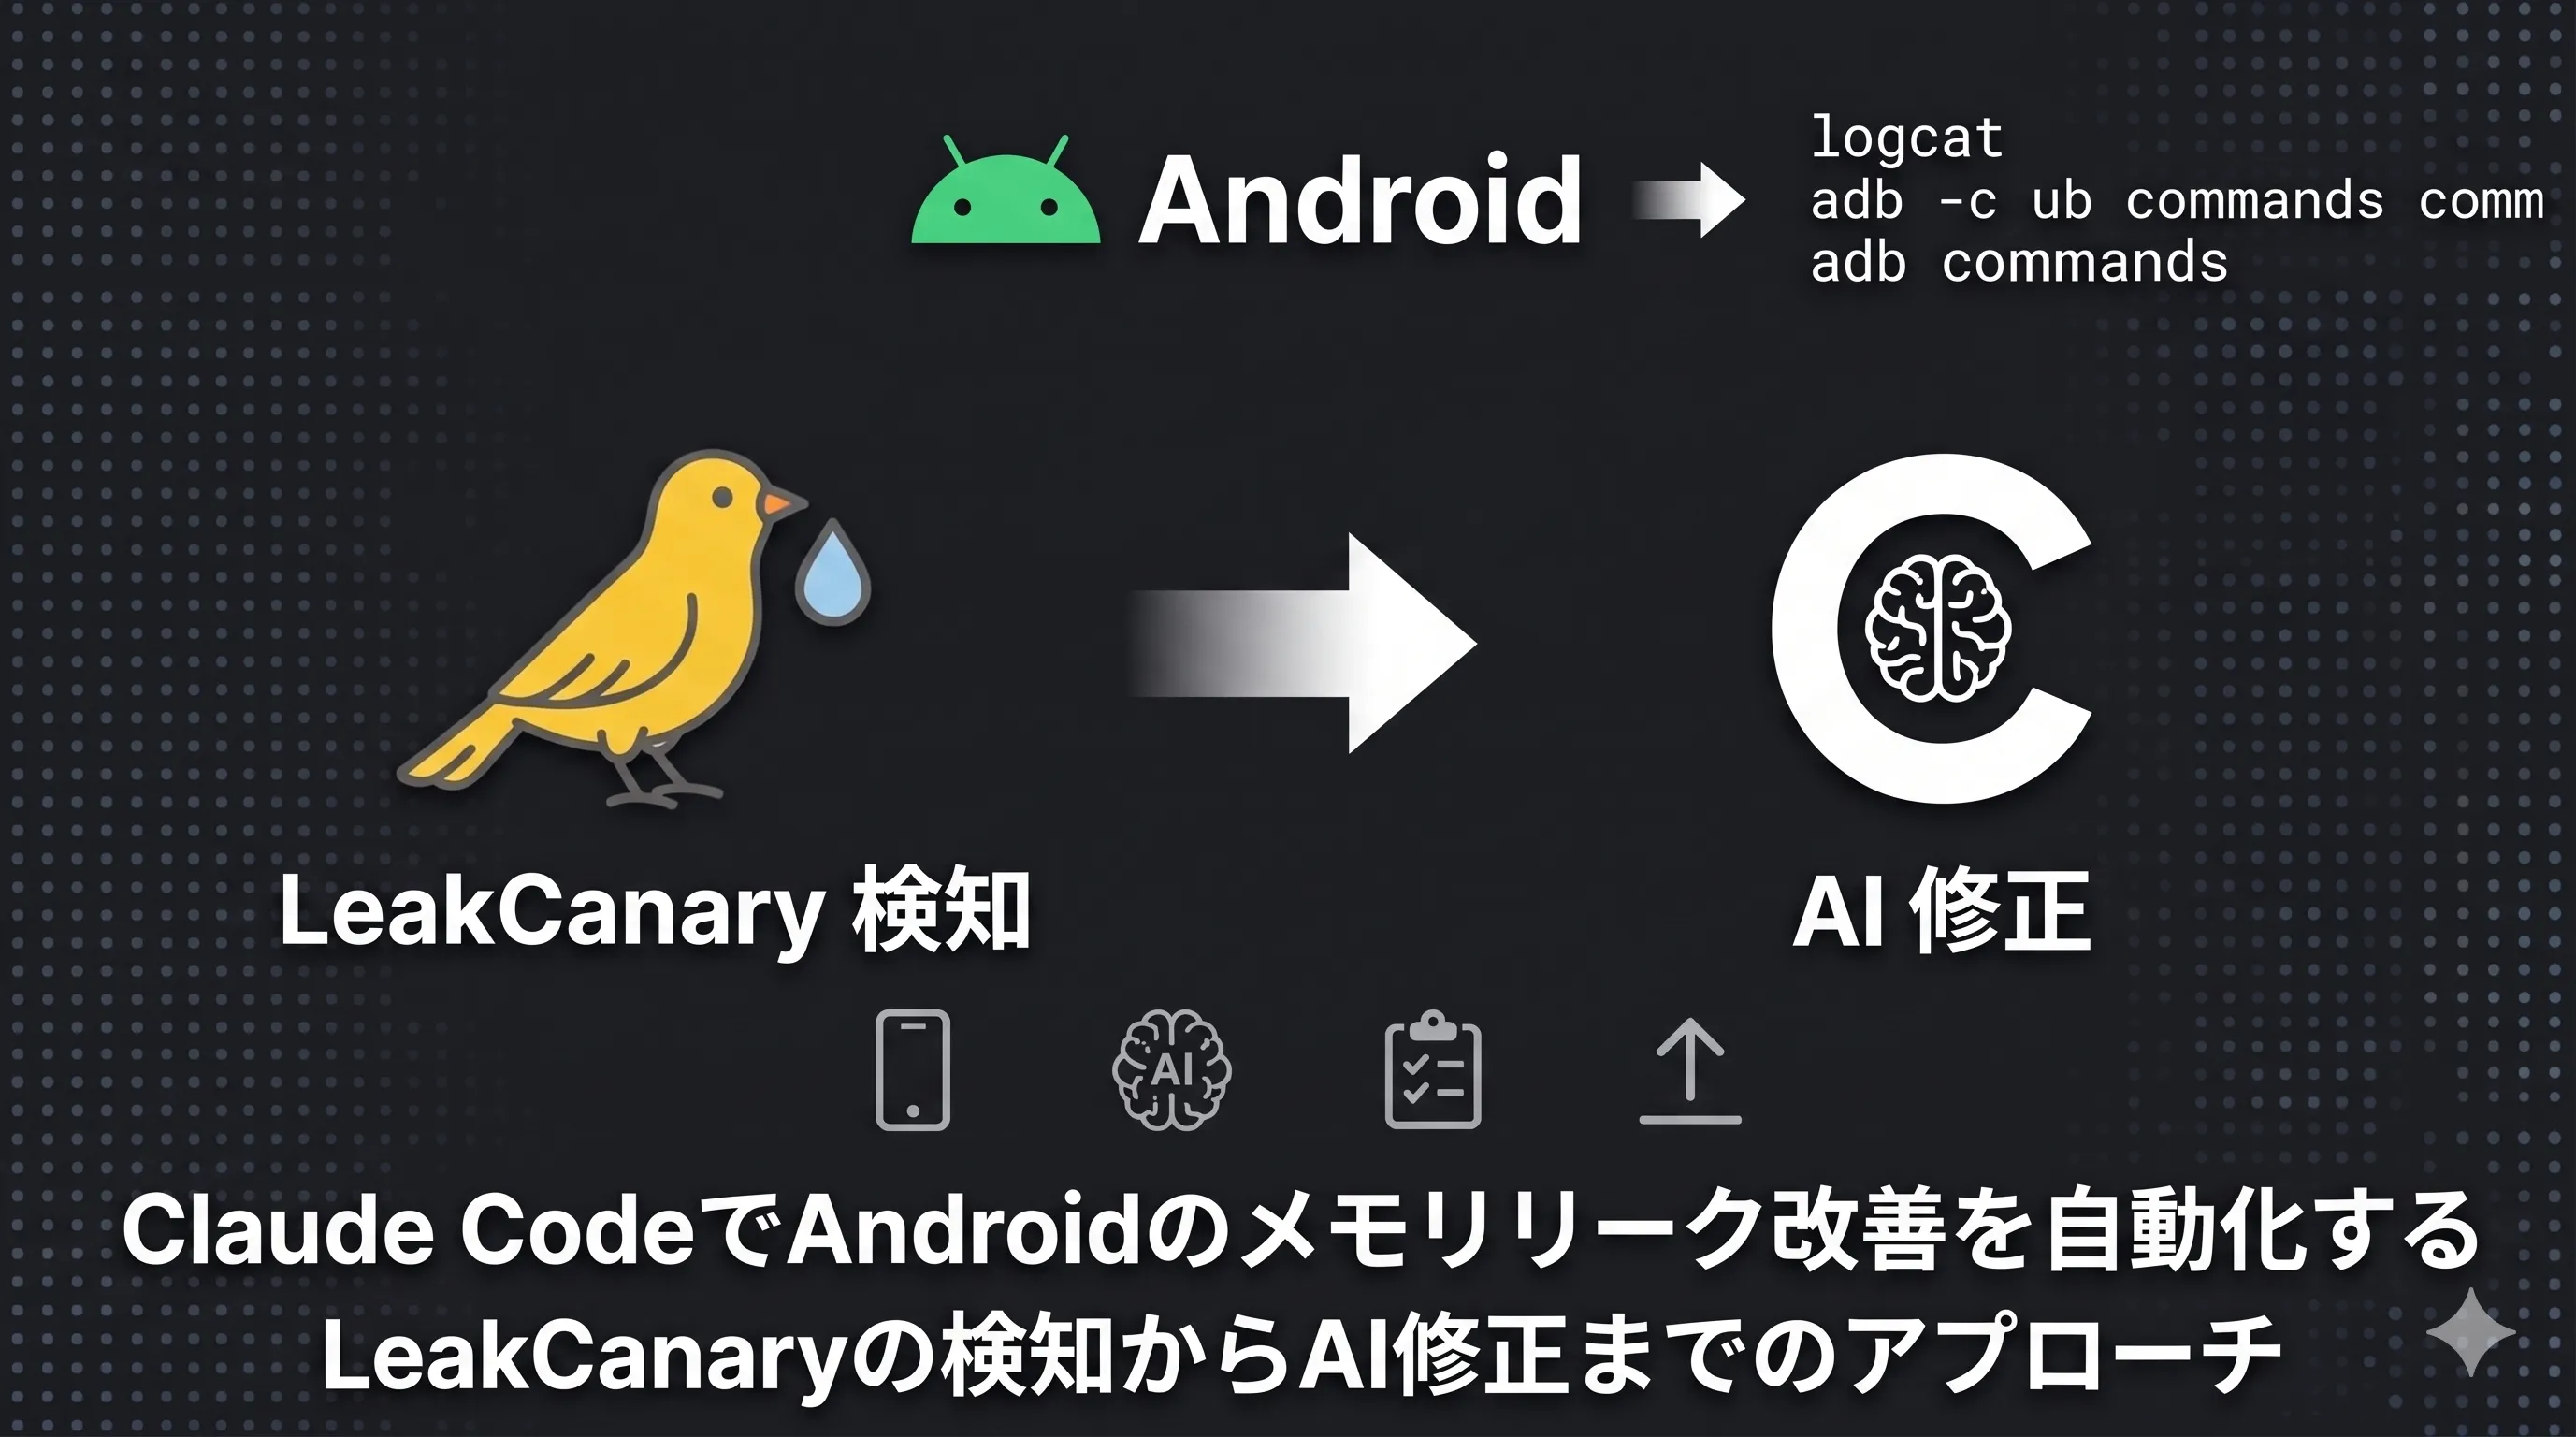
LeakCanaryのリークトレースとClaude Codeの連携を示すイメージ

Claude CodeでAndroidのメモリリーク改善を自動化する ── LeakCanaryの検知からAI修正までのアプローチ

はじめに こんにちは。and factory Androidエンジニアの鬼倉です。 今回は、私が携わるAndroidプロジェクトでClaude Codeを活用し、ANR改善に取り組んだアプローチを紹介します。ANRの原因はさまざまですが、本記事ではメモリリークを原因とするANRに焦点を当てます。 Android開発者にとって、メモリリーク対応のためにLeakCanaryを導入したはいいものの、結局修正できず通知が出続けているという方も多いのではないでしょうか? そこで今回私のプロジェクトでは、LeakCanaryによる検知に加えてClaude CodeのSkillsを活用した自動修正の仕組みを構築しましたので紹介します。 ANRとは? ANR(Application Not Responding)とは、アプリが指定時間内に操作を応答できなかった場合に発生するシステムエラーです。代表的には、UIスレッドが入力イベントに対して5秒以内に応答できない場合などでトリガーされます(BroadcastReceiverやServiceでも発生)。デッドロック、I/O処理のブロック、高負荷処理などさまざまな原因で発生します。Crashと同様にユーザー体験を大きく損なう問題ですが、Crashほど原因が明確でなく再現も難しいため軽視されがちです。ANR率はFirebase CrashlyticsやGoogle Play Consoleで確認できます。 本記事の環境 技術 バージョン Kotlin 2.3.20 AGP(Android Gradle Plugin) 8.9.3 LeakCanary 2.14 ANR改善が進まなかった背景 まずはそもそもメモリリークによるANRの修正改善がなぜ進んでいなかったのかを整理します。 FirebaseのANRレポートだけでは原因を深掘りしにくい Crashの場合、Firebase Crashlyticsに発生元のExceptionが記録されるため、その箇所が直接的な修正対象になります。一方、メモリリーク由来のANRは事情が異なります。複数箇所のメモリリークが徐々に蓄積し、最終的にANRとして発生します。そのため、Firebase上のレポートから直接的な原因箇所を特定することが困難です。 さらに、メモリリークの蓄積は端末のメモリ状況やユーザーの操作パターンに依存するため、開発環境での再現も難しいという問題があります。 ANR改善のためのLeakCanary導入と修正対応の難しさ ANRの発生件数を改善するため、メモリリーク検知の定番ライブラリであるLeakCanaryを導入しました。LeakCanaryを導入すると、開発中の手元の端末上でメモリリークの発生をリアルタイムに把握できます。 しかし、検知できることと修正できることは別の問題です。LeakCanaryはメモリリークの発生タイミングやある程度の情報を提供しますが、明確なコード上の原因までは教えてくれません。開発者自身が情報をもとに原因となるコードを探し出し、修正する必要があります。 さらに厄介なのは、メモリリークの原因となるコードは一見すると問題がないように見える点です。修正にはAndroid開発やKotlinに関する深い知識が求められ、1件あたりの対応に時間を要します。結果として、他の機能開発やCrash対応に比べて優先度が下がり、改善が後回しになりがちな状況が続いていました。 Claude Codeを活用したメモリリーク改善アプローチ 以上の理由により、LeakCanaryやFirebaseのANRログだけでは自力での修正は困難でした。それに対してどのようにAIを活用して修正をしていくのでしょうか? 最もシンプルなアプローチとしては、LeakCanaryが通知を出したら内容をClaude Codeにコピーペーストして修正を依頼することです。この方法でももちろん対応できます。 しかし、Logcatを含めた前後情報があればより精度が高まりますし、コピーペーストという作業をなるべく減らし即座に修正を依頼する環境を構築しなければ、再び後回しになりかねません。 今回私たちが構築したのは、LeakCanaryが通知を出した瞬間にClaude Codeへ/investigate-leakと依頼するだけで完結する方法です。AIが自ら端末のLogcatを確認し、ログ情報からメモリリークの修正を提案します。 LeakCanaryのリークトレースをClaude Codeから取得可能にする なお、本記事のアプローチではLogcatの内容をAIに読み取らせるため、ユーザーの個人情報やAPIキーといった機密情報がLogに出力されていないことが前提となります。 LeakCanaryはメモリリークを検知すると端末上に通知を表示します。しかし、デフォルトではヒープダンプの解析結果がlogcatに出力されません。Claude Codeがリークトレースを自律的に取得できるよう、解析結果をlogcatに出力する仕組みを追加しました。 具体的には、LeakCanaryのonHeapAnalyzedListenerをカスタマイズしています。 1 2 3 4 5 6 7 8 9 10 11 12 13 import leakcanary.LeakCanary import leakcanary.OnHeapAnalyzedListener import timber.log.Timber val defaultListener = LeakCanary.config.onHeapAnalyzedListener LeakCanary.config = LeakCanary.config.copy( onHeapAnalyzedListener = OnHeapAnalyzedListener { heapAnalysis -> defaultListener.onHeapAnalyzed(heapAnalysis) // ここでLogに出力(ここではTimberを利用しています) Timber.tag("LeakCanary").d(heapAnalysis.toString()) } ) この設定により、Claude Codeは以下のadbコマンドでリークトレース全文を取得できます。 ...

2026年4月15日 · 読了時間: 2分 · 鬼倉泰裕