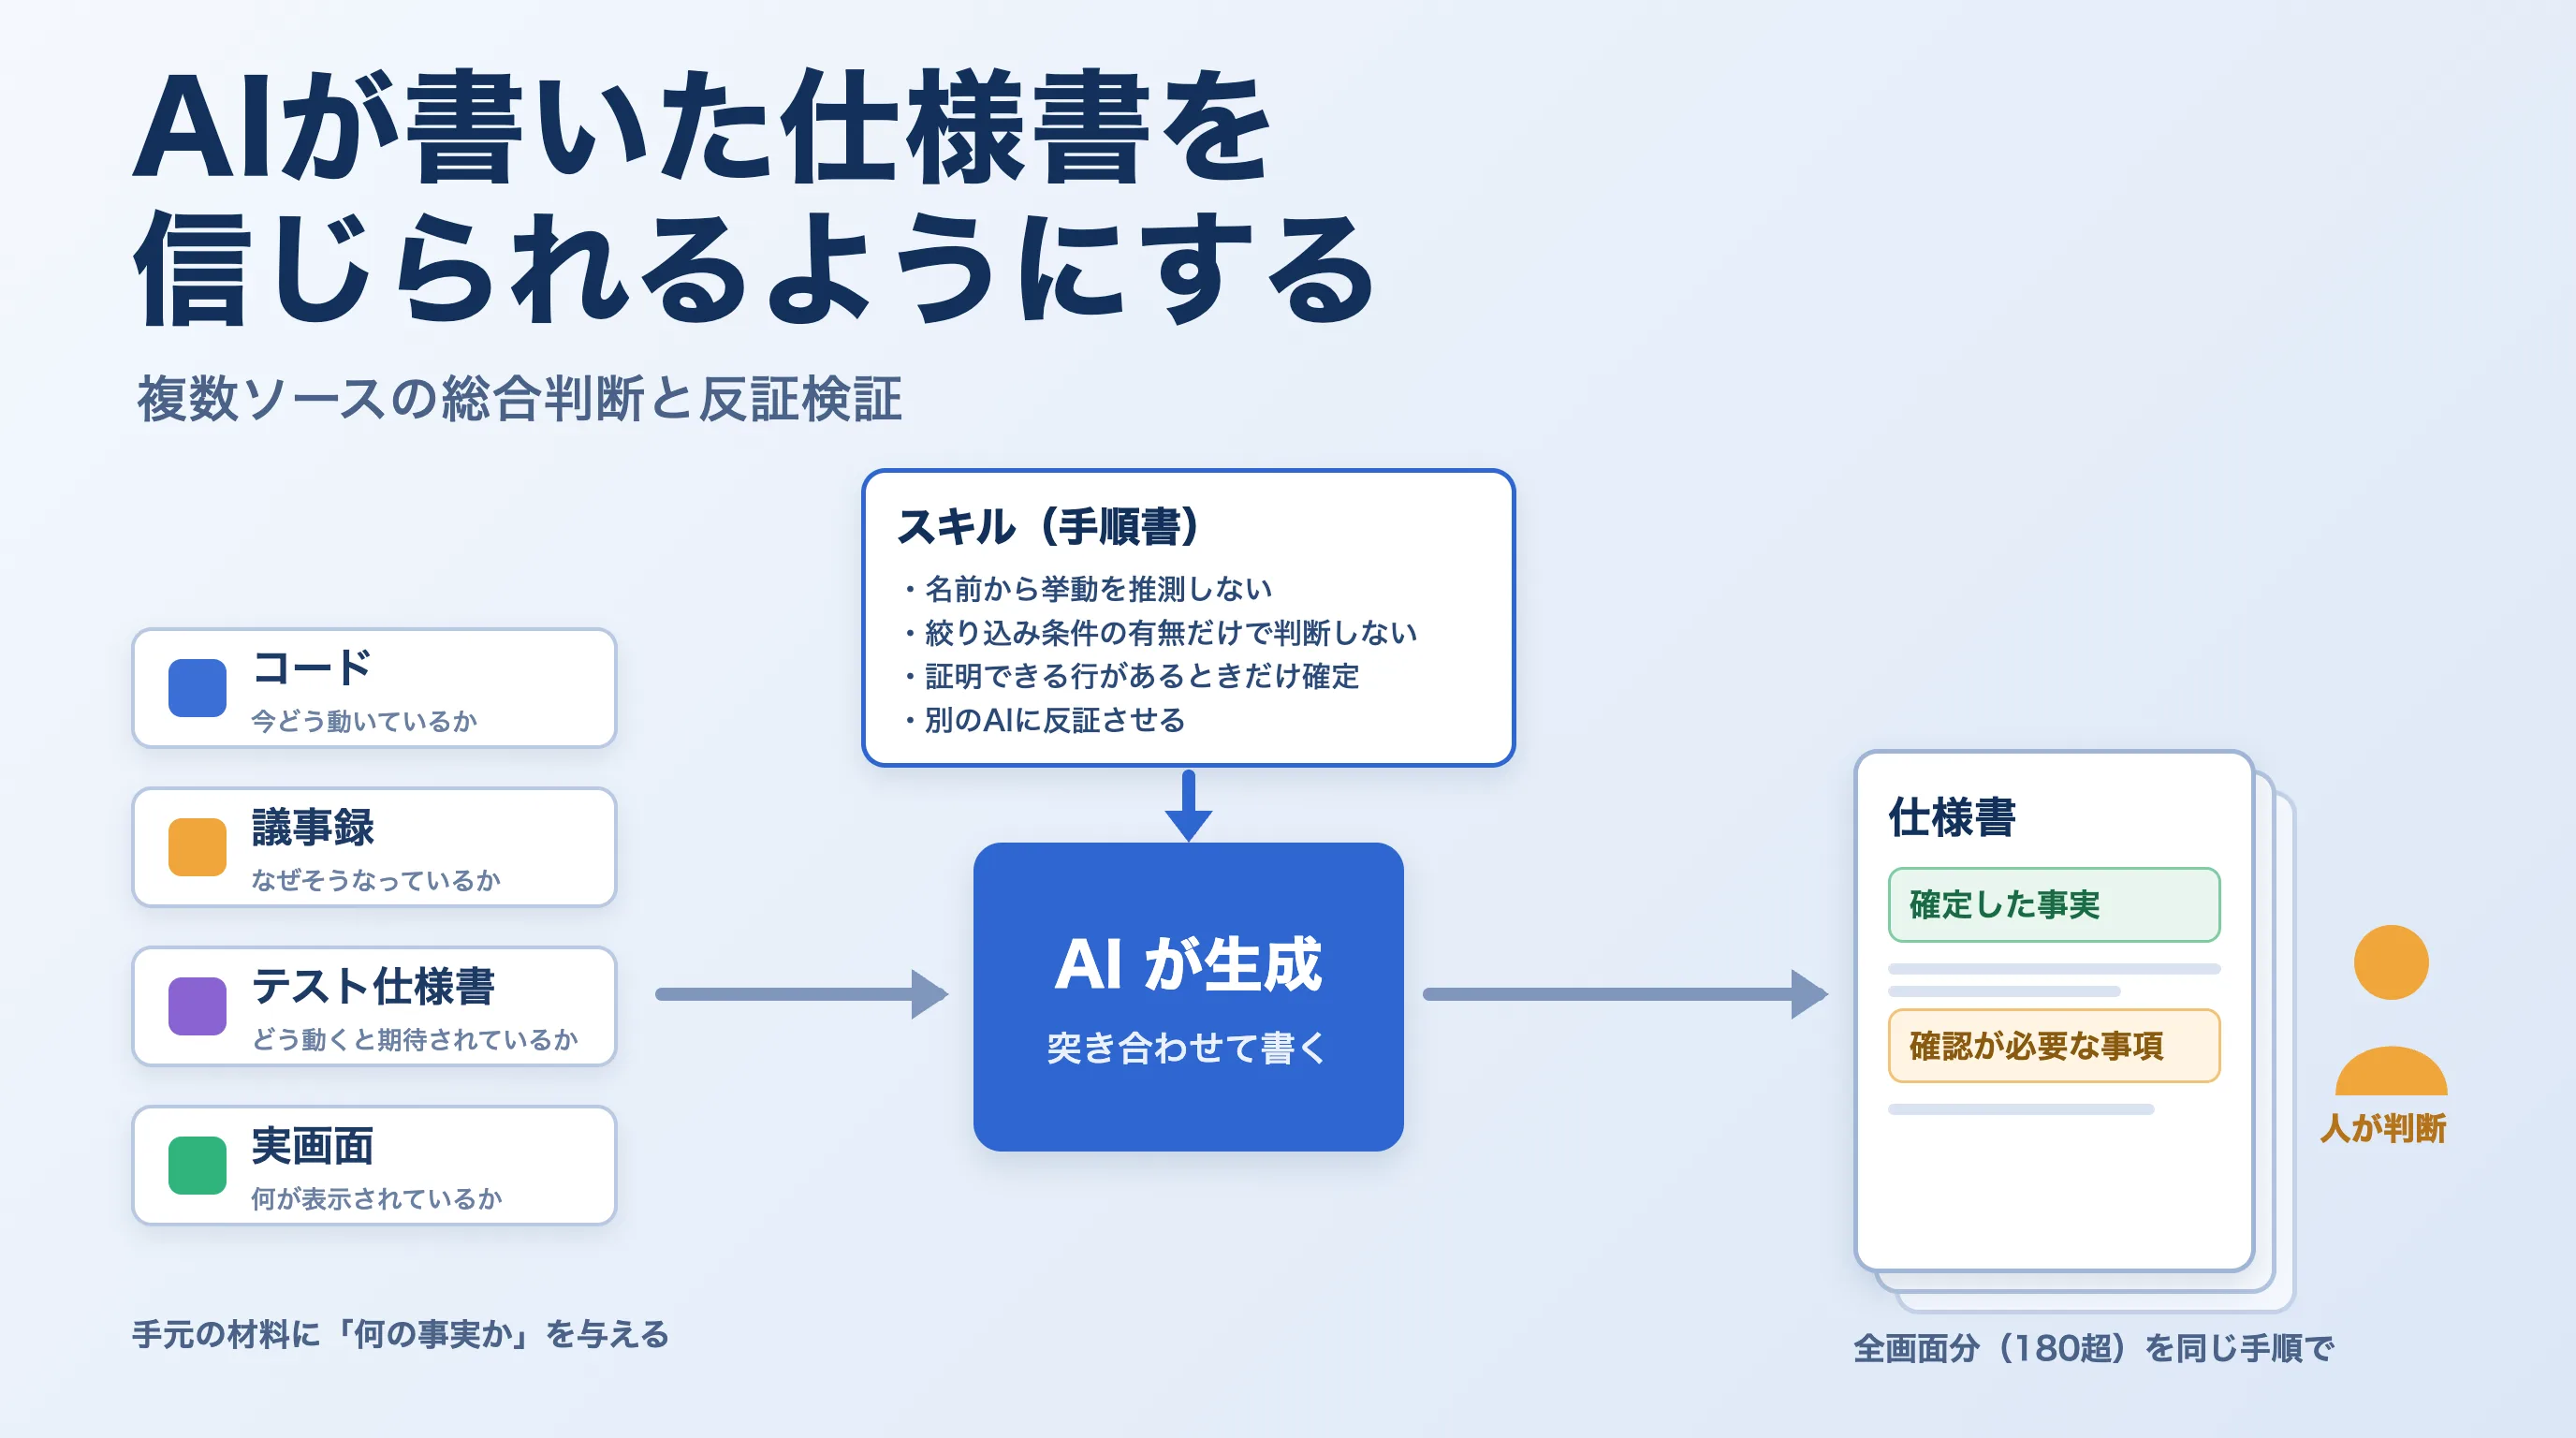
複数の材料をAIが突き合わせ、別のAIが反証してから仕様書に確定する流れのイメージ

AIが書いた仕様書を信じられるようにする ── 複数ソースの総合判断と反証検証

はじめに 私が担当するサービスには、画面ごとの仕様書がありませんでした。あるのは、QAのために書かれたテスト仕様書と、仕様を決めた会議の議事録、設計当時の資料だけです。設計資料はコードの変更に追いついていません。 この状態を、画面ごとに1枚、今どう動いていてなぜそうなっているかを書いた仕様書を全画面分そろえることで解消したいと考えました。画面は3つのサイトを合わせて180を超えます。人が手で書く時間はありません。そこでAIエージェントを書き手にしました。 AIは、もっともらしいが事実と違うことを平気で書きます。関数やテーブルの名前から挙動を推測し、確かめずに断定します。180を超える仕様書が速く出てきても、どれを信じてよいのか分からなければ、業務側に渡せません。 この記事は、その「信じてよいのか分からない」を減らすためにやったことをまとめたものです。結論から言うと、次の3つです。 コード・議事録・テスト仕様書・実画面という手元の材料に「何の事実か」という役割を与えて突き合わせ、食い違った事実と決まらないことは「確認が必要な事項」として人に渡す AIが間違える典型を名指しで禁止し、要になる主張は証明できるコード行があるときだけ確定させる 別のAIに反証させて根拠のない断定を撤回させ、この手順一式をスキルとして固定して全画面に回す 説明は最初から最後まで1つの例で通します。カスタマーサポート向けサイトの会員一覧に、退会した会員と削除された会員は表示されるのか。単純に見えますが、AIが最初に出した答えは間違っていました。 題材は、これまでの記事と同じ架空のオンラインレッスンプラットフォームです。会員向け・講師向け・カスタマーサポート向けの3つのサイトが、会員や講師といった共通のドメインを共有しています(構成はモジュラーモノリス構成の記事を参照してください)。バックエンドはGoで、ORMにGORMを使っています。AIエージェントはClaude Codeです。実際に起きた出来事を題材に置き換えて書いていますが、仕組みそのものは言語やツールに依存しません。 対象読者 Claude CodeなどのAIエージェントに定型作業を任せていて、成果物の質を担保したい方 仕様書が無い、または古いサービスを抱えていて、AIで整備できないかと考えている方 AIの出力に混ざる「もっともらしい誤り」を、実務でどう抑え込むかの具体例を知りたい方 この記事で得られること 全画面分の仕様書をAIに書かせるとき、作る文書と手元の材料をどう定義したか 材料に役割と優先順位を与え、食い違いを決める進め方 AIに推測で断定させないための具体ルールと、別のAIによる反証検証の仕組み 出力を業務の言葉に翻訳させることが、なぜ精度に効くのか 手順一式をスキルとして固定し、全画面を同じ品質で回す運用 動作確認環境 種別 バージョン Go 1.26.3 GORM v1.30 系 Claude Code 2.1 系 1. やりたかったこと ── 全画面分の仕様書を、人が確認できる形で 1.1 作る文書 まず、AIに何を作らせるのかを決めました。ここで言う仕様書は、画面1つにつき1枚の文書です。「この画面が今どう動いていて、なぜそうなっているか」を、業務側の人が読める言葉で書きます。画面の項目(表示する情報や操作のまとまり)ごとに「定義」「業務ルール」「なぜそうなっているか」を持ちます。 そして、仕様書の各項目に必ず「確認が必要な事項」の欄を置き、末尾に一覧として集約しました。AIが材料から確定できなかったこと、材料同士が食い違っていて人の判断が要ることを、ここに集めます。 この欄を最初から用意したのには理由があります。全画面分の仕様書をAIに書かせるとき、人がやるべき仕事は「全文を読んで正しいか確かめる」ことではありません。それでは人の負担がほとんど減りません。人がやる仕事は、AIが「決められなかった」と申告した箇所だけを判断することです。だから仕様書は、「確定した事実」と「確認が必要な事項」の2つに分かれていなければなりません。AIには「決められないことは推測で埋めず、この欄に回せ」と指示します。以降の章で「決める」「残す」と言うときは、この2つの欄のどちらに書くか、という話です。 1.2 全画面をどう回したか 画面は3サイトで180を超えます。進め方は次のとおりです。 各サイトの画面一覧を作り、画面名と画面のURLを列挙する 1画面ずつ、AIエージェントに仕様書を書かせる。手順はスキル(AIエージェント向けの手順書。8章)として固定する 出てきた仕様書の「確認が必要な事項」を人が見て、業務側に確認する 確認結果を仕様書に反映する 1画面あたりの人の作業を、最初の承認と「確認が必要な事項」の判断に絞れたので、全画面でも回りました。ただし、それは「確定した事実」の欄が本当に事実であってこそです。ここが崩れると、人は結局全文を疑って読むことになります。この記事の残りは、その欄を信じられるようにするための取り組みです。 2. 手元にある材料 仕様書は1つの材料からは作れません。手元にあった材料(記事タイトルで言う「ソース」)は次の4つで、どれも多くの会社にある種類のものです。 材料 何か 読者の会社での対応物 コード 実際に動いているプログラム リポジトリ 議事録 仕様を決めた会議のメモ 会議メモ、決定が残ったチャットのスレッド、チケットのコメント テスト仕様書 「この画面でこう操作するとこうなるはず」を書いた手順書 受け入れテスト手順書、QAのテストケース一覧 実画面 AIがブラウザ操作で検証環境を開いて読み取った画面 ステージング環境 名前が似ているので1つ注意があります。テスト仕様書は材料の1つで、仕様書はこれから作る文書です。この記事では両者を区別して使います。 ...
2026年9月28日 · 読了時間: 2分 · 高野智明
キーボードから一歩引き、宙に浮かぶコードやUIパネルを手で指揮するエンジニアの概念イラスト

コードを書かない新卒2年目の開発フロー 〜手書き世代が「判断と段取り」に全振りするまで〜

はじめに こんにちは。and factory で新卒2年目のサーバーサイドエンジニアをしている松ヶ浦です。 新卒2年目ですが、いまはもう、自分でコードをほとんど書いていません。エディタも「書く道具」というより「読む道具」になりました。 ただ、最初からそうだったわけではありません。大学1年の頃は、VS Codeで普通に手書きでコードを書いていました。 きっかけは大学2年で触れたGitHub Copilotでした。そこからAIに任せる比重は増え続け、4年の卒業研究では、VS Codeの拡張機能をほとんどvibe codingで作りました。入社後もこの流れは止まらず、Claude Codeを使うようになった頃には、自分でエディタにコードを打ち込むことはほとんどなくなっていました。 手書きでまともなプロダクトを作った経験はないので、「コーディング力がついた」という実感はもともとありません。 この記事で言いたいことは、2つです。 新卒の仕事は、「コードを書くこと」から「判断と段取り」に移った。 そのうえで厄介なのは、AIが、自分の理解できていないことまで隠してしまうこと。だから僕は、実装に入る前の見積もりで理解を詰め切ることに時間を使っている。 以下では、1つのタスクを概念からPRまでどう進めているかを、実際の流れに沿って書きます。まずは全体像です。各ステップで「人(僕)が握る」か「AIに逃がす」かも併記しました。 flowchart TB A["① タスク受領 〔人〕<br/>何をする機能かを言語化し<br/>設計の方向性を固める"] B["② 見積もり 〔人主体 + AI〕<br/>実装より先に理解を詰め切る<br/>Devin = 一次調査 / Claude Code = 厳密調査"] C["③ 実装 〔AI主体〕<br/>Claude Code が実装<br/>Plan は人が確認"] D["④ PR前確認 〔人〕<br/>コードを読んで検証する"] E["⑤ 動作確認 〔AI + 人〕<br/>自作 skill で実行し手でも触る"] F["⑥ PR提出 〔AI〕<br/>push 〜 PR作成 / Draft は人が Open"] A --> B --> C --> D --> E --> F この図のとおり、コードを書く部分はAIに任せ、僕は「理解」「確認」「判断」に回ります。それでは、各ステップを順に見ていきます。 ...

2026年6月22日 · 読了時間: 1分 · 松ヶ浦健
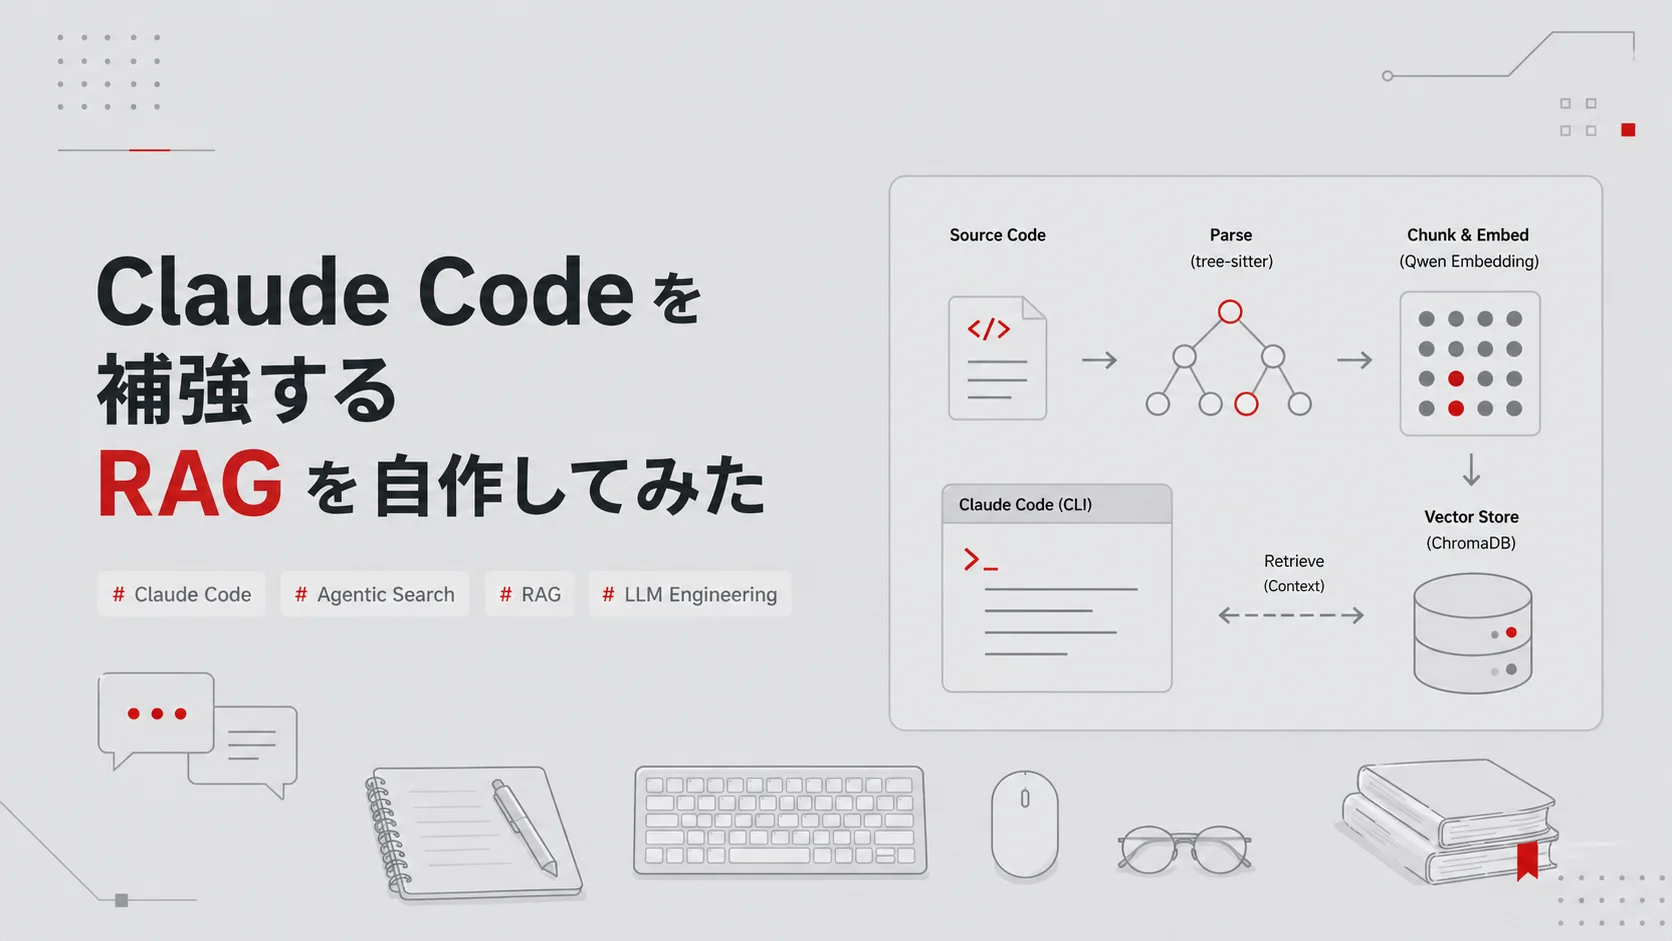
tree-sitter・Qwen Embedding・ChromaDB で組んだコード RAG CLI の構成イメージ

Claude Code を補強する RAG を自作してみた

1. はじめに こんにちは。and factory バックエンドエンジニアの木梨です。 Claude Codeを大規模コードベースで使っていると、「この機能はどこで実装されているか」のような広い問いで Grep や Explore が何度も走り、待ち時間が長くなりがちです。私が触っているGo / PHP / JSが混在する大規模モノレポでも、広い問いで数分待たされるのが日常的に発生していました。 改善策を探していた背景には2つの体験があります。1つは、社内にDevinが導入されたときにDeepWikiでコードベースに広い問いを投げた際の回答速度の速さです。一次情報は見つけられませんでしたが、応答の仕方からして内部でRAGを使っているのではと推測しています。もう1つは、Cursorのブログで報告されているセマンティック検索の導入効果です。どちらも「セマンティック検索を前段に置けば広い問いが軽くなる」という方向を示しています。同じ発想で最小構成のRAGをClaude Codeの前段に置いてみたのが本記事で紹介する構成です。 本記事では、tree-sitter・Qwen Embedding・ChromaDB で組んだ最小構成の RAG CLI を Claude Code から呼ぶまでを手順として共有します。約220行のPythonで動きます。既存のRAGライブラリを使う選択肢もありました。それでも今回自作の形にしたのは、Claude Code用にCLIとして統一したかった点と、中身が見える最小構成のほうが細かい調整をしやすい点の2つが理由です。 対象読者は Claude Code を日常的に使っており、RAG の基本概念(埋め込みベクトル、近傍検索)は既知の方を想定しています。 TL;DR 構成: tree-sitter + Qwen3 Embedding + ChromaDB + Python CLI。約220行 使い方: Claude Codeから検索CLI(例: myrag search)を呼び、候補を Read / Grep で裏取り 効果: 広い問いで待ち時間が体感で明確に短縮された。参考計測では中央値でRAG前段75秒 / Explore very thorough 132秒 / Explore medium 172秒。実行時間の安定性でもRAGが優位。詳細は6章「実際の効果」参照 注意: チャンク化したコードを外部APIへ送る構成。業務利用前に法務・セキュリティ確認が必要。詳細は事前に確認したいことを参照 事前に確認したいこと チャンク化したコードはAlibaba Cloud(DashScope)に送信されます。業務リポジトリで適用する場合は、先に社内の法務・セキュリティ窓口でコード外部送信ポリシーを確認してください。以下は最低限のチェックポイントです。 検証時は匿名化済みコードのみを使う APIキー、秘密鍵、認証トークン、個人情報、契約情報を含むファイルは投入しない .env や秘密鍵は EXCLUDE_PATTERNS(後述)に含まれているので、社内固有の機密ファイルがあれば同じ要領でパターンを足す 機密性が高くそもそも外部送信を避けたい場合は、embedder.py を sentence-transformers 等のローカル埋め込みに差し替えれば同じ構成で動きます。 ...

2026年4月23日 · 読了時間: 14分 · 木梨太一朗
LeakCanaryのリークトレースとClaude Codeの連携を示すイメージ

Claude CodeでAndroidのメモリリーク改善を自動化する ── LeakCanaryの検知からAI修正までのアプローチ

はじめに こんにちは。and factory Androidエンジニアの鬼倉です。 今回は、私が携わるAndroidプロジェクトでClaude Codeを活用し、ANR改善に取り組んだアプローチを紹介します。ANRの原因はさまざまですが、本記事ではメモリリークを原因とするANRに焦点を当てます。 Android開発者にとって、メモリリーク対応のためにLeakCanaryを導入したはいいものの、結局修正できず通知が出続けているという方も多いのではないでしょうか? そこで今回私のプロジェクトでは、LeakCanaryによる検知に加えてClaude CodeのSkillsを活用した自動修正の仕組みを構築しましたので紹介します。 ANRとは? ANR(Application Not Responding)とは、アプリが指定時間内に操作を応答できなかった場合に発生するシステムエラーです。代表的には、UIスレッドが入力イベントに対して5秒以内に応答できない場合などでトリガーされます(BroadcastReceiverやServiceでも発生)。デッドロック、I/O処理のブロック、高負荷処理などさまざまな原因で発生します。Crashと同様にユーザー体験を大きく損なう問題ですが、Crashほど原因が明確でなく再現も難しいため軽視されがちです。ANR率はFirebase CrashlyticsやGoogle Play Consoleで確認できます。 本記事の環境 技術 バージョン Kotlin 2.3.20 AGP(Android Gradle Plugin) 8.9.3 LeakCanary 2.14 ANR改善が進まなかった背景 まずはそもそもメモリリークによるANRの修正改善がなぜ進んでいなかったのかを整理します。 FirebaseのANRレポートだけでは原因を深掘りしにくい Crashの場合、Firebase Crashlyticsに発生元のExceptionが記録されるため、その箇所が直接的な修正対象になります。一方、メモリリーク由来のANRは事情が異なります。複数箇所のメモリリークが徐々に蓄積し、最終的にANRとして発生します。そのため、Firebase上のレポートから直接的な原因箇所を特定することが困難です。 さらに、メモリリークの蓄積は端末のメモリ状況やユーザーの操作パターンに依存するため、開発環境での再現も難しいという問題があります。 ANR改善のためのLeakCanary導入と修正対応の難しさ ANRの発生件数を改善するため、メモリリーク検知の定番ライブラリであるLeakCanaryを導入しました。LeakCanaryを導入すると、開発中の手元の端末上でメモリリークの発生をリアルタイムに把握できます。 しかし、検知できることと修正できることは別の問題です。LeakCanaryはメモリリークの発生タイミングやある程度の情報を提供しますが、明確なコード上の原因までは教えてくれません。開発者自身が情報をもとに原因となるコードを探し出し、修正する必要があります。 さらに厄介なのは、メモリリークの原因となるコードは一見すると問題がないように見える点です。修正にはAndroid開発やKotlinに関する深い知識が求められ、1件あたりの対応に時間を要します。結果として、他の機能開発やCrash対応に比べて優先度が下がり、改善が後回しになりがちな状況が続いていました。 Claude Codeを活用したメモリリーク改善アプローチ 以上の理由により、LeakCanaryやFirebaseのANRログだけでは自力での修正は困難でした。それに対してどのようにAIを活用して修正をしていくのでしょうか? 最もシンプルなアプローチとしては、LeakCanaryが通知を出したら内容をClaude Codeにコピーペーストして修正を依頼することです。この方法でももちろん対応できます。 しかし、Logcatを含めた前後情報があればより精度が高まりますし、コピーペーストという作業をなるべく減らし即座に修正を依頼する環境を構築しなければ、再び後回しになりかねません。 今回私たちが構築したのは、LeakCanaryが通知を出した瞬間にClaude Codeへ/investigate-leakと依頼するだけで完結する方法です。AIが自ら端末のLogcatを確認し、ログ情報からメモリリークの修正を提案します。 LeakCanaryのリークトレースをClaude Codeから取得可能にする なお、本記事のアプローチではLogcatの内容をAIに読み取らせるため、ユーザーの個人情報やAPIキーといった機密情報がLogに出力されていないことが前提となります。 LeakCanaryはメモリリークを検知すると端末上に通知を表示します。しかし、デフォルトではヒープダンプの解析結果がlogcatに出力されません。Claude Codeがリークトレースを自律的に取得できるよう、解析結果をlogcatに出力する仕組みを追加しました。 具体的には、LeakCanaryのonHeapAnalyzedListenerをカスタマイズしています。 1 2 3 4 5 6 7 8 9 10 11 12 13 import leakcanary.LeakCanary import leakcanary.OnHeapAnalyzedListener import timber.log.Timber val defaultListener = LeakCanary.config.onHeapAnalyzedListener LeakCanary.config = LeakCanary.config.copy( onHeapAnalyzedListener = OnHeapAnalyzedListener { heapAnalysis -> defaultListener.onHeapAnalyzed(heapAnalysis) // ここでLogに出力(ここではTimberを利用しています) Timber.tag("LeakCanary").d(heapAnalysis.toString()) } ) この設定により、Claude Codeは以下のadbコマンドでリークトレース全文を取得できます。 ...

2026年4月15日 · 読了時間: 2分 · 鬼倉泰裕