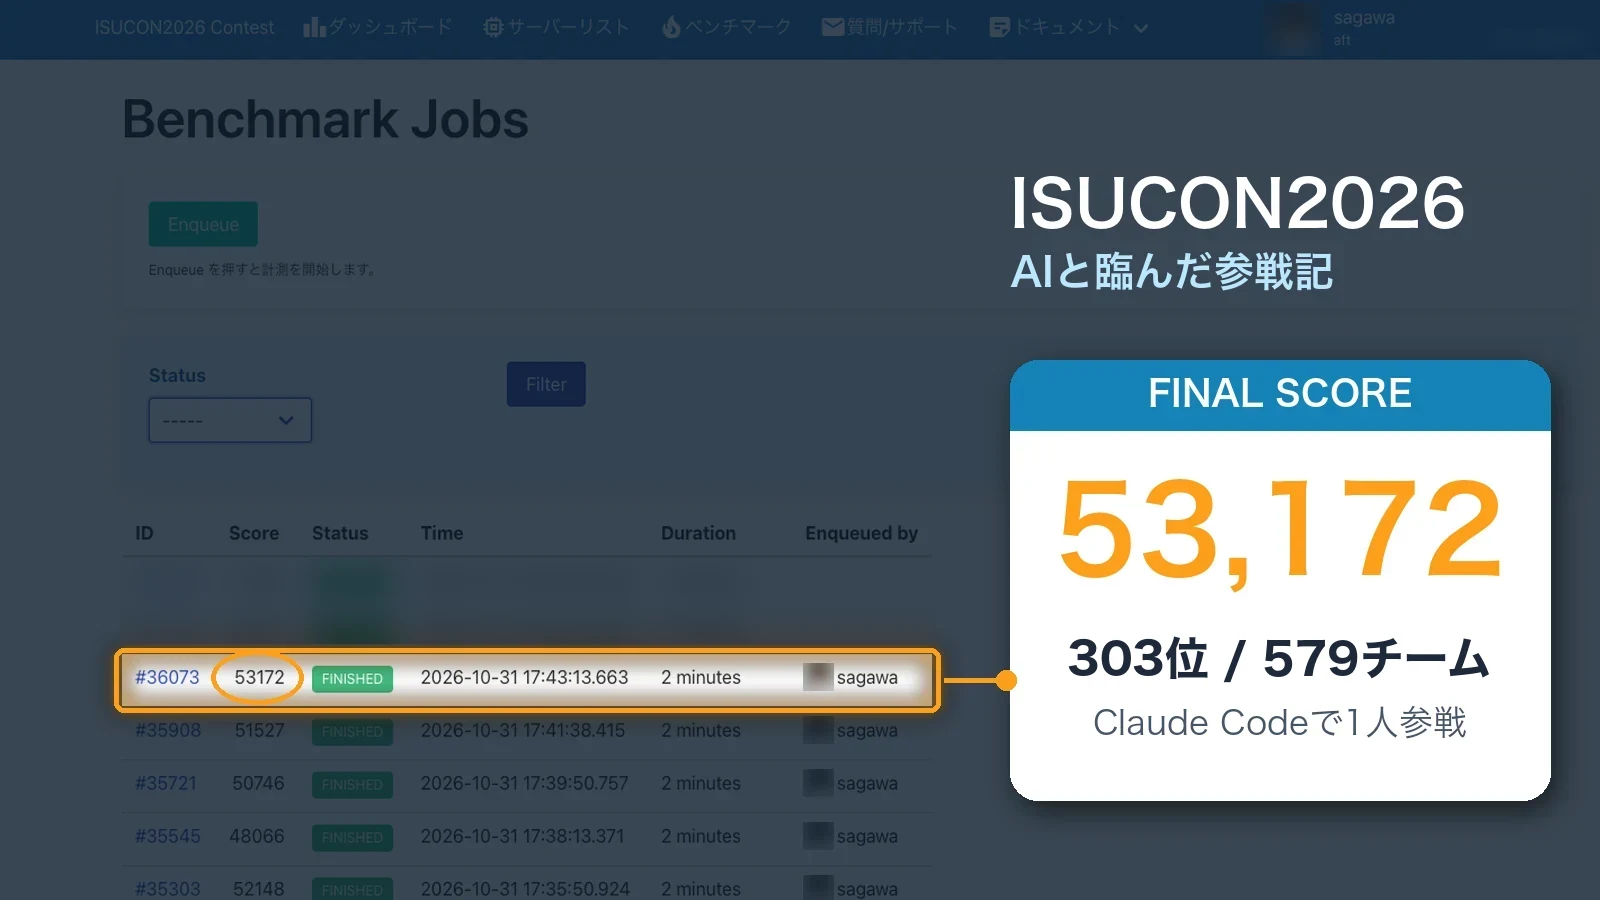
ISUCON2026ポータルのベンチマーク結果一覧のスクリーンショットで、最終スコア53,172点の行を強調し、303位/579チームと示したカバー画像

ISUCON2026に1人で参戦しました ── AIで準備は1時間、勝負は「AIに方向を考えさせる仕組み」へ

はじめに ISUCON2026に参加し、最終スコアは53,172点、順位は303位でした。参加は856チーム(負荷走行を実行したのは662チーム)で、失格にならず順位がついた579チーム(公式結果)のうち、ほぼ中央の順位です。 これまでは会社のメンバーとチームで出場していましたが、今回は1人での参戦です。今年は、一緒に出るメンバーの都合がつきませんでした。ただ、1人でもAIを使えば多少はできることがあるのではと考え、無理にメンバーを集めることはしませんでした。1人での参加は初めてでしたが、AIを活用したことで中央付近の順位に入れました。 今回はAIエージェントのClaude Code(モデルはClaude Opus 5.5)を全面的に使って臨みました。その結果、参加した感覚が今までとは大きく変わり、AIについて深く考えさせられる大会になりました。結論から言うと、次の2点です。 ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で、AIが終えられる。人間は「どう改善するか」に思考を集中できる 一方で、上位との差は「構成の方向」という全体設計の判断で開いた。AIの改善案は、すぐ手の届く箇所を優先する局所的なものに寄りがちで、AIに全体の方向を考えさせる問いかけや仕組みを用意するのが人間の役割になる この記事では、当日の流れとスコアの推移を紹介します。そのうえで、終了後に上位チームの参加記と比べて分かった「足りなかった部分」を、技術とAIの使い方の両面から整理します。最後に、その反省から導いた次回やること(ベンチマークをAIのループに入れる、構成案をAIに複数出させて午前中に方針を固める、など)をまとめます。 対象読者 ISUCONに参加したことがある、またはこれから参加したい方 AIを使ったパフォーマンスチューニングがどこまでできるのかを知りたい方 実際のプロダクトでのパフォーマンス改善にAIを活用したい方 前提となる環境 ISUCON2026の競技環境は、リージョンをまたいだ複数台構成でした。この記事に出てくるサーバーは次のとおりです。 サーバー 役割(最終構成) インスタンス asia1 アプリケーション(全リージョンの /api/ を集約) c5 asia2 DB(PostgreSQL) c5 europe / america nginx(/api/ を asia1 へ転送) c7i 使用した主な技術とバージョンは次のとおりです。nginxとOSのバージョンは、記録が残っていないため省略します。 種別 バージョン Go 1.26.5 Echo v5.3.1 pgx / sqlx v5.11.0 / v1.4.0 PostgreSQL 16 Claude Code 2.1系(当日の最新は2.1.316。モデルはClaude Opus 5.5) 1. 今までのISUCONと、今回のISUCON 1.1 今までの感覚 これまでのISUCONでは、序盤にとにかく時間を取られていました。 ドキュメントを読み込むのに時間がかかる セットアップやデプロイの仕組みづくりにも時間がかかる 簡単なボトルネックを取り終わった頃には、もう半分くらい時間が過ぎている 残り時間で何ができるか、という状態から本格的な改善が始まります。3人で取り組んでもやることが多く、手一杯でした。チームワークと、各自の総合的な技術力が勝敗を分ける競技だったと言えます。 1.2 今回の感覚 今回は、AIを活用して、ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で終えられました。 そのため、どうやって改善するかに思考を集中できました。さらに、AIの側からも多くの改善案が出てきます。自分の力だけでは届かない改善まで実現できてしまう感覚がありました。 今回のISUCONで大事だったのは、AIをうまく使いこなせることです。次の章では、具体的にどう進めたのかを時系列で紹介します。 2. 当日の流れ 2.1 最初の1時間で「速度改善だけに集中できる状態」を作る 最初に行ったのは、改善に集中するための土台づくりです。 ...
2026年11月17日 · 読了時間: 4分 · 佐川 豪
スレート・アンバー・レッドに色分けされた大量の投稿カードが、1本の水平な光線で一斉に判定されている概念図

学生時代のChrome拡張をJevで作り直した ── System Oneモデルで8投稿を244msで判定する

はじめに こんにちは。and factory でサーバーサイドエンジニアをしている松ヶ浦です。 Jevが話題ですね。 僕も公開されたその日のうちにウェイトリストへ登録して、翌日アクセスキーを付与されると、休憩時間を使って遊びました。 驚いたのは速さでした。AIを使ったというより、ローカルの関数を呼んだときの感触に近く、一周回ってAIを使っていない普通のアプリを触っているような感覚になりました。 ひとしきり遊んでから、学生時代にチームで作ったものを思い出しました。Xのタイムラインから誹謗中傷を検知して隠すChrome拡張です。判定はGPT-3.5のAPIに投げていました。 あれ、Jevを使えば同じことがずっと速くできるのでは。 そう思って作り直したので、その記録です。結論から書くと、1リクエストに8投稿を詰めて質問を絞るpackモードでは、8投稿の判定が244msで返りました。1投稿ずつ全6問を聞くsoloモードでは2263msです。拡張の既定はpackモードで、各ユーザーが自分のAPIキーで直接Jevを呼ぶ形にしたため、バックエンドも要らなくなりました。 Jevは何を返すモデルなのか JevはTypeSafeが公開したSystem Oneモデルです(TypeSafeの発表記事)。System Oneは、人間の速い直感的な判断(システム1)になぞらえた呼び名で、じっくり考えて文章を組み立てるのではなく、即座に答えを返すことに振り切ったモデルを指します。 いちばん大きな特徴は、文字列を生成しないことです。返るのは型の付いた構造化された値だけで、公式は「モデルは型エラーを起こさない」と書いています。 レスポンスの形式には3種類あります。 Noul: yesである確率を返す。 Choice: 選択肢から1つ選び、分布とconfidenceを返す。 Score: 順序付きのレベルに対する確率加重値とconfidenceを返す。 公称のレイテンシは70〜500ms、価格は入力が100万トークンあたり0.042ドルで、出力は無料とされています。 そして設計上いちばん重要なのが、stateは1度しか読まれず、すべての質問が並列に評価されるという性質です。これは後半でそのまま速度の話につながります。 もう1つ、ChoiceとScoreの答えにはcalibrated confidenceという確信度が付きます(Noulには付きません)。較正されているという意味で、confidenceが高いほど実際の正答率も高くなります。これも後で使います。 コラム: OpenAIのModeration APIとは何が違うのか この手のモデルの話を聞いて、昔からあるOpenAIのModeration APIを思い出しました。文章を生成せず、テキストを投げると分類結果が返り、しかも速いモデルです。 違うのは、誰が判断基準を決めるかです。 Moderation APIは、カテゴリがサービス側で固定されています。ヘイト、ハラスメント、自傷、性的、暴力といった区分ごとのスコアと、有害である可能性があるかどうかのフラグ(flagged)が返ります。用途が有害コンテンツの検知に寄せてあるぶん、そのままで強い一方、区分そのものは動かせません。「この投稿は内輪のノリか」といった、自分のアプリにしか意味のない問いは立てられません。 Jevは逆で、質問を自分で設計します。stateに文脈を置いて、そこに対して聞きたいことを自分の言葉で並べます。返ってくるのは、その質問に対する確率やスコアです。汎用の分類・スコアリング・抽出のための道具で、モデレーション専用ではありません。 今回のアプリは、まさに「軸そのものを自分で決めたい」側でした。判定の肝は「強い言葉が入っているか」ではなく「悪意があるか」の見極めで、これは既成のカテゴリでは表現できません。 学生時代にチームで作った「へいたん」 へいたんは、学生時代にチームで作ったChrome拡張です。Xのタイムラインを読み取り、誹謗中傷と判定した投稿を隠します。構成は、拡張からAWS Lambda(FastAPI)を叩き、その先でGPT-3.5を呼んで、結果をRedisに7日キャッシュするというものでした。 タイムラインの判定は、GPT-3.5に「この投稿の安全性レベルをJSONで返せ」と頼む方式です。判定用のプロンプトは13行ほどで、例文は入っていません。 へいたんには、投稿前に強い言葉を穏やかな表現へ書き換える提案機能もありました。こちらのプロンプトは85行あり、「変換する例」と「変換しない例」を列挙しています。「返答には変換結果のみを含んでください」「諭すのではなく変換してください」といった、出力の形式を守らせるための念押しも何度か出てきます。モデルに言うことを聞かせるための記述が、判断基準そのものと同じ場所に同居していました。文章を生成するモデルを相手にする以上、当時はこう書くしかなかった部分です。 作り直す 作り直した版はre:へいたんと名付けました。WXT 0.21とReact 19で書いています。対象はタイムラインの検閲だけです。書き換え提案の機能は、Jevが文字列を生成しないので移植していません。 構成はこうなりました。 1 2 3 Chrome拡張 (WXT + React) ↓ Jev 以上です。へいたんではAPIキーをサーバー側に持つ必要があり、そのためにLambdaを置いていました。re:へいたんでは、各ユーザーが自分で発行したAPIキーを拡張の設定に入れ、拡張から直接Jevを呼びます。キャッシュも拡張の中に持たせたので、バックエンドが要らなくなりました。 判定の軸 へいたんの書き換え用プロンプトに並んでいた例文と、re:へいたんの判定は、同じ方向を向いています。どちらも「強い言葉が入っているか」ではなく「悪意があるか」で見分けようとしています。変わったのは、その基準をどこに置くかです。 Jevには文章を渡せますが、レスポンスは文章ではなく構造化されたデータです。そのため「こういう投稿は変換しないでください」と書いても、その指示に従った文章は返ってきません。判断基準は、質問の形に割る必要があります。 ...

2026年9月18日 · 読了時間: 2分 · 松ヶ浦健