はじめに
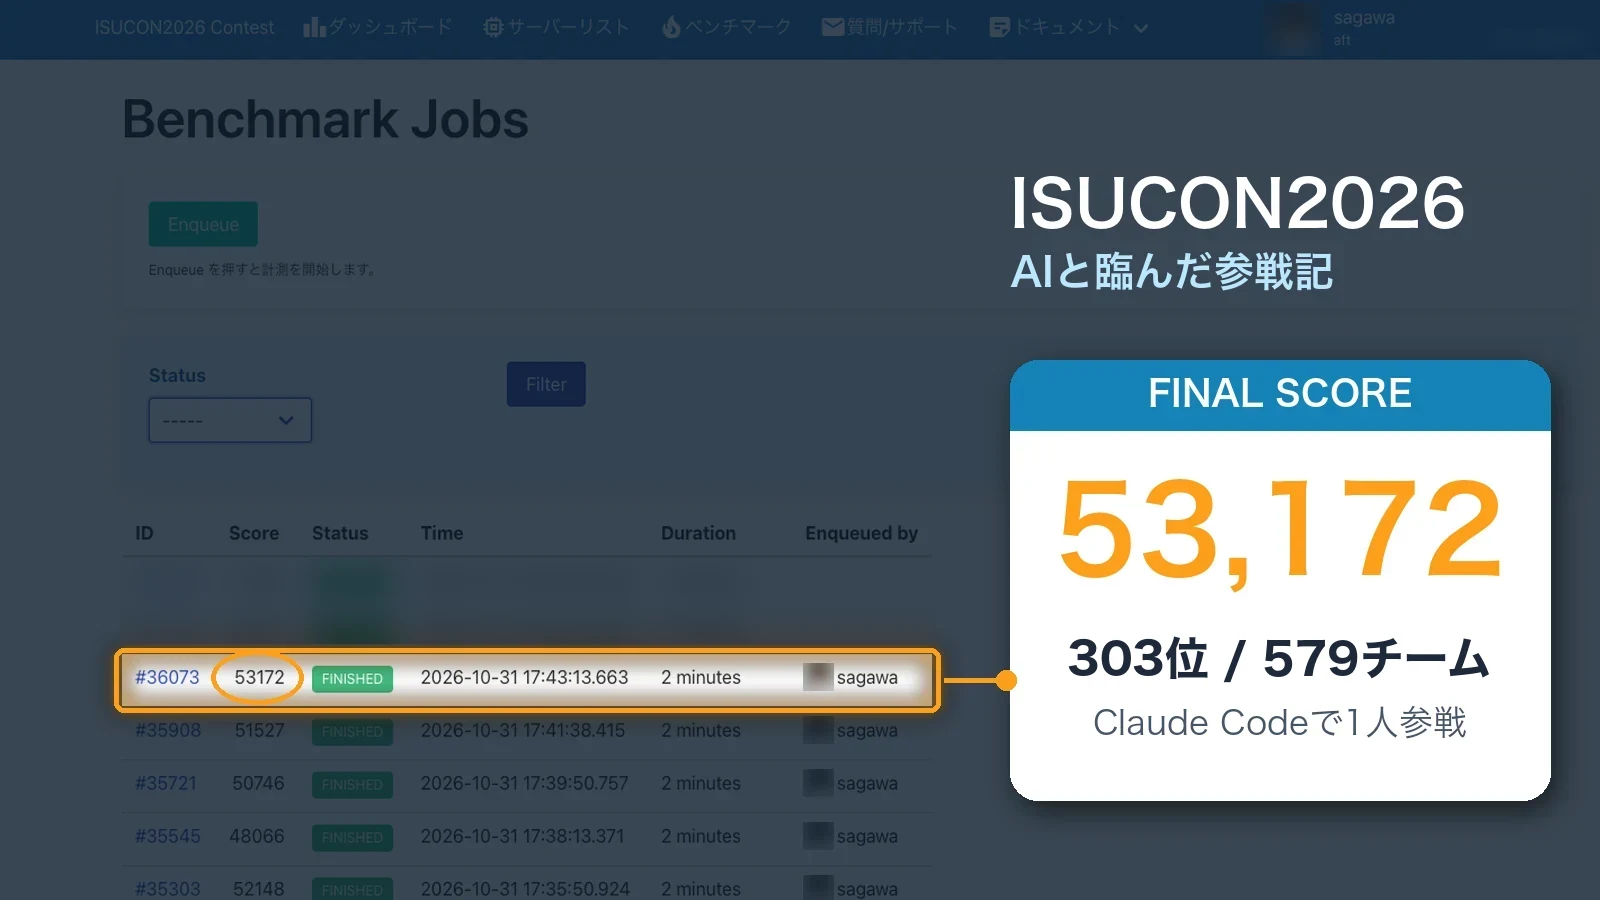
ISUCON2026に参加し、最終スコアは53,172点、順位は303位でした。参加は856チーム(負荷走行を実行したのは662チーム)で、失格にならず順位がついた579チーム(公式結果)のうち、ほぼ中央の順位です。
これまでは会社のメンバーとチームで出場していましたが、今回は1人での参戦です。今年は、一緒に出るメンバーの都合がつきませんでした。ただ、1人でもAIを使えば多少はできることがあるのではと考え、無理にメンバーを集めることはしませんでした。1人での参加は初めてでしたが、AIを活用したことで中央付近の順位に入れました。
今回はAIエージェントのClaude Code(モデルはClaude Opus 5.5)を全面的に使って臨みました。その結果、参加した感覚が今までとは大きく変わり、AIについて深く考えさせられる大会になりました。結論から言うと、次の2点です。
- ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で、AIが終えられる。人間は「どう改善するか」に思考を集中できる
- 一方で、上位との差は「構成の方向」という全体設計の判断で開いた。AIの改善案は、すぐ手の届く箇所を優先する局所的なものに寄りがちで、AIに全体の方向を考えさせる問いかけや仕組みを用意するのが人間の役割になる
この記事では、当日の流れとスコアの推移を紹介します。そのうえで、終了後に上位チームの参加記と比べて分かった「足りなかった部分」を、技術とAIの使い方の両面から整理します。最後に、その反省から導いた次回やること(ベンチマークをAIのループに入れる、構成案をAIに複数出させて午前中に方針を固める、など)をまとめます。
対象読者
- ISUCONに参加したことがある、またはこれから参加したい方
- AIを使ったパフォーマンスチューニングがどこまでできるのかを知りたい方
- 実際のプロダクトでのパフォーマンス改善にAIを活用したい方
前提となる環境
ISUCON2026の競技環境は、リージョンをまたいだ複数台構成でした。この記事に出てくるサーバーは次のとおりです。
| サーバー | 役割(最終構成) | インスタンス |
|---|---|---|
| asia1 | アプリケーション(全リージョンの /api/ を集約) | c5 |
| asia2 | DB(PostgreSQL) | c5 |
| europe / america | nginx(/api/ を asia1 へ転送) | c7i |
使用した主な技術とバージョンは次のとおりです。nginxとOSのバージョンは、記録が残っていないため省略します。
| 種別 | バージョン |
|---|---|
| Go | 1.26.5 |
| Echo | v5.3.1 |
| pgx / sqlx | v5.11.0 / v1.4.0 |
| PostgreSQL | 16 |
| Claude Code | 2.1系(当日の最新は2.1.316。モデルはClaude Opus 5.5) |
1. 今までのISUCONと、今回のISUCON
1.1 今までの感覚
これまでのISUCONでは、序盤にとにかく時間を取られていました。
- ドキュメントを読み込むのに時間がかかる
- セットアップやデプロイの仕組みづくりにも時間がかかる
- 簡単なボトルネックを取り終わった頃には、もう半分くらい時間が過ぎている
残り時間で何ができるか、という状態から本格的な改善が始まります。3人で取り組んでもやることが多く、手一杯でした。チームワークと、各自の総合的な技術力が勝敗を分ける競技だったと言えます。
1.2 今回の感覚
今回は、AIを活用して、ドキュメントの読み込みとセットアップまでを最初の1時間で、初回の計測と簡単なボトルネックの特定までを約1時間半で終えられました。
そのため、どうやって改善するかに思考を集中できました。さらに、AIの側からも多くの改善案が出てきます。自分の力だけでは届かない改善まで実現できてしまう感覚がありました。
今回のISUCONで大事だったのは、AIをうまく使いこなせることです。次の章では、具体的にどう進めたのかを時系列で紹介します。
2. 当日の流れ
2.1 最初の1時間で「速度改善だけに集中できる状態」を作る
最初に行ったのは、改善に集中するための土台づくりです。
- サーバーに入り、必要そうなファイルをいったんすべてGitHubのリポジトリに入れる
- Makefileのベースを作り、AIにデプロイ方法を調べて設定させる
- nginxとPostgreSQLの設定ファイルもリポジトリに入れ、設定の反映もAIに自動化させる
2の段階で、AIはローカルからすべてのサーバーを操作できる仕組みを作りました。デプロイも設定反映も、ローカルからコマンド1つで実行できます。
AGENTS.mdを競技用に書き換える
サーバーから取り込んだファイルの中には、AI向けの AGENTS.md がありました。中身は、このサーバーが本番環境であるという前提で、sudo やサービスの再起動、DBへの書き込みなどを禁止し、確信の持てない操作は控えるよう求めるものでした。これは、運営がAI向けに用意したとみられる偽の指示の1つです。従ってしまうと、AIは設定の変更やサービスの再起動すらためらいます。
そこで10:58に、AIに指示して、この AGENTS.md を競技用に書き換えさせました。本番環境ではなく競技であることを明記し、当日マニュアルを正としたうえで、スコア改善のための変更は積極的に行ってよいとしています。その代わり、失格につながる競技ルール上の禁止事項と、守るべき仕様を具体的に並べました。判断に迷う操作を人間に確認するルールなど、元のファイルの制約の一部も残りました(4.4節)。
当日は特に意識せずに行ったことですが、置き換えること自体は必要でした。サーバーから取り込んだ AGENTS.md のようなAI向けのファイルは、そのまま読ませず、最初に競技用の内容へ置き換えておくのがおすすめです。ただし、置き換えた中身にも反省点がありました。これは4.4節で扱います。
ここまでが最初の1時間ほどです。以降は速度改善だけに集中できました。
2.2 スコアは4,663点から53,172点まで伸びた
当日のスコアの推移は次のとおりです。
xychart-beta
    title "スコアの推移(点)"
    x-axis ["11:35", "12:30", "13:30", "14:15", "15:30", "15:35", "16:00-17:00", "最終"]
    y-axis "スコア" 0 --> 60000
    line [4663, 10000, 17000, 25000, 30000, 37000, 48000, 53172]
※ 最終スコア以外は、各時点のおおよその値です。最終は単発の値で、最後に計測した12回の中の最高点です。横軸は時刻をカテゴリとして並べているため、間隔は経過時間に比例しません。
時間帯ごとに、何をやったかを紹介します。
11:35 初回ベンチマーク:4,663点
初回のベンチマークは4,663点でした。この時点で、nginxのアクセスログや pg_stat_statements など、計測の仕組みもAIが整えていました。
〜12:30 定番の改善:約1万点
まずは定番の改善を進めました。
- 通知用のSSE(Server-Sent Events)の接続を、nginxが60秒で切らないようにする
- DBのアイドル接続数を増やす
- 投稿期間のロックを
FOR UPDATEからFOR SHAREに変える - 全件スキャンになっていたテーブルにインデックスを追加する
1つ目のSSEの問題は、ログの解析で見つかりました。通知を届ける GET /api/notifications は、SSEで投稿期間の開始まで接続を保ち続けます。ところが、レスポンス時間のP90がちょうど60秒になっていました。nginxのerror.logにも upstream timed out が出ていました。
原因は、nginxの proxy_read_timeout が既定値の60秒のままだったことです。nginxは、アプリケーションから60秒間データが届かないと接続を切ります。そこでこのエンドポイントだけ設定を分け、タイムアウトを延ばしました。あわせてバッファリングも止め、通知をすぐ送るようにしています。次の設定は、13:30の構成変更より前のasia1のものです。
| |
なお、locationに proxy_set_header を1つでも書くと、server・httpレベルの proxy_set_header は継承されなくなります。また、13:30以降のように欧米の /api/ をasia1へ転送する構成では、転送側のnginxにも proxy_read_timeout と proxy_buffering off が必要です。
〜13:30 DBとの往復を減らす:約1.7万点
次に、DBとのやり取りを減らしました。
- DBとの往復を削減する
- ログインのSQLを1本にまとめる
- 関係操作のロックを短くする
- 画像URLの署名の期限をそろえ、署名を使い回す
13:30〜14:15 構成の変更:約2.5万点(約1.5倍)
ここで構成を変更しました。まず公式のQAで、欧米のnginxからasia1のアプリへ転送してよいことを確認しました。
それまでは欧米のサーバーでもアプリケーションを動かしており、asia2のDBへクエリを送るたびにリージョンをまたいでいました。そこで欧米の /api/ をasia1上のリージョン別プロセスへ転送し、リージョンをまたぐ往復を、1リクエストあたり1回にまとめました。DBとの往復は、asiaの中で閉じるようになります。この変更で、スコアは約2.5万点まで伸びました。
flowchart LR
    EU["europe<br/>nginx"] -- "/api/" --> A1["asia1<br/>リージョン別プロセス"]
    US["america<br/>nginx"] -- "/api/" --> A1
    A1 --> A2[("asia2<br/>PostgreSQL")]
asia2(DBサーバー)に一部のAPIを振り分ける案も試しました。ただしスコアが悪化したため取りやめています。
14:15〜15:30 署名計算とロック待ち:約3万点
署名計算を高速化しました。HMACのインスタンスを使い回すことで、計算速度は2.7倍になりました。
あわせて、重いSQLとロック待ちにも対策を入れ、約3万点に到達しました。一方で、この頃からasia1のCPUが飽和し始めていました。
15:35 JPEG検証をlibjpeg-turboに置き換え:平均2.9万点 → 3.7万点
アップロード画像のJPEG検証を、Go標準の image/jpeg による jpeg.Decode からlibjpeg-turboに置き換えました。平均スコアは2.9万点から3.7万点に上がりました。
この改善は、実は早い段階で私からAIに提案していたものです。「素の jpeg.Decode が遅いのでは?libjpegもあるし」と伝えていました。しかしAIは効果が限定的と判断し、後回しにしていました。
14:20のプロファイルでは、JPEGのデコードがasia1のCPUの37%を占めていました。15:35に改めて「意味があると思うので、やって」と指示したところ、実際に効果が出ました。AIの優先順位づけをそのまま受け入れず、人間が判断を差し込んだことで伸びた部分です。
16:00〜17:00 細かな改善の積み重ね:約4.8万点
最後の1時間は、細かな改善を積み重ねました。かっこ内の点数は個々の変更の効果ではなく、その変更を入れた時点のスコアです。
- ユーザー検索の改善(約4.2万点)
- 署名の事前計算
- nginxの同時接続上限の調整と、友達申請へのインデックス追加(約4.7万点)
- 画像本体のキャッシュ(約4.8万点)
- ログの削減
この頃、DBの読み取りを別のサーバーに分ける案もAIに提案しました。しかしAIは、asia1のCPUが高いことを理由にこの案を見送りました。私もその判断を受け入れ、実施しませんでした。
17:00〜 最終計測の準備:53,172点
最後に、最終計測に向けて準備しました。
- pprofと
pg_stat_statementsを外し、nginxのアクセスログを止める - 全台を再起動し、追試の条件を満たすことを確認する
計測用の仕組みを外したあと、17:23〜17:43に12回計測しました。再起動直後の1回(43,774点)を除く11回のスコアは46,654〜53,172点と幅があります。11回の中央値は51,527点でした。最終スコアの53,172点は最後の17:43の回で、この日の最高点でもあります。
最終版の直前の版の2回平均(48,646点)と比べると、中央値までの約2.9千点には、計測の負荷が減った分も含まれると考えています。ただし、比べた基準が2回の平均なので、ぶれとは切り分けられていません。中央値から最終スコアまでの差は、計測のぶれの分です。
最終スコアは53,172点、順位は303位でした。
2.3 AIとの進め方を3つ工夫した
AIと進めるうえで、次の3点を工夫しました。
- 変更のたびに、結果と判断をMarkdownのログに残させた:何を試し、なぜ採用・不採用にしたのかを後から追えるようにした
- ベンチマークは2回の平均で評価した:同じ版でも6.9千点と9.6千点のようにスコアがぶれたため。1回の結果だけで判断するよりは、改善か改悪かを見誤りにくい
- 版ごとにタグを付けた:悪化したら、すぐ前の版へ戻せるようにした
記録をMarkdownで残させる
3点のうち最も効果があったのは、1つ目の記録です。変更や計測のたびに、結果と判断をMarkdownのログとしてAIに書き出させました。競技中に、45本のログがリポジトリの log/ に残りました。
| |
1本のログには、スコア・計測で分かったこと・次の候補をまとめさせました。たとえばインデックスを追加したときのログには、次の内容が残っています。
| |
記録を書き出させたことで、ベンチマークを実行している間の待ち時間に、このログを読んで方針を検討できるようになりました。AIとの対話の流れを追い直さなくても、ログを読めば今の状況と次の候補が分かります。待ち時間が、次の一手を考える時間に変わりました。
また、何を試し、なぜ採用・不採用にしたのかを後から追えます。この記事のスコア推移や判断の経緯も、このログをもとに書いています。
3. 振り返って分かった、足りなかった部分
競技の終了後、参加記をまとめて読み、上位チームと比べました。公式の結果では、順位がついたチームのうち20万点以上は43チームで、1位は約62.6万点です。私のスコアとは10倍以上の差があります。
この章と次の章は、「上位チームの参加記を読んで、自分との違いを調べて」とAIに頼み、まとめてもらった内容をもとにしています。自分の何が足りなかったかを論理的に指摘してもらえるので、振り返りの手間は大きく減りました。ただし、AIの要約には数値や経緯の誤りも混ざっていました。そのため、他チームについての数値と引用は、各チームの参加記の原文で確認し、出典を脚注に示しています。
ここでは、差が開いた技術的な原因を整理します。AIの使い方の差は、次の4章で扱います。
3.1 構成の方向が逆だった(最大の差)
最も大きな差は、構成の方向でした。
欧米のAPIをasia1へ集める構成にした結果、asia1のCPUが飽和しました。その間、欧米とasia2のCPUは空いていました。
上位チームは逆に、読み取りを各リージョンで返し、書き込みを1か所に集める構成を取っていました。読み取りを各リージョンで返す方法は、欧米に同期レプリカを置くか、データを各台のメモリに複製するかのどちらかです。参加記を確認できた範囲では、20万点以上のチームはほぼすべてがこの形でした1,2,3,4。
さらに、2位と3位のチームは、ログインのたびに全リージョンの同期を待たない作りに変えて、大きくスコアを伸ばしています2,3。2位のチームは、得点が何から生まれるかをログで確かめ直したことを、最大の転機に挙げています2。得点の仕組みとの関係は、4.5節で扱います。
flowchart TB
    subgraph ours["自分の構成:asia1に集約"]
        direction LR
        E1["europe"] --> X1["asia1<br/>(CPU飽和)"]
        M1["america"] --> X1
        X1 --> D1[("asia2")]
    end
    subgraph top["上位チーム:読み取りを分散・書き込みを集約"]
        direction LR
        E2["europe<br/>読み取りを返す"] -- "書き込みのみ" --> W2["書き込み先"]
        M2["america<br/>読み取りを返す"] -- "書き込みのみ" --> W2
    end
asia1に集める構成のままでも、3.3節・3.4節の改善でスコアはまだ伸ばせました。しかし20万点級に届くには、欧米のCPUを使う必要がありました。
3.2 サーバーの性能差を見ていなかった
私は、署名の計算を一番遅いサーバーに集めていました。asiaのc5にはSHA-NI(SHA-256を速く計算するための拡張命令)がなく、欧米のc7iにはあります5。あるチームの計測では、署名1件の計算にasia1は約450µs、europeのサーバーは約140µsかかり、約3倍の差がありました5。
最初に /proc/cpuinfo を確認しておくべきでした。
| |
インスタンスの違いでこれほどの差が出るとは思いもよらず、スペックの違いを事前に確認する重要性を、後から実感しました。
3.3 画像をDBに置いたままにした
私は、画像をPostgreSQLの bytea 型のカラムで持ち続けていました。
上位チームは画像をファイルに移していました4,6,7。配信をnginxの X-Accel-Redirect に任せたチームもあります6。チームちゃん(12位)では、この変更で43,392点から62,337点に伸びています7。
画像をDBに持たせない改善が効くケースは、過去のISUCONでも何度かありました。しかし今回は別の改善に注力した結果、見落としていました。「このデータは本当にDBに持つべきか」を問いかけてみるべきでした。
3.4 不正な巨大アップロードを全部受信してから検証していた
私は、アップロードされたファイルを全部受信してから検証していました。ベンチマーカーは、プロフィール画像の代わりに31MiBのMP4データを送ってくるなど、不正なファイルもアップロードしてきます7。2位のチームは、ルーターの上り方向の通信量のおよそ60%が、こうした不正なデータなどだったと計測しています2。
JPEGかどうかを先頭の2バイトだけで判定し、残りを受信する前に拒否したチームもあります。このチームでは、asiaのサーバーの受信量が2,466MBから66MBに減っています7。
ただし、nginxを前段に置く構成では、既定の proxy_request_buffering on により、nginxが本文をすべて受信してからアプリへ渡します。アプリ側で早く判定するだけでは、受信量は減りません。実際に、チーム54は先頭のバイトで不正な画像を判定したうえで、nginxが本文をためずにアプリへ流す構成にしていました4。2位のチームは、nginxを使わず、アプリが直接リクエストを受ける構成でした2。
3.5 署名は事前計算とキャッシュまでで止まった
私の署名の高速化は、事前計算とキャッシュまでで止まりました。
参加記の中には、さらに踏み込んだ例がありました。約183万枚ある初期画像の署名を競技の途中でまとめて作っておき、リクエストごとの計算をなくしたチームがあります8,9。チームtakは、署名の有効期限を12時間単位でそろえ、初期画像すべての署名をあらかじめ表として作れる形にしていました8。AVX-512を使い、16件分の署名を同時に計算したチームもありました5。
3.6 通知の作り方とテーブルロックを変えなかった
投稿期間の開始時に発生する通知への対策は、一括INSERTの高速化にとどまりました。usersテーブル全体へのロックも残ったままでした。
参加記の中には、通知をDBの行として保存せず、配信する時点で投稿期間から生成していたチームがあります10。SSEの通知を、一定間隔の問い合わせからPostgreSQLの LISTEN/NOTIFY に切り替えたチームもありました5。
4. AIの使い方の反省 ── 上位チームとの運用の差
3章では、技術的な差を整理しました。ただ、それらの差の多くは「AIをどう動かしたか」に行き着きます。
そこで、参加記のうちAIの運用について書かれた約40本を読み、自分のやり方と比べました。この章では、自分のやり方の反省点を中心に、参考になった他チームの例と、次回やることをまとめます。
4.1 私のやり方
私は、Claude Codeの1セッションを対話で操作していました。1周の流れは次のとおりです。
flowchart LR
    A["計測"] --> B["AIが原因を分析し<br/>改善案を出す"]
    B --> C["人間が採否を決める"]
    C --> D["AIが実装し<br/>デプロイする"]
    D --> E["人間がポータルで<br/>ベンチマークを2回実行"]
    E --> F["平均で評価し<br/>ログに記録"]
    F --> A
計測を根拠に判断し、結果を記録に残す点は、上位チームと同じでした。ただし、この1周が遅く、初期実装を少しずつ直す一本道で、作り直しの選択肢を持っていませんでした。以降で、その原因を7つの観点から整理します。
4.2 ベンチマークをAIのループに入れていなかった
私は、ベンチマークを毎回人間がポータルで2回実行していました。そのため、ベンチマークの待ち時間と人間の判断待ちが、改善の速度を決めていました。
参加記の中には、ベンチマークの実行と結果の確認を、AIや自作のツールに任せていたチームがあります。手段は、ポータルのAPI、Claude in Chrome、Playwrightなどさまざまです8,10,1。
| ベンチマークの実行者 | 回数 | |
|---|---|---|
| 1位のチーム1 | AI(人間の入力は0回) | 86回 |
| チームtak(人間1人)8 | 自作ツール(isud)が自動実行(1周約3分のループ) | 約7時間半で123回 |
| 私 | 人間が毎回ポータルで2回実行 | — |
ベンチマークの実行を毎回人間に頼んでいたこと(100回)が、1位に差をつけられた主な理由の1つだったと振り返るチームもあります11。
4.3 最初に作り直してから改善に入る進め方をしなかった
私は最初から最後まで、初期実装を少しずつ直していく進め方でした。AIは、初期実装があるとその設計に引っ張られます。
2位と3位のチームは、最初に仕様を書き出させ、初期実装を見せずに作り直させてから改善に入っています2,3。仕様をまとめる役と作り直す役を、2位はサブエージェントで、3位はセッションを分けて担わせていました。3位のチームは、この方法によって13:35の時点で190,360点を出しています3。仕様を書き出し、そこから実装を作り直させる方法は、大掛かりですが実際の開発でも使えそうだと感じました。
一方で、セッションの数そのものは、勝敗を分けていなかったようです。役割を分けて並列化したチームもあれば、1つのセッションで勝ったチームもあります。
- 並列化した例:AIを指揮役1つと実装役3〜4つに分け、実装を並行させた9
- 1つのセッションの例:競技用のエージェントは1セッションのみで、伸び悩んだときに見直し役を一時的に加えただけだった(1位)1
- 使い分けた例:メインのセッションで作り直しと改善を進め、仕様の整理と方針の相談は別のセッションで行った(3位)3
分割構成で臨んだチームsuekouも、8時間の競技ならエージェントを1つに絞っても足りたと振り返っています6。チームINUCON2026も、練習の結果から、セッションを分けずに臨む方針を取っていました12。
なお、並列を増やす場合は、統合やベンチマークの衝突に注意が必要です。ベンチマークの実行中に別のAIがデプロイして5回失敗し、デプロイとベンチマークを1つのAIだけに任せるようにしたチームもありました13。サーバーへの操作とベンチマークを専用のキューに通し、同時に走らないようにしたチームもあります14。
4.4 構成の作り直しをAIにさせる仕組みがなかった
12:15のログで、AIは「DBのレプリカ、asiaへの転送など」の構成変更を候補に挙げていました。ただ、扱いは「ルールの解釈を含めチームで判断」で、AIから踏み込んで勧めることはありませんでした。13:30には、AIが提案した変更の小さいasiaへの転送に、私も乗っています。その後、DBの読み取りを別のサーバーに分ける案も、asia1のCPUが高いことを理由にAIが見送り、私はそのまま受け入れていました。
AIは、指示がなければ手前の改善を優先しがちです10,13。構成の作り直しも見送られやすくなります。参加記にも、作り直しを「想定実装時間が8時間以上なため却下」とした例や、13時以降に「時間的に実装が間に合わないため、諦めます」とした例がありました12。短期のスコアだけで判断させると、一時的に点が下がる土台づくりを却下し続けます。
逆に、チーム54では、AIがasia1のCPUに注目していた時期に、人間が画像をDBではなくファイルに保存する案を出しました。この案でスコアは約2倍に伸びています4。
参加記で効果があった、または次に試すべきとされていた手は、次のとおりです。
- 実装時間は考えなくてよいと伝える12
- 各案の効果をスコアの伸び率の予測として数値で出させ、その順に試す14
- 規模の大きい変更を試す時間帯を、午前中と決めておく11
- 到達できないほど高い目標スコアを示し、必要なことを逆算させる13
もう1つ、AIへの指示を書いた AGENTS.md も、原因の1つだったと考えています。2.1節のとおり、当日は AGENTS.md をAIに競技用へ書き換えさせ、「スコア改善のための変更は積極的に行ってよい」と書かせました。ただ、攻めてよい範囲はこの一文だけでした。具体的に書かれていたのは、失格を防ぐための決まり、チームtakの参加記の言葉を借りれば「守る線」でした8。あわせて、判断に迷う操作は人間に確認するよう求めていました。再起動後にデータを失うおそれのある変更(データをメモリだけに持つ、DBの書き込みの同期を止めるなど)も、事前の確認の対象でした。判断に迷う操作の確認と、データを失う変更の事前確認は、当日AIが書き換えたときに、元の AGENTS.md から引き継がれたものです。書き換えても、元の制約の一部が残っていました。
元のファイルは偽の指示とみられるものでしたが、データを失う変更の事前確認は、追試の条件から見ても必要な決まりでした。ただ、3.1節で触れたデータをメモリに複製する構成も、変更ログで永続化すればデータを失う変更には当たりません。それでも、判断に迷ったら確認するというルールと合わさると、AIは保守的に判断しやすくなります。「変更ログで永続化すればメモリに持ってよい」「構成の作り直しも選択肢に入れる」といった「攻める線」を具体的に書いていなかったため、AIがこの方向を選びにくい状態でした。AGENTS.md に性能面の思い込みに基づくルール(nginxを使い続ける、など)を入れたことで、選べる手が減ったと振り返るチームもありました11。チームtakも、自分で書いた決まりにAIが従って慎重になり続けたと振り返り、次回は「守る線」と「攻める線」を分けて書くとしています8。
4.5 最初に得点の仕組みと環境を調べさせていなかった
私は、得点の仕組みや環境を最初にAIへ調べさせていませんでした。
当日マニュアルの説明では、欧米で生まれた得点はアジアの1.5倍に数えられます。2位の参加記によれば、得点の多くは、登録済みのユーザーが一連の操作を何周も回ることで積み上がっていました2。3.1節で触れた3位のチームは、ログイン処理から全リージョンの同期を待つ部分を取り除き、最終盤にスコアをほぼ倍にしています3。
ログを利用者別に分析し、どの行動を早く終えた人の数が翌日の新しい利用者の数を左右するかを推定したチームもあります5。逆に、得点の内訳を分析したのが終盤になり、構成を変える余裕がなかったと振り返るチームもありました6。
環境も同じです。開始30分で、環境の一覧をAIに作らせておくべきでした。CPUの命令、メモリ、DBのサイズ、リージョン間の遅延などです。そうしていれば、3.2節のSHA-NIの有無にも最初に気づけました。
4.6 観点を渡すことと具体案を差し込むことを使い分けるべきだった
私の関わり方は、AIの改善案に採否を出すことが中心でした(4.1節)。libjpeg-turboへの置き換えのように、自分から具体案を差し込んで伸びた例もあります(2.2節)。ただ、14:20のプロファイルで根拠がそろっていたのに、指示したのは15:35でした。この遅れは4.7節で扱います。
参加記を読むと、効いていたのは、まず答えではなく観点を渡す問いかけでした。
3位のチームでは、制約から考え直すよう促した人間の問いが、終盤の大きな伸びにつながっています3。一方で同じチームでも、人間が大がかりな作りの変更を指示したときは、点数が下がっていました3。また、4.4節のチーム54では、人間の具体案が「最も効いた発言」とされています4。
人間は、観点を渡して方向づけることを基本にしつつ、計測などの根拠がある具体案はためらわずに差し込むのがよいと考えています。そのうえで、停滞の検知と最後の判断に集中します。
4.7 残り時間を意識させるのが遅れた
4.6節で挙げた人間の役割のうち、私は停滞の検知が遅れました。AIは、特に指示しない限り、競技の残り時間を意識しません。15:00前後、改善があまりにスローペースだったため、私はAIに次のように伝えました。
競技終了は18:00なので、インパクトの大きいことに目を向けてほしい
ただ、この指示はもっと早く出すべきでした。16:50のログには、画像をDBの外に置く変更が「残り時間では危険なため見送り」と記録されています。3.3節で書いたとおり、上位チームで大きく効いた改善です。時間帯ごとに何をすべきかを考え、AIをコントロールすることは、もっと早くから意識すべきことでした。
4.4節の「実装時間は考えなくてよい」と矛盾するように見えますが、両者は別のものを指しています。4.4節の指示は、1つの案にかかる手間を理由に、効果の大きい案を見送らせないためのものです。一方、ここで扱っているのは競技全体の残り時間です。案を選ぶときは、手間を気にせず効果で選ぶようAIへ伝えます。残り時間に応じた方針の切り替えは、人間が担います。私はどちらもできていませんでした。AIが効果を小さく見積もったlibjpeg-turboへの置き換えは、14:20のプロファイルで根拠がそろってからも、15:35に私が指示するまで後回しのままでした。asia1のCPUを理由にAIが見送ったDBの読み取りの分離は、そのまま受け入れていました。15:00の指示では遅く、16:50には大きな変更に使える時間がもうありませんでした。
4.8 事前の準備と練習が足りなかった
私は、当日の最初の1時間で準備を整えました。しかし、デプロイ・ベンチマーク・計測をまとめて実行するコマンドや、ルールのファイルは、開始前に用意できます。
1位と3位のチームは、練習に大きく投資していました。1位は3か月の準備で100回以上の練習を重ね1、3位は練習でのベンチマーク実行が合計1,500回に及んでいます3。過去問をAIに解かせ、その結果でハーネス(AIに任せるための指示・道具・仕組みの一式)を磨いていました1,3。
一方で、チーム54(4位)は1人で参加し、当日その場で書いたCLAUDE.mdのほかは、専用の仕組みを用意しないまま、463,946点を出しています4。このチームでは、11:10の人間の発言をきっかけに、全リージョンにDBを置く方向へ進んでいました4。準備や作り直しの有無より、構成の方向を早く決めたかどうかが効いたと考えられます。
また、サーバー上には、AI向けの偽の指示とみられるものがありました。2.1節の AGENTS.md や、スキーマのSQLにあった、画像の置き場所を制限するコメントなどです11。私は当日 AGENTS.md をAIに書き換えさせましたが、こうした指示の扱いは事前に決めておくとよいでしょう。
4.9 次回やること
ここまでの反省から、次回やることを優先順に並べます。
- ベンチマークの投入から結果の回収までをAIができるようにし、ベンチマーク中はデプロイできないようロックする
- 開始30分で、得点の仕組みと環境の一覧をAIにまとめさせる。その制約から構成案を複数出させ、人間は問いかけで方向を検証し、午前中に構成の方針を固める
AGENTS.mdには、「守る線」だけでなく「攻める線」も具体的に書く(例: 変更ログで永続化すればデータをメモリに持ってよい、構成の作り直しも選択肢に入れる、実装時間は考えなくてよい)- 午前中は作り直しから入る。改善の前に仕様を書き出させ、別のセッションやサブエージェントで、初期実装を見せずに作り直させる
- 初期実装と応答を比べる差分テストを用意し、大きな作り直しでも壊していないことを確かめられるようにする(2位のチームは、新旧の実装に同じリクエストを送って応答を比べるツールを用意していた2)
- 過去問で、本番と同じ体制の通し練習をする
AIに全体の設計の方向を考えさせる問いかけやルールを用意し、時間の配分を管理することは、人間の役割として残ります。そのうえで、AIが自分で回り続けられるハーネスを事前に作っておくことが、次の課題です。
5. 得られた知見と共有したいこと
5.1 AIの使いこなしには、まだ研鑽が必要だと感じた
今回、準備や定番の改善はAIで大きく効率化できました。それでも、上位との差を見ると、AIの使いこなしにはまだ研鑽が必要だと感じています。
今回1位になったチームは、ハーネスを作り込んで勝ち切っていました1。ハーネスが整っていれば、AIの力をそのまま得点に変えられます。適切なハーネスを組める技術や力の大事さを、改めて痛感しました。
5.2 ハーネスが不完全なうちは、自分の技術力が生きる
ハーネスを作り切れていない段階では、AIに観点を渡して方向を考えさせたり、AIをコントロールしたりする必要があります。そこで生きるのは、やはり自分自身の技術力です。構成の方針の良し悪しを見極める力や、AIの判断に「待った」をかける力がそれに当たります。
5.3 実際のプロダクトでのパフォーマンスチューニングの敷居は下がった
逆に言えば、AIを使いこなせれば、実際のプロダクトでパフォーマンスチューニングに取り組む敷居は大きく下がっています。計測の仕組みづくりやデプロイの自動化といった準備は、AIがすぐに整えます。ただし、競技と本番は分けて考えます。データの永続性や権限の範囲を緩めるやり方は、本番には持ち込めません。本番では4.4節の「守る線」を優先し、「攻める線」は検証環境で使います。今回の経験を生かし、実際のプロダクトでもパフォーマンスチューニングを積極的に進めていきたいと考えています。
5.4 ぜひISUCONに挑戦してほしい
上位を目指すなら研鑽が必要なことは、AIがあっても変わりません。それでも、勝てない、上位の成績を出せないからと参加を見送るより、出場してAIと一緒にスコアを伸ばす体験を楽しんでほしいです。AIのおかげで最初のステップでつまずきにくくなり、振り返りもしやすくなりました。ISUCONは、以前より楽しみやすい競技になったと言えます。
この記事を書きながら、改めてスコアが上がった瞬間の嬉しさを思い出していました。ぜひ、多くの方にISUCONへ挑戦してほしいと思います。
おわりに
AIによって、ISUCONの序盤の風景は大きく変わりました。準備にかかっていた時間が改善の時間に変わり、自分の力以上の改善にも手が届きます。
一方で、どの方向に進むかをAIに考えさせる問いかけや仕組みの用意は、現段階ではまだ人間の担う部分が大きいと考えています。次回は、得点の仕組みと環境の制約からAIに構成案を複数出させ、人間は問いかけで方向を検証する形で臨みます。AIを活用しつつ、幅広い知見をもとに判断できるよう、技術力をさらに高めていきます。
ISUCON2026は、AIがあるからといって勝てるものでもない、絶妙な難易度の問題でした。楽しい時間を過ごさせてくれた運営の方々への感謝を込めて、この記事を締めたいと思います。素晴らしい大会をありがとうございました!
参考文献
本文で参照した参加記です。いずれもISUCON2026 関連エントリーまとめに掲載されています。番号は本文での引用順です。本文の脚注の番号と対応しています。かっこ内は、公式の結果でのチーム名(長いものは略称)と順位です。閲覧日はいずれも2026年11月17日です。
- Yoshinori Kawasaki「ISUCON2026 で優勝しました(当日編)」Zenn、2026年11月2日公開、https://zenn.dev/luvtechno/articles/isucon2026-competition-day(Typing Bears、1位)
- ichyo「ISUCON2026 準優勝 参加記」ichyo::blog、2026年11月3日公開、https://blog.ichyo.jp/posts/isucon2026(ゲームセンターヤギ、2位)
- mineo「ISUCON2026で『あとで』チームとして出場して3位になりました」mineoの技術ブログ的な何か、2026年11月6日公開、https://mineo-engine.com/posts/20261106-isucon2026/(あとで、3位)
- goccy54「ISUCON2026 で 4位でした」Route54、2026年11月3日公開、https://goccy54.hatenablog.com/entry/2026/11/03/172808(54、4位)
- qitoi「中間管理職 Claude Code の ISUCON2026 参戦記」Zenn、2026年11月5日公開、https://zenn.dev/qitoi/articles/isucon2026-claude-code(q、26位)
- 末永洸介「ISUCON2026 出場記(18位)」DevelopersIO、2026年11月3日公開、https://dev.classmethod.jp/articles/isucon2026-suekou/(suekou、18位)
- ponyo877「Human-out-of-the-loop(もどき)で戦うISUCON2026 (301,558 点 | 12 位)」Zenn、2026年11月2日公開、https://zenn.dev/ponyo877/articles/2a8a24acc2ea3b(ちゃん、12位)
- TAK848「ISUCON2026に人間1人+AIエージェント軍団で出て19.6万点、ループは閉じたけど中身が弱かった反省文😇」Zenn、2026年10月31日公開、https://zenn.dev/tak848/articles/20261031-isucon2026-writeup(tak、48位)
- morishin「ISUCON 2026 感想 (134,946点)」blog.morishin.me、2026年10月31日公開、https://blog.morishin.me/posts/2026/10/31/isucon2026(チェリーバーガー、111位)
- tatsumack「ISUCON2026に参加して78位でした」ミラティブ Engineering(Zenn)、2026年11月4日公開、https://zenn.dev/mirrativ_blog/articles/96f92fb2c8f01e(カレーおじさん、78位)
- iwamot「Claude Code自身によるISUCON2026参加記(チームiwamot)」iwamot’s blog、2026年11月1日公開、https://blog.iwamot.com/articles/isucon2026/(iwamot、事後検証NGで順位の対象外)
- mazrean「ISUCON2026 にツールを捨てて勝ちたかった」Zenn、2026年11月1日公開、https://zenn.dev/mazrean/articles/5c968503fd69a3(INUCON2026、44位)
- a-thug「3 人それぞれの Claude Code を Slack でつないで ISUCON2026 に参加した(207,039 点)」カウシェ Tech Blog(Zenn)、2026年10月31日公開、https://zenn.dev/kauche/articles/f3736c660aab77(いくぜカウシェ、39位)
- ぷらす「ISUCON2026 で Agent のハーネスを作って 6 位になりました (449,294 点)」ぷらすのブログ、2026年11月4日公開、https://blog.p1ass.com/posts/isucon2026/(釜中の鯖、6位)
※ カバー画像は、ISUCON2026のポータルのベンチマーク結果画面をもとに作成しています。アバターやチームIDなどはぼかしています。
※「ISUCON」は、さくらインターネット株式会社の商標または登録商標です。
※ 記載されている会社名、製品名、サービス名は、各社の商標または登録商標です。