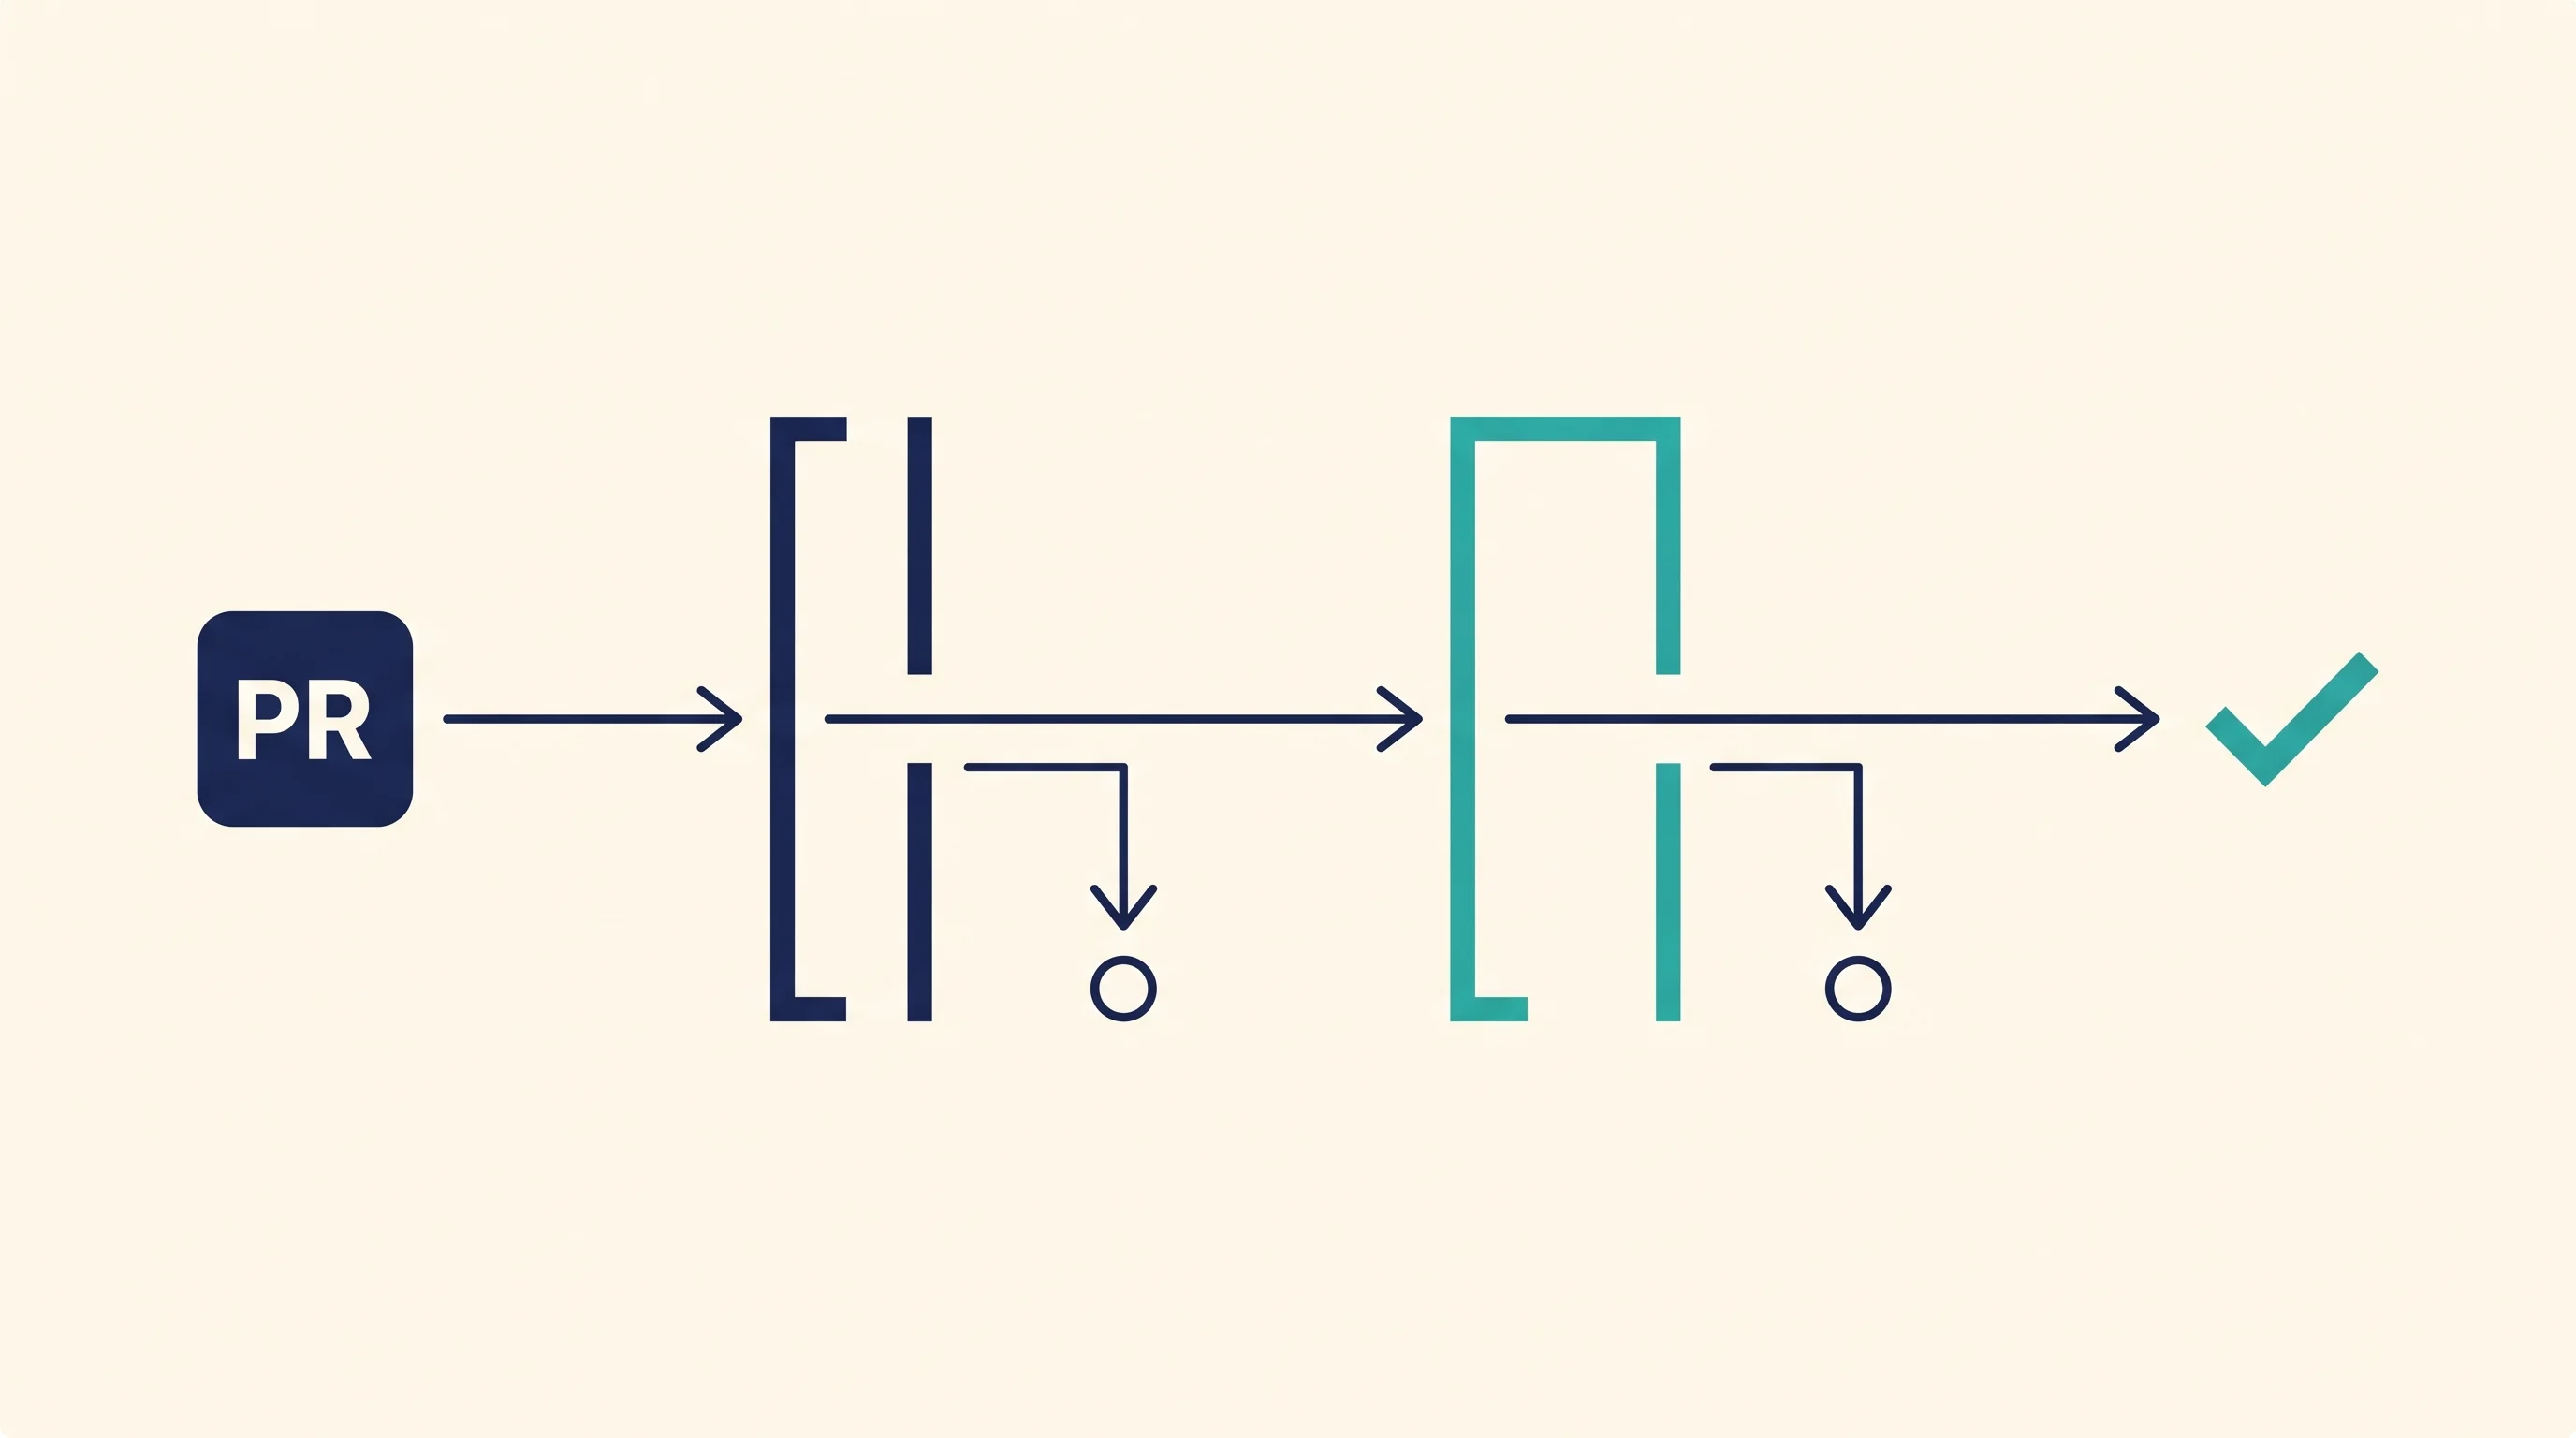
はじめに
テストカバレッジのゲートを3つのサイトに入れた記録です。
同じドメインで連携する3つのNext.jsサイト(利用者向け / 提供者向け / 社内管理画面)を運用しています。カバレッジを測る設定は、利用者向けでは5月、社内管理画面では6月から入っていました。ただし閾値もCI連携もなく「測れるが誰も追っていない」状態でした。提供者向けでは、計測とゲートを同じ日に入れています。
半期の計画でカバレッジ向上に取り組むことが決まり、まず現状を測るところから始めました。
実測したところ、社内管理画面は テストが2441個あって、カバレッジ9.5% でした。この数字を前にして「まず全体80%を目指そう」と言っても、誰も動きません。
そこで全体の数字を目標にするのをやめ、「変更した行」だけを見るゲートに切り替えました。
この記事で得られること
- テスト数とカバレッジが比例しない理由と、計測対象の決め方
- 全体のカバレッジをゲートにすると何がうまくいかないか(未使用コードを消すと率が下がる問題)
- 変更した行のカバレッジをゲートにする設計と、全体の数字をこれ以上下がったら止める「下限」として使う考え方
- 外部のカバレッジサービスを使わず、CI内で完結させる実装
- 計測から外すファイルを決めないと数字が実態とずれる話
- 既存コードの多いリポジトリで、止めずにゲートを入れる段階の踏み方
1. 3サイトのカバレッジ実測値
まず現状を測りました。CIと同じ環境変数で、全テストが通る状態での実測値です。
| Lines | Statements | Functions | Branches | テスト規模 | |
|---|---|---|---|---|---|
| 社内管理画面 | 9.5% | 9.5% | 7.1% | 8.4% | 176ファイル / 2441テスト |
| 利用者向け | 26.8% | 26.3% | 20.0% | 24.2% | 70ファイル / 908テスト |
| 提供者向け | 34.3% | 34.5% | 28.9% | 32.1% | 45ファイル / 625テスト |
目を引くのは社内管理画面です。テストが一番多いのに、カバレッジが一番低くなっています。
テストの数とカバレッジが比例しない理由
原因はテストの置き場所が偏っていたことでした。導入時のコミットで測り直し、テストと計測対象の行を突き合わせると、こうなっていました。
| |
テストの半分以上が入力チェックの定義に集まっていました。定義は1つが数行にまとまるので、計測対象の行数では143行、全体の1%もありません。一方、計測対象の7割以上を占める画面のコンポーネントは、ほとんどテストで実行されていませんでした。
自動生成されたAPIクライアントのテストは、生成したスキーマを読み込めるかを確かめるだけのものです。自動生成コードは計測対象から外してあるので、これも全体の率には効きません。
「テストを書けばカバレッジが上がる」は、テストが計測対象の多くの行を実行するときだけ成り立ちます。
ここで学んだのは、カバレッジを語る前に、何を計測の対象にしていて、テストがその中のどこを実行しているかを確かめることです。対象の定義を知らないまま数字を比べても意味がありません。後の「6. 計測から外すファイル」で詳しく書きます。
「測れるが誰も追っていない」状態
計測の設定が入っていた2サイトでは、カバレッジのレポートを生成できました。ローカルで pnpm test:coverage を実行すれば数字は出ます。
しかし誰も見ていませんでした。
- 閾値がないので、下がっても気づかない
- カバレッジはローカルで測れるだけで、CIでは測っていない
- そもそも「何%あるべきか」が決まっていない
計測基盤を入れた時点で満足して止まってしまうのは、よくあることです。測ることと追うことは別です。
2. 全体のカバレッジを目標にしたときの問題
最初に検討したのは、素直に閾値を置く案でした。「全体で80%」のような絶対値をCIのゲートにします。
これはうまくいきません。理由が3つあります。
既存コードの穴埋め
9.5%のリポジトリへ「80%」を課すと、まず70ポイント分の既存コードにテストを後から書く作業が発生します。以降これを「穴埋め」と呼びます。
機能開発を止めて穴埋めをする期間が要ります。しかも穴埋めで書くテストは、仕様を知らないコードに対して「いまの挙動を固定する」だけのテストになりがちです。リファクタリングの邪魔になるテストが大量に生まれます。
現実にはこうなります。
| |
既存コードの量に閾値を引きずられると、設定できる値が「意味のない低さ」になります。
未使用コードの削除
これが一番理不尽な挙動です。
使われていないコードを削除したとします。そのコードにテストがなかった場合、分母が減って分子は変わらないので、率は上がります。逆に、テストが書いてあるコードを消すと率は下がります。
つまり、よく整備されていた部分を消すほどカバレッジが悪化します。掃除をするとゲートに落ちる、という状態になります。
実際、前期に未使用コードを棚卸ししたとき、削除の前後でカバレッジを計測すると、率が下がっていました。「消しただけなのに」となった場面です。全体のカバレッジをゲートにしていたら、閾値によってはこの削除のPRが落ちていたはずです。
数字合わせ
全体のカバレッジをゲートにすると、率を上げやすい場所からテストが書かれます。
| |
率を上げるだけなら前者で十分です。しかしバグが出るのは後者です。
ゲートが「数字を上げること」を要求すると、数字は上がるが品質は変わらないという結果になります。これは個人の良心の問題ではありません。仕組みがそう誘導するからです。
3. 「変更した行」だけを見る
採った方式はPRで変更した行のうち、テストで実行された行の割合を80%以上にすることです。
全体の数字は見ません。そのPRで触った行だけを見ます。
この方式が動く理由
9.5%のリポジトリでも、今日出すPRの変更した行なら80%にできます。既存コードの量は関係ありません。
| |
同じPRでも、どちらを見るかで判定が変わります。
flowchart TD
    P["今日のPR(例)<br/>変更した30行のうち24行がテストで実行される"]
    P --> A["全体のカバレッジで判定する"]
    P --> B["変更した行だけで判定する"]
    A --> A1["リポジトリ全体は 9.5%<br/>閾値 80% に届かない"]
    A1 --> A2["落ちる<br/>通すには既存コードの穴埋めが先に要る"]
    B --> B1["24 / 30 = 80%"]
    B1 --> B2["通る<br/>今日のPRの中だけで判定が終わる"]
全体のカバレッジで判定すると、今日書いたコードの質と関係なく落ちます。落ちる理由が過去のコードの量にあるので、PRを出した人には直しようがありません。変更した行だけを見れば、判定は今日のPRの中で完結します。
2章の3つの問題
2章で挙げた3つが、そのまま解決します。
| 全体のカバレッジをゲートにした場合の問題 | 変更した行のゲートではどうなるか |
|---|---|
| 既存コードの穴埋めを強制する | 強制しない。触らなければ対象外 |
| 未使用コードを消すと率が下がる | 下がらない。削除行はカバレッジの対象にならない |
| テストしやすい場所にテストが偏る | 偏らない。書いた場所にしかテストを求められない |
3つ目の違いが特に大きいです。変更した行は、自分が今まさに書いた行です。仕様を知っているので、意味のあるテストが書けます。率を上げるために別の場所を探す動機が生まれません。
ただし、5章で書く全体の下限は、テストのあるコードをまとめて消すと下がります。下限は実測の2〜3ポイント下に置くので、通常の掃除では止まりません。大きな削除で止まったときは、同じPRで下限を下げ、その理由をレビューで説明すれば通せます。
既存の負債の扱い
この方式で大事なのは「既存の技術的負債を、今日の開発者に請求しない」ことです。
カバレッジ9.5%という数字は、何年もかけて積み上がったものです。それを今日PRを出す人の責任にしても、何も改善しません。今日足すものを汚さないことだけを要求すれば、時間とともに全体も上がります。
ただし、全体を短期間で上げるのはこのゲートの仕事ではありません(8章)。
4. 採らなかった2つの案
方式を決める前に3案を比較しました。
| 方式 | 新しいコードの質 | 既存の負債 | 数字合わせ | 外部への送信 | 判定 |
|---|---|---|---|---|---|
| 全体のカバレッジに高い閾値 | ○ | ✕ 穴埋めを強制 | ✕ テストしやすい場所に偏る | なし | 不採用 |
| 変更した行で判定し、全体は急落したときだけ止める | ◎ | ○ 罰しない | ○ 触った行のみ | なし | 採用 |
| 外部のカバレッジサービス | ◎ | ○ | ○ | ✕ 外部送信と社内の確認 | 不採用 |
真ん中の「変更した行で判定し、全体は急落したときだけ止める」方式を選択しました。1つ目を採らなかった理由は2章で書いたとおりなので、ここでは3つ目について書きます。
外部のカバレッジサービスを使わなかった理由
Codecovのような外部サービスを使うと、変更した行のカバレッジは設定だけで手に入ります。PRにコメントも付きます。機能だけ見れば一番良い選択肢です。
それでも使いませんでした。理由は2つあり、どちらもコードの情報を外部へ送ることに関わります。
1つ目は社内の確認です。外部サービスにコードの情報を送る場合は、情報の取り扱いについて社内の確認を受けます。コードを置いているGitHubの外へデータを送らない構成にすれば、この確認は要りません。確認を待たずに、すぐ始められます。
2つ目は外部へ送る情報の範囲を説明できる必要があることです。カバレッジのレポートにはファイルパスと行番号が入ります。これ自体は深刻な情報ではありませんが、「何を送っているか」を聞かれたときに答えられる状態を保つ必要があります。自前で完結していれば、この説明が要りません。
自前で完結させる方法
調べたところ、Codecovのような外部サービスを追加で利用しなくとも、同じことができると分かりました。
| |
つまりレポートとGitの差分を突き合わせるだけで、コードを置いているGitHubの外へは、レポートもコードも送らずに、変更した行のカバレッジが出ます。
決め手は、機能が同じなら手続きの要らないほうを採ることでした。
5. 実装
前提の環境
導入時(2026年7月)の構成です。その後、pnpmは10系に、Node.jsは24系の新しいパッチに上げています。
| 実行環境 | GitHub Actions(runs-on: ubuntu-latest) |
| Node.js | 24.11.1 |
| パッケージ管理 | pnpm 9.15.9 |
| テスト | Vitest 4.1.4 と @vitest/coverage-v8 4.1.4 |
| 変更した行の評価 | diff-cover 10.3.0(Python 3.12) |
| CI のアクション | actions/checkout@v4、actions/setup-python@v5 |
actions/checkout@v4 と actions/setup-python@v5 は、Node.js 20で動くアクションです。下の例では、Node.js 24に対応した actions/checkout@v5、actions/setup-python@v6 にしています。
カバレッジの計測にはVitestのv8プロバイダを使っています。Istanbulでも同じ設計で動きます。
2つの部品
flowchart TD
    A["PR を出す"] --> B["テストを実行し<br/>カバレッジのレポートを生成"]
    B --> C{"全体のカバレッジが<br/>下限を下回ったか"}
    C -->|下回った| X["落とす<br/>急落を検知した"]
    C -->|下回っていない| D{"変更した行の<br/>カバレッジが 80% 以上か"}
    D -->|80% 未満| Y["落とす<br/>今日足した分にテストがない"]
    D -->|80% 以上| Z["通す"]
全体の下限が先に働き、変更した行の評価が後に働きます。前者は「大きく壊れていないか」、後者は「今日足した分がきれいか」を見ます。落ちる条件が違うので、落ちたときにどちらで落ちたかがすぐ分かります。
5-1. 変更した行の評価
GitHub Actionsのステップとして追加します。
| |
つまずいた点を3つ書きます。
1つ目は fetch-depth: 0 です。GitHub Actionsのcheckoutは既定で最新の1コミットしか取りません。差分を取るにはbaseブランチが必要なので、全履歴を取得する設定に変えます。これを忘れると、比較対象のブランチが見つからないというエラーで落ちます。
2つ目はレポートの形式です。たいていは新しい形式を足す必要はありません。diff-coverはXML(Cobertura等)と lcov.info の両方を読めます。コマンドのヘルプにも coverage report (XML or lcov.info) とあります。Vitestのルートがリポジトリ直下で、すでに lcov を出しているなら、そのまま渡せます。ただし、lcovとCoberturaでは数える行の範囲が少し違うので、同じテストでも率はずれることがあります。
今回Coberturaを足したのは、後から --branch-coverage を使えるようにするためです。分岐が一部しか実行されていない行を、実行されていない行として数えるオプションで、diff-cover 10.4.0で追加されました。上の例で固定している10.3.0にはないので、使うときは10.4.0以降に上げます。ヘルプの説明は次のとおりです(diff-cover 10.4.0の --help より)。
| |
つまりCoberturaが要ります。使う予定がなく、Vitestのルートがリポジトリ直下なら、lcov のままで足ります。
3つ目は結果を見える場所に出すことです。落ちた理由がログの奥にあると誰も読みません。$GITHUB_STEP_SUMMARY に書き出すと、Actionsの実行結果の画面に表示されます。どのファイルの何行目が足りないかが一覧で出ます。PRの画面にも出したいなら、--format markdown:diff-cover.md,github-annotations:warning のように並べて指定します。テストで実行されていない行が、PRの差分の画面(Files changed)に注釈として出ます。1つのステップで出せる注釈の数には上限があります。
set +e で一度終了コードを受け止めているのは、落ちた場合でもレポートを出すためです。そのまま落とすとサマリーが書かれません。
5-2. 全体の下限
全体のカバレッジは目標ではなく下限として使います。「ここまで下がったら止める」という使い方です。
次の設定は利用者向けサイトで下限を引き上げた時点(2026年9月)のものです。
| |
設定した値は実測値を整数に切り捨てて2を引いたものです。この例では実測の2.45〜2.8ポイント下になります。目標ではないので、低く設定します。
この数字の意味はこうです。
| |
「下がらないこと」だけを保証します。上げるのはこのゲートの仕事ではありません。
reportOnFailure: true は、テストが失敗したときでもカバレッジのレポートを生成する設定です。
ただし、GitHub Actionsではテストのステップが失敗すると、後続のステップは既定でスキップされます。上の例の変更した行の評価も、テストが落ちたときは動きません。テストが落ちたときも変更した行を評価したいなら、Setup Pythonと変更した行の評価の両方のステップに if: ${{ !cancelled() }} を付けます。評価のステップにだけ付けると、Setup Pythonで固定したPythonではなく、ランナーにもともと入っているPythonで動きます。
5-3. 下限を引き上げる
下限は固定の値なので、全体のカバレッジが上がるほど実測との差が開きます。差が開くと、急落しても下限に届かず、止まりません。
手順は develop で全テストを実行して実測値を取り、整数に切り捨てて2を引いた値を設定するだけです。実測は実行ごとにわずかにぶれます。社内管理画面では0.02ポイントほどぶれたので、2回測って低いほうを基準にしました。
6. 計測から外すファイル
計測から外すファイルを決めないと、カバレッジは信用できない数字になります。
計測の対象をこう指定しています。
| |
include に入らないファイル(App Routerの src/app/** など)と、exclude で外したファイルは、カバレッジのレポートに出てきません。diff-coverはレポートにないファイルを評価しません。そのため、これらのファイルの変更は、テストがなくても変更した行の評価を通ります。
外しているもののうち、判断が要る2つについて書きます。
自動生成コードを外す
src/gen/** はAPIのスキーマから自動生成しているクライアントです。
人が書いていないコードに、人がテストを書く意味がありません。生成器が正しければ出力も正しく、間違っていればテストも生成器の出力に引きずられます。
ここを含めると、カバレッジの意味が変わります。自動生成コードは型定義と、APIを呼び出すだけの関数です。テストから少し呼び出すだけで、大量の行がテストで実行された扱いになります。計測の対象に入れると「数字は高いが実質は空」という状態を作れてしまいます。
export をまとめるだけの index ファイルを外す
src/**/index.{ts,tsx} を外しています。狙いは他のファイルのexportをまとめているだけのファイルです。
| |
ここにはロジックがありません。どこかからimportされれば自動的に実行されるので、意図せず「テスト済み」に数えられます。
外さないと、テストを書いていないのにカバレッジが上がるので、数字が実態より良く見えます。また、indexファイルを整理したときに率が動いて、原因が分からなくなります。
ただし、このパターンは名前だけで外すので、処理を持つindexファイルも外れます。私たちの3サイトにも、components/Editor/index.tsx のように、画面の処理を持つindexファイルがあり、計測から外れていました。真似するなら、indexファイルに処理を置かない約束と組み合わせるか、外すファイルをもっと狭く指定してください。
もう1つ注意したいのは、indexファイルにテストを書いてもカバレッジにはまったく寄与しないことです。テストを足す対象を選ぶときに、ここを選んでしまうと空振りします。実際に一度やりました。レポートに出てこないファイルは計測対象外、と覚えておくと間違えません。
外す基準
迷ったときの判断はこうしています。
| |
最後の行が大事です。「テストしにくいから外す」を許すと、計測の意味がなくなります。テストしにくいところほどバグが出ます。
7. 止めずに始める
既存のリポジトリにゲートを入れるとき、いきなりCIを落とすようにすると開発が止まります。
段階を分けました。
| |
第1段階:変更した行は結果だけ出す
全体の下限は実測値より下に置くので、通常のPRでは止まりません。最初から有効にしても邪魔になりません。むしろ最初から入れておくと、「下がったら止まる」という事実がチームに伝わります。
変更した行の評価は落ちてもCIを通すようにします。
GitHub Actionsには continue-on-error: true という設定があります。ステップが失敗してもジョブを止めません。
| |
この状態で1〜2週間回すつもりでした。目的は2つです。
1つ目は実際の数字を見ることです。「変更した行で80%」が現実的かどうかは、やってみないと分かりません。全PRが赤になるようなら閾値を見直します。
2つ目は仕組みの不具合を直すことです。つまずくのは比較対象の取得、レポートの生成タイミング、Pythonの用意です。第2段階に進んでから不具合が出ると、関係ない人のPRが落ちます。
この段階では、サマリーにファイルごとの行が出ていることを確かめてください。気づきにくい不具合が2つあります。
まず、上の例のYAMLは、レポートが見つからない場合や比較対象のブランチがない場合もチェックが緑になります。continue-on-error を付けているので、サマリーが空のまま通ります。
もう1つは、レポートのパスとGitの差分のパスがずれている場合です。lcovはVitestのルートからの相対パスで書かれるので、モノレポのサブディレクトリでVitestを動かすとずれます。Coberturaは、サブディレクトリでVitestを動かし、さらにテストとdiff-coverを別の絶対パス(Dockerコンテナの中など)で動かすとずれます。ずれると、diff-coverは「No lines with coverage information in this diff.」と出して100%を返すので、すべてのPRが通ります。
実際には、第2段階に進んだのは約2か月後でした(8章)。
第2段階:CIを落とし、下限を引き上げる
安定したら continue-on-error を外します。同じタイミングで、全体の下限を実測に合わせて引き上げます(5-3)。
continue-on-error を外すだけでは、CIが赤くなってもマージはできます。マージを止めたいなら、ブランチ保護かルールセットで、このジョブを必須のステータスチェックに設定します。
また、pull_request で動くワークフローは、PR自身のワークフローと vitest.config.ts を使います。同じPRで閾値を下げたり評価のステップを消したりすれば、ゲートを通れてしまいます。こうした変更を見落とさないよう、vitest.config.ts、.github/workflows/、package.json をCODEOWNERSの対象とします。そのうえで、ルールセットでコードオーナーのレビューを必須にします。CODEOWNERSのファイルを置くだけでは、レビュアーが自動で指名されるだけで、レビューは必須になりません。ソースに書く /* v8 ignore next */ のようなコメントでも、その行はレポートから消えて評価されなくなるので、これもレビューで見ます。
ここで決めておくべきなのは、落ちたPRをどうするかです。
| |
採ったのは前者です。設定ファイルやドキュメントだけの変更は計測対象の外なので、評価されません。一方、緊急の修正でも、画面やフックの既存のコードを直すならテストが要ります。そのコードがテストしにくいと、テストを足すのに時間がかかります。
フォーマッタの一括適用や、コンポーネントの分割のようにコードを動かすPRでも詰まります。テストのない既存の行まで「変更した行」に数えられ、率が全体の値へ近づいて落ちるからです。こうしたPRの扱いは第2段階へ進む前に決めておくと詰まりません。PRを分けるだけでは、分けたPRもテストのない既存の行に触れるので落ちます。機械的な変更だけを別のPRに分け、そのPRではdiff-coverの --exclude で対象のファイルを外します。マージしたら、すぐに --exclude を外すPRを出します。空白だけの変更なら、--ignore-whitespace で差分から外すこともできます。
--exclude を使う場合、diff-cover 10系ではパターンがファイル名と絶対パスにしか照合されません。src/components/Editor/* のようにリポジトリからの相対パスで書くと、何も外れず警告も出ません。10系では */src/components/Editor/* のように先頭に */ を付けるか、相対パスで書ける11.0.0以降を使います。
8. 16日後の数字と第2段階に進むまで
入れた時点と、その16日後の実測値です。Linesの値です。
| 導入時 | 16日後 | 差 | |
|---|---|---|---|
| 社内管理画面 | 9.5% | 32.2% | +22.7pt |
| 利用者向け | 26.8% | 55.6% | +28.8pt |
| 提供者向け | 34.3% | 65.5% | +31.2pt |
16日間で上がった理由
正直に書いておくと、この上昇はゲートの成果ではありません。上がったのは、並行して進めたカバレッジ向上の計画によるものです。
しかも16日後の時点では、ゲートは数字を支えられる状態ではありませんでした。
- 変更した行の評価は結果を出すだけ(
continue-on-error: true)で、80%を割ってもCIは通っていた - 全体の下限は導入時の値のままで、実測より24〜34ポイント低かった
第2段階に進むまでの約2か月
この状態を直すため、2026年9月10日に実測し、9月14〜17日に3サイトで変更を入れました。変更した行が80%を割るとCIが落ちるようにし、全体の下限を実測に合わせて引き上げました。Linesの値で比べるとこうなります。
| 導入時の下限 | 9月10日の実測 | 引き上げた下限 | |
|---|---|---|---|
| 社内管理画面 | 8% | 39.75% | 37% |
| 利用者向け | 24% | 56.64% | 54% |
| 提供者向け | 32% | 65.91% | 63% |
導入時の下限は目安で置いたもので、3サイトで決め方がそろっていませんでした。引き上げるときに、今の決め方(整数に切り捨てて2を引く)にそろえています。
第1段階を終える日と、下限を引き上げる日を、ゲートを入れる時点で決めておくべきでした。真似するときは、この2つの日付を先に決めておくことをおすすめします。
ゲートに期待している役割は、上げた分を下げないことと、上げる作業の途中で新しい穴を開けないことです。
| |
体感として変わったこと
数字以外で変わったことが2つあります。
1つ目は、第2段階に進んでから、レビューで「テストは?」と聞かなくなったことです。変更した行が80%を割るとCIが落ちるため、人から言う必要がなくなりました。地味ですが、指摘する側の心理的な負担が消えるのは大きいです。
2つ目は、テストを書く場所の相談が減ったように感じることです。「どこに書けばいいか」に対して、変更した行が答えになるからです。件数は数えていないので、あくまで実感です。
9. この方式が向かない場合
新規のプロジェクトには向きません。最初から全体で高い数字を保てるなら、全体のカバレッジをゲートにするほうが素直です。変更した行のゲートは「既存の負債が大きい」ことを前提にした設計です。
変更が極端に少ないリポジトリでも役に立ちません。PRが月に数本しかないなら、変更した行のゲートはほとんど働きません。全体の数字を上げたいなら、別の方法が要ります。
1つのPRで変更した行が極端に少ない場合、数字が荒れます。3行を変更し、そのうち2行しかテストで実行されていなければ、66%(2/3)で落ちます。diff-cover 10.6.0以降には --minimum-change があり、変更した行のうちカバレッジのレポートに載る(計測対象の)行の数がその数未満なら、常に通すようにできます。テストやドキュメント、計測から外したファイルの行は数えません。荒れるようなら、diff-coverを上げてこのオプションで調整します。
まとめ
- テストの数とカバレッジは比例しない。何を計測の対象にしていて、テストがその中のどこを実行しているかを先に確かめる
- 全体のカバレッジをゲートにすると、既存コードの穴埋めを強制し、掃除をすると率が下がるという理不尽が起きる
- 変更した行だけを見れば、9.5%のリポジトリでも今日から80%を要求できる
- 外部のカバレッジサービスを使わなくても、レポートとGitの差分を突き合わせればCI内で完結する。コードを置いているGitHubの外へデータを送らないので、外部サービスにデータを送る場合の確認は要らない
- 全体の数字は「目標」ではなく、これ以上下がったら止める「下限」として使う。実測値を整数に切り捨てて2を引いた値に置き、急落だけを検知する。全体が上がったら下限も引き上げる
- 計測から外すファイルを決めないと、数字が実態とずれる。自動生成コードと、exportをまとめるだけのindexファイルは外す
- いきなりCIを落とすようにしない。まず結果を出すだけにして、仕組みの不具合を先に直す。ただし第2段階に進む日は最初に決めておく
記載されている会社名、製品名、サービス名は、各社の商標または登録商標です。