frontend testing

QA フェーズを起点に、Next.js のテスト基盤をゼロから設計した話 — Playwright × Vitest × Sentry

QAフェーズへの移行を機に、後回しにしていたテスト基盤を一気に整備した記録です。 同じドメインで連携する3つのNext.jsサイト(利用者向け/提供者向け/社内管理画面)を並行開発し、リリース前のQAに突入したものの、モンキーテストで予想を超えるバグが多発しました。 修正のたびに3サイト全画面を手動で再確認することになり、1サイクルあたり30分〜1時間かかりました。本来テストシナリオ作成に充てるはずだった1週間がバグ修正で埋まりました。 そこでE2Eテスト(Playwright)・コンポーネントテスト(Vitest)・本番エラー監視(Sentry)を 半日で一気に導入 しました。 この記事では、Next.js App Router + TanStack Query + MSW という構成で、ツール選定から実装・CI統合までの過程を解説します。あわせて、SSR / Turbopack固有のハマりポイントと、AIでテストを量産する際の落とし穴も共有します。 この記事で得られること Next.js App Routerで Playwright + MSW を動かすためのSSR対応パターン MSW ハンドラーを E2E と Vitest で共有する設計(モックの二重管理を防ぐ) E2E / Vitest / 手動テストの 仕分け基準(テストピラミッドの設計) Sentryを Next.js 16 + Turbopack で動かす際のハマりポイントと解決策 Sentryの 3層防御マスキング設計(SDKフック / Server-side Scrubber / Generative AI機能停止) ソースマップを Sentry にアップロードしない という運用選択肢とそのトレードオフ AIでテストを量産する際の「成功するテストしか作らない」問題と対策 動作確認環境 種別 バージョン OS macOS 15.x Node.js 24.x パッケージマネージャー pnpm 10.x Next.js 16.x(Turbopack) React 19.x @playwright/test 1.58.x vitest 4.x msw 2.x @sentry/nextjs 10.x @tanstack/react-query 5.x 1. 背景: 手動テストだけでは回らなくなった瞬間 3つのNext.jsサイト(利用者向けサイト/提供者向けサイト/社内管理画面)を約10名のチームで半年かけて並行開発しました。 ...
2026年5月12日 · 読了時間: 12分 · 福士宗介
「FRONTEND ACCESSIBILITY」のサブタイトルと「WCAGとWAI-ARIAの基礎とアクセシビリティ計測」のタイトルテキストが書かれたカバー画像

フロントエンドが押さえたいWebアクセシビリティの基礎 ── WCAG・WAI-ARIAを実プロダクトで試す

はじめに こんにちは。and factory フロントエンドエンジニアの坂内です。 4月の個人テーマとして、Webアクセシビリティ(WCAG・WAI-ARIA)の基礎を調べ、自社プロダクトで計測まで試したので共有します。 「アクセシビリティは大事」と聞くものの、何から手をつければよいか分からないと感じるエンジニアは多いはずです。本記事はフロントエンドの実装視点で、まず押さえておきたい範囲に絞ってまとめました。 結論 先に持ち帰ってほしいポイントを3つに絞ります。 実務の目標ラインはAAレベル準拠(JIS X 8341-3:2016もWCAG 2.0と同内容のため、AAが事実上のスタンダード) 大原則は「No ARIA is better than Bad ARIA」で、<button> を使えばロール・キーボード操作・フォーカスがすべて自動で揃う 自社プロダクト4ページの横断計測の平均は93点(自動検査の範囲)で、指摘はselectのラベル不足とコントラスト比不足が中心、修正コストも小さい 詳細を順番に説明します。 調査の背景 私が担当しているプロダクトは占いコンテンツのWebサービスです。複数ページで同じ <select> やドロップダウンが繰り返し登場するため、共通コンポーネント越しにUIを組み立てる構成です。 フロントエンドの実装では、<div> や <span> だけでUIを組む場面が増えました。Reactなどのライブラリでカスタムコンポーネントを作る場合、見た目はモーダルやドロップダウンに見えても、HTML上は意味を持たないただの箱になりがちです。 この状態では、スクリーンリーダーや支援技術を使うユーザーから見ると、機能の伝わらないコンポーネントが増えていきます。 現状把握として、ChromeのLighthouseでトップページを計測したところ、Accessibilityスコアは86点でした。検出された指摘は <select> のラベル不足やコントラスト比不足など、共通コンポーネントとデザイントークン由来の項目が中心です。共通部品の不備は複数ページに波及します。改修へ進む前段階として、まず基礎を押さえておきたいと判断しました。 以前からアクセシビリティは気になっていたテーマでもあり、チームでSEOやUI品質について話し合う機会が増えたことも後押しになりました。そこで4月の個人テーマとして、WCAG・WAI-ARIAの基礎調査と自社プロダクトの横断計測を据えました。次の章からWCAG・WAI-ARIAの順に整理し、最後に自社プロダクトの計測結果へつなげます。 WCAGとは WCAG(Web Content Accessibility Guidelines)は、W3Cが策定したWebアクセシビリティの国際ガイドラインです。障害のある人や高齢者を含むあらゆるユーザーが、Webコンテンツを利用できるようにするための指針です。 4つの原則(POUR) すべての達成基準は、次の4つの原則に分類できます。 原則 内容 例 Perceivable(知覚可能) 情報がユーザーに認識できる 画像のalt、字幕 Operable(操作可能) UIが操作できる キーボード操作対応 Understandable(理解可能) 内容や操作方法が理解できる エラー表示の分かりやすさ Robust(堅牢) 多様な環境で動く 正しいHTML構造 3段階の適合レベル レベル 位置づけ 具体例 A 最低限。これがないと使えない人が出る キーボード操作可能、画像にalt属性 AA 一般的に目指すべき標準 コントラスト比4.5:1以上、200%拡大対応 AAA 最高レベル。完全準拠は現実的に困難 コントラスト比7:1以上、手話付き動画 日本ではJIS X 8341-3:2016がWCAG 2.0と同内容のため、公的機関でも参照されています。実務で目標とする標準ラインは AA準拠 です。 ...

2026年4月28日 · 読了時間: 3分 · 坂内由梨
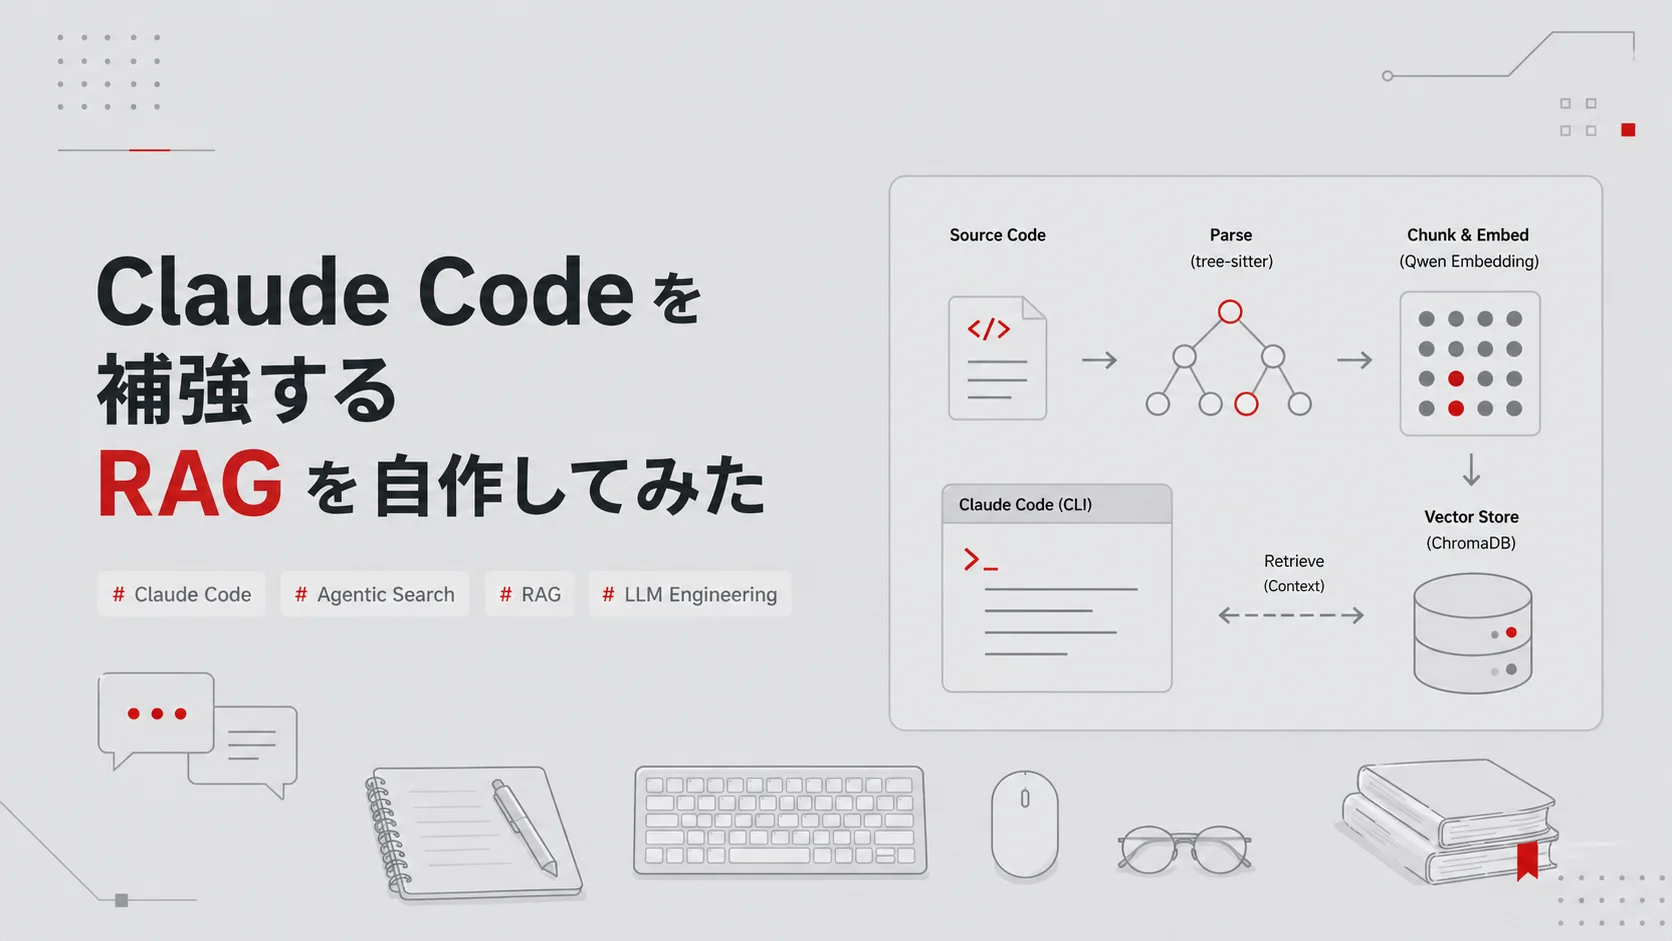
tree-sitter・Qwen Embedding・ChromaDB で組んだコード RAG CLI の構成イメージ

Claude Code を補強する RAG を自作してみた

1. はじめに こんにちは。and factory バックエンドエンジニアの木梨です。 Claude Codeを大規模コードベースで使っていると、「この機能はどこで実装されているか」のような広い問いで Grep や Explore が何度も走り、待ち時間が長くなりがちです。私が触っているGo / PHP / JSが混在する大規模モノレポでも、広い問いで数分待たされるのが日常的に発生していました。 改善策を探していた背景には2つの体験があります。1つは、社内にDevinが導入されたときにDeepWikiでコードベースに広い問いを投げた際の回答速度の速さです。一次情報は見つけられませんでしたが、応答の仕方からして内部でRAGを使っているのではと推測しています。もう1つは、Cursorのブログで報告されているセマンティック検索の導入効果です。どちらも「セマンティック検索を前段に置けば広い問いが軽くなる」という方向を示しています。同じ発想で最小構成のRAGをClaude Codeの前段に置いてみたのが本記事で紹介する構成です。 本記事では、tree-sitter・Qwen Embedding・ChromaDB で組んだ最小構成の RAG CLI を Claude Code から呼ぶまでを手順として共有します。約220行のPythonで動きます。既存のRAGライブラリを使う選択肢もありました。それでも今回自作の形にしたのは、Claude Code用にCLIとして統一したかった点と、中身が見える最小構成のほうが細かい調整をしやすい点の2つが理由です。 対象読者は Claude Code を日常的に使っており、RAG の基本概念(埋め込みベクトル、近傍検索)は既知の方を想定しています。 TL;DR 構成: tree-sitter + Qwen3 Embedding + ChromaDB + Python CLI。約220行 使い方: Claude Codeから検索CLI(例: myrag search)を呼び、候補を Read / Grep で裏取り 効果: 広い問いで待ち時間が体感で明確に短縮された。参考計測では中央値でRAG前段75秒 / Explore very thorough 132秒 / Explore medium 172秒。実行時間の安定性でもRAGが優位。詳細は6章「実際の効果」参照 注意: チャンク化したコードを外部APIへ送る構成。業務利用前に法務・セキュリティ確認が必要。詳細は事前に確認したいことを参照 事前に確認したいこと チャンク化したコードはAlibaba Cloud(DashScope)に送信されます。業務リポジトリで適用する場合は、先に社内の法務・セキュリティ窓口でコード外部送信ポリシーを確認してください。以下は最低限のチェックポイントです。 検証時は匿名化済みコードのみを使う APIキー、秘密鍵、認証トークン、個人情報、契約情報を含むファイルは投入しない .env や秘密鍵は EXCLUDE_PATTERNS(後述)に含まれているので、社内固有の機密ファイルがあれば同じ要領でパターンを足す 機密性が高くそもそも外部送信を避けたい場合は、embedder.py を sentence-transformers 等のローカル埋め込みに差し替えれば同じ構成で動きます。 ...

2026年4月23日 · 読了時間: 14分 · 木梨太一朗
LeakCanaryのリークトレースとClaude Codeの連携を示すイメージ

Claude CodeでAndroidのメモリリーク改善を自動化する ── LeakCanaryの検知からAI修正までのアプローチ

はじめに こんにちは。and factory Androidエンジニアの鬼倉です。 今回は、私が携わるAndroidプロジェクトでClaude Codeを活用し、ANR改善に取り組んだアプローチを紹介します。ANRの原因はさまざまですが、本記事ではメモリリークを原因とするANRに焦点を当てます。 Android開発者にとって、メモリリーク対応のためにLeakCanaryを導入したはいいものの、結局修正できず通知が出続けているという方も多いのではないでしょうか? そこで今回私のプロジェクトでは、LeakCanaryによる検知に加えてClaude CodeのSkillsを活用した自動修正の仕組みを構築しましたので紹介します。 ANRとは? ANR(Application Not Responding)とは、アプリが指定時間内に操作を応答できなかった場合に発生するシステムエラーです。代表的には、UIスレッドが入力イベントに対して5秒以内に応答できない場合などでトリガーされます(BroadcastReceiverやServiceでも発生)。デッドロック、I/O処理のブロック、高負荷処理などさまざまな原因で発生します。Crashと同様にユーザー体験を大きく損なう問題ですが、Crashほど原因が明確でなく再現も難しいため軽視されがちです。ANR率はFirebase CrashlyticsやGoogle Play Consoleで確認できます。 本記事の環境 技術 バージョン Kotlin 2.3.20 AGP(Android Gradle Plugin) 8.9.3 LeakCanary 2.14 ANR改善が進まなかった背景 まずはそもそもメモリリークによるANRの修正改善がなぜ進んでいなかったのかを整理します。 FirebaseのANRレポートだけでは原因を深掘りしにくい Crashの場合、Firebase Crashlyticsに発生元のExceptionが記録されるため、その箇所が直接的な修正対象になります。一方、メモリリーク由来のANRは事情が異なります。複数箇所のメモリリークが徐々に蓄積し、最終的にANRとして発生します。そのため、Firebase上のレポートから直接的な原因箇所を特定することが困難です。 さらに、メモリリークの蓄積は端末のメモリ状況やユーザーの操作パターンに依存するため、開発環境での再現も難しいという問題があります。 ANR改善のためのLeakCanary導入と修正対応の難しさ ANRの発生件数を改善するため、メモリリーク検知の定番ライブラリであるLeakCanaryを導入しました。LeakCanaryを導入すると、開発中の手元の端末上でメモリリークの発生をリアルタイムに把握できます。 しかし、検知できることと修正できることは別の問題です。LeakCanaryはメモリリークの発生タイミングやある程度の情報を提供しますが、明確なコード上の原因までは教えてくれません。開発者自身が情報をもとに原因となるコードを探し出し、修正する必要があります。 さらに厄介なのは、メモリリークの原因となるコードは一見すると問題がないように見える点です。修正にはAndroid開発やKotlinに関する深い知識が求められ、1件あたりの対応に時間を要します。結果として、他の機能開発やCrash対応に比べて優先度が下がり、改善が後回しになりがちな状況が続いていました。 Claude Codeを活用したメモリリーク改善アプローチ 以上の理由により、LeakCanaryやFirebaseのANRログだけでは自力での修正は困難でした。それに対してどのようにAIを活用して修正をしていくのでしょうか? 最もシンプルなアプローチとしては、LeakCanaryが通知を出したら内容をClaude Codeにコピーペーストして修正を依頼することです。この方法でももちろん対応できます。 しかし、Logcatを含めた前後情報があればより精度が高まりますし、コピーペーストという作業をなるべく減らし即座に修正を依頼する環境を構築しなければ、再び後回しになりかねません。 今回私たちが構築したのは、LeakCanaryが通知を出した瞬間にClaude Codeへ/investigate-leakと依頼するだけで完結する方法です。AIが自ら端末のLogcatを確認し、ログ情報からメモリリークの修正を提案します。 LeakCanaryのリークトレースをClaude Codeから取得可能にする なお、本記事のアプローチではLogcatの内容をAIに読み取らせるため、ユーザーの個人情報やAPIキーといった機密情報がLogに出力されていないことが前提となります。 LeakCanaryはメモリリークを検知すると端末上に通知を表示します。しかし、デフォルトではヒープダンプの解析結果がlogcatに出力されません。Claude Codeがリークトレースを自律的に取得できるよう、解析結果をlogcatに出力する仕組みを追加しました。 具体的には、LeakCanaryのonHeapAnalyzedListenerをカスタマイズしています。 1 2 3 4 5 6 7 8 9 10 11 12 13 import leakcanary.LeakCanary import leakcanary.OnHeapAnalyzedListener import timber.log.Timber val defaultListener = LeakCanary.config.onHeapAnalyzedListener LeakCanary.config = LeakCanary.config.copy( onHeapAnalyzedListener = OnHeapAnalyzedListener { heapAnalysis -> defaultListener.onHeapAnalyzed(heapAnalysis) // ここでLogに出力(ここではTimberを利用しています) Timber.tag("LeakCanary").d(heapAnalysis.toString()) } ) この設定により、Claude Codeは以下のadbコマンドでリークトレース全文を取得できます。 ...

2026年4月15日 · 読了時間: 2分 · 鬼倉泰裕
NextAuth to better-auth migration

【Next.js App Router】NextAuth v5 から better-auth へ!逆引き移行チートシート

(2026/6/9追記) 本記事の公開後にセキュリティ運用の見直しを行い、§2と §4にそれぞれ追記を加えています。最新の推奨構成は各セクションの追記をご確認ください。(追記ここまで) Better Auth が Auth.js を公式に引き継いだ発表 2025年9月付近で、Auth.js(旧NextAuth.js、以下NextAuth)の公式発表がありました。Better Auth(npmパッケージ名: better-auth、以下better-auth)チームに引き継がれるという内容です。 発表された概要は以下のとおりです。 Auth.jsのセキュリティ修正やクリティカルな対応は継続される 新機能・今後の進化は Better Auth 側に集約される NextAuthの開発メンバーが関わる形でBetter Authへ収束していく方針です。 既存のプロジェクトであればすぐさまbetter-authに切り替える必要はありませんが、新規のプロジェクトであればbetter-authも有力な選択肢です。 今回、新規プロジェクトの立ち上げにあたり、この公式発表を受けてbetter-authを採用しました。NextAuth v5では jwt コールバックにリフレッシュ処理を集約していましたが、ロジックの肥大化により保守が困難になっていました。better-authのプラグインベースの設計に魅力を感じたことも決め手の1つです。 このドキュメントは、Next.js App Router と TanStack Query を採用したプロジェクトを対象としています。バックエンドAPIが「JWT + リフレッシュトークン」を発行するステートレスな構成において、NextAuth (v5) からbetter-authへ移行する際のノウハウを逆引き形式でまとめました。 これからbetter-authの導入や移行を検討しているエンジニアの方は、ぜひ参考にしてください。 動作確認環境 ライブラリ バージョン Next.js 16.0.7 React 19.x better-auth 1.4.18 @tanstack/react-query 5.75.4 Node.js 24.11.1 1. 初期設定・ルーティング編 Q. フロントエンドでセッション情報を共有したい(Providerの配置) NextAuth: ルートレイアウトなどに <SessionProvider> を配置してReact Contextでセッションを共有する必要がありました。 better-auth: Providerは一切不要(削除)です。better-authはCookieベースで動作し、内部的に nanostores のAtomを利用して各コンポーネントに状態を共有します。 補足: なぜ Provider なしで動くのか? NextAuthはReact Context(Provider → Consumer)でセッションを配信していました。better-authはReactの外にあるグローバルストア(nanostoresのAtom)にセッション状態を保持し、useSession() はそのAtomをsubscribeするだけです。Reactツリーに依存しないためProviderが不要になります。初回マウント時にCookieから /api/auth/get-session をfetchしてAtomを初期化し、以降はAtomの値を返します。 ...

2026年4月10日 · 読了時間: 4分 · 福士宗介
and factory Tech Blog

and factory Tech Blog を開設しました

はじめに and factory Tech Blog を開設しました。 このブログでは、and factory のエンジニアが日々の開発で得た知見や技術的な取り組みを発信していきます。 発信する内容 技術選定の背景と意思決定 開発プロセスの改善 新しい技術の検証・導入事例 チーム開発のノウハウ 今後の記事をお楽しみに!

2026年3月18日 · 読了時間: 1分 · and factory