Figma Dev Mode MCPで画像書き出しを自動化してみた

Figma Dev Mode MCPで画像書き出しを自動化してみた ── 68点の一括取得とWebP変換で分かったこと

はじめに こんにちは。and factory フロントエンドエンジニアの坂内です。 施策バナーなどの画像をFigmaから書き出す作業が、地味に手間だと感じていました。1枚ずつ選択してエクスポートし、書き出したPNGを別のツールでWebPに変換して圧縮する。作業自体は難しくありませんが、工程が分断されているぶん、都度の切り替えコストがかかります。 直近の施策では15枚ほどを書き出しました。枚数だけ見れば多くありませんが、1枚ごとに書き出しと変換を往復すると、それなりの時間を取られます。 きっかけは、会社で契約しているツールをもっと使い倒せないか、コーディングまわりをもう少し楽にできないか、と考えたことでした。調べるうちにFigmaのDev Mode MCPサーバーに行き着き、Claude Codeとつないで検証しています。この記事はその記録です。 やってみると、事前の想像と違う結果がいくつも出てきました。想定していたより権限のハードルが低かった一方、単発なら手動のほうが速いという結果も出ています。「圧縮したのにファイルが大きくなる」という予想外の挙動もありました。 注意: 本記事に登場するFigmaのレイヤー名とファイル名のうち、施策名や機能名を含むものは仮名に置き換えています。スクリーンショットでも該当箇所を伏せています。数値はすべて実測値です。 結論 先に結果を3点にまとめます。 指定する範囲が速度をほぼ決める。ページ全体に近い範囲を渡すと68点を一括で取得できたが、時間がかかった 1枚だけなら手動のほうが速い。AIを挟む価値は書き出し単体ではなく、書き出しから変換までを1つの指示で通せる点にある WebP変換は画像の種類で品質を分ける必要がある。70ファイルで合計38.2%削減できた一方、4点は逆にサイズが増えた 検証環境 項目 内容 実施時期 2026年7月 OS macOS Figma デスクトップアプリ(Dev Mode MCPサーバーはデスクトップ版のみ対応) Figmaのプラン 有料プラン AIクライアント Claude Code 変換ツール sharp 0.35.3(npx 経由で実行。Node 20.9以上が必要) Node.js v20.9.0以上(sharp 0.35.3の要件) 対象 ある施策ページのデザイン(最終的に70ファイルを取得) その前に:URLを渡すだけでは足りなかった MCPの設定を始める前に、claude.aiにFigmaのデザインURLをそのまま渡して画像を取得できないか試しました。結果は Site blocked the request (bot detection) でブロックされ、ページ自体を読み取れません。Figmaは認証が必要なサービスなので、汎用のWeb閲覧機能では中身に到達できないためです。 画像を扱うには専用の接続が要ると分かったので、MCPの設定に進みます。 権限は思ったより障害にならなかった 次に気にしていたのが権限です。Figma MCPサーバーのガイドには、デスクトップ版サーバーの利用にDev/Fullシートを含む有料プランが必要と書かれています。この記述を読んで、管理者にシートのアップグレードを相談する必要があるかもしれない、と身構えていました。 ところが実際に画面を開いてみると、特別な手続きなしでMCPサーバーを有効化できました。管理者への確認は不要でした。 調べ直すと、別ページのRate limits & accessに補足がありました。View / Collabシートにも月6回までのツール呼び出し枠が用意されており、有料プランでもこの上限が適用されます。アクセスはプランとシート種別の両方で決まります。View / Collabシートはプランに関わらず月6回で頭打ちです。一方、Dev / Fullシートの上限はプランで変わります(Starter・Professionalは1日200回、Organizationは1日600回)。 つまり、Dev/Fullシートでなければ一切使えない、というわけではありません。回数は多くないものの、検証や小さく試す段階であれば足ります。 同じところで足踏みしている方もいそうなので書いておくと、権限の相談より先に、自分の環境で有効化できるかを試すほうが早いです。シート種別はチームや組織の管理画面から確認できます。ただ、まず動かしてみたほうが話の早い場面もあります。仮に権限が足りなかった場合も、デザイナーの環境で有効化してもらい、そこへ接続する方法が残っています。 ...
2026年7月30日 · 読了時間: 2分 · 坂内由梨
Google Stitchを触ってみた ── Vibe Designツールは「出口」で選ぶ

Google Stitchを触ってみた ── Vibe Designツールは「出口」で選ぶ

はじめに こんにちは。and factory フロントエンドエンジニアの坂内です。 前回はClaude Designを実案件で試した記事を書きました。ワイヤーフレームを作るならFigmaが候補に挙がりますが、普段はデザイン確認専用に使っていました。ディレクターへ共有するモックが必要になったとき、Figmaの使い方を調べながら進めるより手軽な方法を探していた、というのが前回の出発点です。 その後、同僚から「Google Stitchというツールがある」と教えてもらいました。同じくAIでUIを生成するツールですが、Googleが作っている点と無料で使える点が違います。前回とまったく同じお題を投げたら、出てくるものはどう変わるのか。 特にエンジニアとして受け取る側から見て、実装の手触りに差が出るのかを確かめたくなりました。それが今回の動機です。 調べ始めると、Stitch単体の話ではないと分かりました。v0・Lovable・Bolt.newといったツール群が「Vibe Design」という潮流を作っており、それぞれ狙っている領域が違います。この記事では、フロントエンドエンジニアとして「生成物を受け取る側」の視点から、Vibe Designツールの現在地と実務での使いどころを整理します。 注意: 本記事の内容は2026年7月時点の情報に基づいています。StitchはGoogle Labsの実験プロジェクトであり、機能・料金・UIの変更が頻繁に発生します。最新の情報は公式サイトを確認してください。 結論 先に持ち帰ってほしいポイントを3つに絞ります。 Vibe Designツールは「どれが最強か」ではなく「出口が何か」で選ぶ。デザイン案が欲しいのか、Reactコンポーネントが欲しいのか、動くアプリが欲しいのかで最適解が変わる Stitchはプロンプトをそのまま描かず、デザインシステムを立ててから解釈する。「ピンクのヘッダー」という指示が濃紺サイドバー + ピンクのアクセントに変換された理由が、生成されたDESIGN.mdに書かれていた DESIGN.mdによるDesign System as Codeの流れが本命。デザイン制約をMarkdownで記述してAIエージェントに読み込ませる発想は、デザイナーとエンジニアの連携そのものを変える可能性がある 「Vibe Design」とは何か 「Vibe Coding」という言葉を聞いたことがある方は多いはずです。元OpenAIのAndrej Karpathyが2025年初頭に提唱した概念で、コードの細部を自分で書かずに意図や雰囲気をAIへ伝えて生成させるスタイルを指します。 その波がデザイン領域にも来ました。Vibe Designとは、「こういう画面にしたい」という意図をプロンプトで伝え、レイアウト・配色・タイポグラフィまでAIに一括生成させる進め方です。ピクセル単位でUIを組み上げる従来の手順とは発想が異なります。 UX研究者のJakob Nielsenも、UIがハードコーディングされる時代から意図とコンテキストに基づいて生成される時代へ移行すると述べています。業界全体がその方向に動き始めています。 Vibe Designツールを「出口」で分類する ツールを比較するうえで最初に整理したいのが「出口」の違いです。何が手元に残るのかを揃えないと、比較がかみ合いません。 ツール 主な出口 バックエンド 主な対象 料金 Google Stitch UIデザイン案 + コード なし デザイナー・フロントエンドエンジニア 無料 v0 by Vercel Reactコンポーネント なし フロントエンドエンジニア 月額 $30〜 Lovable 動くフルスタックアプリ あり(Supabase) 非エンジニア〜フロントエンド 月額 $25〜 Bolt.new 動くフルスタックアプリ あり エンジニア寄り 有料プランあり Figma Make Figma上のインタラクション なし デザイナー Figmaプランに依存 大きく2カテゴリに分かれます。 ...

2026年7月28日 · 読了時間: 4分 · 坂内由梨
usecase層をmockで隔離してテストする構成のイメージ

Goのusecase層に一貫したユニットテストを根付かせる ── mockery v3 × testify × AAAとSkillによる量産設計

はじめに 私の担当するバックエンドでは、機能を積み増す一方で、ビジネスロジックの中心である usecase 層にユニットテストがほぼ無い状態を長らく抱えていました。しかも500を超えるusecaseに、複数人で少しずつテストを足していく必要があります。この規模で一番の敵は「人によってテストの書き方がバラバラになること」です。書き方が揃わないと、レビューは毎回スタイルの指摘に追われ、テスト自体の信頼性も安定しません。 結論から言うと、次のように解決しました。 mockery v3 + testify + AAAパターンでテストの「型」を固定する 書き方一式を Claude CodeのSkills(AIエージェント向けの手順書) として固定し、人が書いてもAIが書いても同じ形に揃える カバレッジをCIで自動計測し、テスト未整備の箇所を可視化する この記事は、その具体的な実装方法と、その形に決めるまでの設計判断をまとめたものです。 前提として、このバックエンドはClean Architecture + DDDをベースにした モジュラーモノリス構成のGoサービスです(構成そのものの詳しい話はこちらの記事をご確認ください)。 対象読者 GoでClean Architecture / DDD風のレイヤード構成を採っていて、アプリケーション層のテストをこれから増やしたい方 既存コードにテストを「後から・複数人で・大量に」足す局面にいる方 mockery v3 + testifyでのモックテストの具体的な書き方の落としどころを知りたい方 この記事で得られること usecase層を「何を境界として」テストするかの考え方(ブラックボックス検証) mockery / テストデータ / 引数検証を、なぜこの形にしたか AAAパターンでの具体的な書き方(引数マッチャーの読み書き分離・output比較・エラー検証) テストデータ生成ヘルパーの設計(newTest{Type} + Optionパターン) 書き方一式をSkillとして固定し、人もAIも同じ形に揃える運用 カバレッジをCIで自動可視化する仕組み 動作確認環境 種別 バージョン Go 1.26.3 mockery v3 系 testify v1 系(mock / assert) CI CircleCI 1. 前提: usecase 層とは何か(ざっくり) アーキテクチャの詳細は本筋ではないので前提だけ。レイヤーの依存方向はおおむね次のとおりです。 adapter(HTTP ハンドラ) → scenario(クライアント別の組み立て・トランザクション境界) → usecase(アプリケーションのユースケース) ← 今回テストする層 → repository IF / service IF(インターフェース) → infra 実装(DB・外部サービス) usecase 層は「1つの業務操作」を表す層です。リポジトリやドメインサービスをインターフェース越しに呼び、入力DTO(input)を受け取って、ドメインのルールに従い加工し、出力DTO(output)を返します。DBアクセスや外部通信の具体実装には依存しないのがポイントです。 ...

2026年7月10日 · 読了時間: 4分 · 高野智明
キーボードから一歩引き、宙に浮かぶコードやUIパネルを手で指揮するエンジニアの概念イラスト

コードを書かない新卒2年目の開発フロー 〜手書き世代が「判断と段取り」に全振りするまで〜

はじめに こんにちは。and factory で新卒2年目のサーバーサイドエンジニアをしている松ヶ浦です。 新卒2年目ですが、いまはもう、自分でコードをほとんど書いていません。エディタも「書く道具」というより「読む道具」になりました。 ただ、最初からそうだったわけではありません。大学1年の頃は、VS Codeで普通に手書きでコードを書いていました。 きっかけは大学2年で触れたGitHub Copilotでした。そこからAIに任せる比重は増え続け、4年の卒業研究では、VS Codeの拡張機能をほとんどvibe codingで作りました。入社後もこの流れは止まらず、Claude Codeを使うようになった頃には、自分でエディタにコードを打ち込むことはほとんどなくなっていました。 手書きでまともなプロダクトを作った経験はないので、「コーディング力がついた」という実感はもともとありません。 この記事で言いたいことは、2つです。 新卒の仕事は、「コードを書くこと」から「判断と段取り」に移った。 そのうえで厄介なのは、AIが、自分の理解できていないことまで隠してしまうこと。だから僕は、実装に入る前の見積もりで理解を詰め切ることに時間を使っている。 以下では、1つのタスクを概念からPRまでどう進めているかを、実際の流れに沿って書きます。まずは全体像です。各ステップで「人(僕)が握る」か「AIに逃がす」かも併記しました。 flowchart TB A["① タスク受領 〔人〕<br/>何をする機能かを言語化し<br/>設計の方向性を固める"] B["② 見積もり 〔人主体 + AI〕<br/>実装より先に理解を詰め切る<br/>Devin = 一次調査 / Claude Code = 厳密調査"] C["③ 実装 〔AI主体〕<br/>Claude Code が実装<br/>Plan は人が確認"] D["④ PR前確認 〔人〕<br/>コードを読んで検証する"] E["⑤ 動作確認 〔AI + 人〕<br/>自作 skill で実行し手でも触る"] F["⑥ PR提出 〔AI〕<br/>push 〜 PR作成 / Draft は人が Open"] A --> B --> C --> D --> E --> F この図のとおり、コードを書く部分はAIに任せ、僕は「理解」「確認」「判断」に回ります。それでは、各ステップを順に見ていきます。 ...

2026年6月22日 · 読了時間: 1分 · 松ヶ浦健
AIデザインツール「Claude Design」を実案件で試してみた

AIデザインツール「Claude Design」を実案件で試してみた ── ワイヤーフレームから仕様ドキュメントまで自動生成

はじめに こんにちは。and factory フロントエンドエンジニアの坂内です。 ワイヤーフレームを作るとなればFigmaが候補に挙がりますが、普段はデザイン確認専用に使っていました。いざ自分で作るとなると使い方を調べながら進める必要があり、「もっと手軽に作れないか」と思っていました。ちょうど機能追加でディレクターへ共有するためのモックが必要になったタイミングで、AnthropicのAIデザインツール「Claude Design」を見つけ、試してみました。 あくまでワイヤーやモック用途での活用として、「ディレクターやデザイナーと連携するフロントエンドエンジニアにとって、どう使えるか」という観点で使いみちを探りました。 注意: Claude Designはリサーチプレビュー段階のツールです。UIや機能仕様は今後変更される可能性があります。本記事の内容は2026年6月時点の情報に基づいており、最新の状況と異なる場合があります。 結論 先に持ち帰ってほしいポイントを3つに絞ります。 スクリーンショット+テキスト指示だけでデザイントーンに合ったワイヤーが生成できる(既存画面のピンク×サイドバー構成を再現) バリデーション・APIペイロードまで自発的に実装してくれるため、エンジニアへの引き継ぎ資料が副産物として得られる 「Claudeチャットで仕様を固めてからDesignに渡す」2段階フローが現実的。Claude Designは細かい修正の往復には向かない Claude Designとは Claude Designは2026年4月17日にAnthropicがリリースしたAIデザインツールです(Anthropic Labs製・リサーチプレビュー)。 claude.ai 内の専用ワークスペースとして動作し、左ペインのチャットで指示すると、右ペインのライブキャンバスへリアルタイムに反映される2画面構成が特徴です。なお、これは今回試したUIに基づく観察です。公式発表ではインラインコメント・直接編集・調整ノブなどのインタラクションが紹介されています。 項目 内容 リリース 2026年4月17日(Anthropic Labs製・リサーチプレビュー) 対象プラン Pro / Max / Team / Enterprise モデル Claude Opus 4.7(デフォルト) できること プロトタイプ・スライド・ワンページャー・HTML書き出し トークン 通常チャットとは別枠(プランにより異なる) アクセス方法 claude.ai にログイン後、左サイドバーの「Design」から起動できます。Pro / Max / Team / Enterpriseプランが対象です。 Notionコネクタを使う場合は事前設定が必要です。Settings → IntegrationsからNotionを接続しておくと、Design内でNotionのURLをそのまま渡して仕様ページを直接読み込めます。 実践:管理画面のワイヤーを作る 概要が掴めたところで、実際に試した内容を紹介します。 最初に渡したプロンプト 今回は自社サービスの管理画面に「施策管理ページ」を追加する想定でワイヤーを作成しました。最初のプロンプトはシンプルにしました。 1 2 3 4 5 6 7 XXXXXという管理画面の施策管理ページを作りたい。 - PC向け管理画面 - ピンク(#E91E8C)のヘッダー+左サイドバー構成 - 施策一覧テーブル(ID・施策名・開始日・終了日・URL・ステータス) - 詳細ボタン → モーダルで編集 - モーダル内はアコーディオンで項目を折りたたむ - ステータスは「下書き / 公開 / 非公開」の3種 これだけでClaude Designから10問のヒアリングが返ってきて、設計が始まりました。 ...

2026年6月9日 · 読了時間: 2分 · 坂内由梨
XSS の4つの侵入経路と多層防御モデル

Web アプリの XSS はどこから入るか — 4 つの侵入経路と多層防御モデル

「Reactは自動エスケープしてくれるからXSSは古い話」——そう思っていないでしょうか。 実際には、ReactやNext.jsが標準で塞いでくれる経路は XSS の侵入口の一部 にすぎません。dangerouslySetInnerHTML、依存パッケージの汚染、悪意ある拡張機能。これらはReactの自動エスケープを そもそも経由しません。 この記事では、現代のWebアプリでXSSが侵入してくる 4 つの経路 を整理し、それぞれに対する 多層防御モデル をマトリクス化します。最後に、認証トークンの保存設計(better-authのAccess Tokenを例に)を取り上げて、「攻撃経路 × 防御層」で判断する具体例を示します。 この記事を書いたきっかけ 3サイトのフロントエンドを並行開発する中で、リリース運用フェーズへの移行に合わせて認証セキュリティ設計を見直しました。実装を読み込むと、「Access Tokenに5分のTTLを設定しているから安全」という直感は持続的XSSのケースでは成り立たないと気づきました。第1号「NextAuth v5 から better-auth へ!逆引き移行チートシート」で扱った認証基盤の続編として、運用フェーズで考えるべき多層防御の整理を共有します。 先に結論:攻撃経路 × 防御層のマトリクス 詳細は本文で展開します。結論は次のマトリクスに集約されます。 Stored Reflected DOM-based サプライチェーン 拡張機能 CSP ◎ ◎ ◯ △ × レート制限 △ △ △ × × トークン隔離 △ △ △ × × 異常検知 △ △ △ △ △ 読み取り: CSP が最も広く効く根本対策。ただしサプライチェーンと拡張機能には限界がある 認証トークン隔離(BFF化)の効果は限定的で、AT 値漏洩経路は塞ぐが、API 不正コール経路は塞げない 単独の銀の弾丸はなく、組み合わせる前提で設計する なぜこのマトリクスになるのか、なぜトークン隔離だけでは不十分なのかを、以下で順に解説します。 この記事で得られること XSSの 4 つの侵入経路(Stored / Reflected / DOM-based / サプライチェーン・拡張機能)の整理 「持続的 XSS」という概念と、それが短命トークンを無効化する仕組み CSP / レート制限 / 認証トークン隔離 / エラー監視 の4つの守備範囲を比較した防御マトリクス 認証トークンを JS から隠す設計 が「何を防げて、何を防げないか」 単一の銀の弾丸ではなく、多層で組み合わせる ための判断軸 動作確認環境 種別 バージョン OS macOS 15.x Node.js 24.x パッケージマネージャー pnpm 10.x Next.js 16.x(App Router) React 19.x better-auth 1.x 1. なぜ XSS が今も現役なのか XSS(Cross-Site Scripting)は2000年代から続く古典的な脆弱性です。ReactやVueのような現代のフレームワークは、テンプレート内の変数を自動的にエスケープしてくれます。 ...

2026年6月3日 · 読了時間: 7分 · 福士宗介
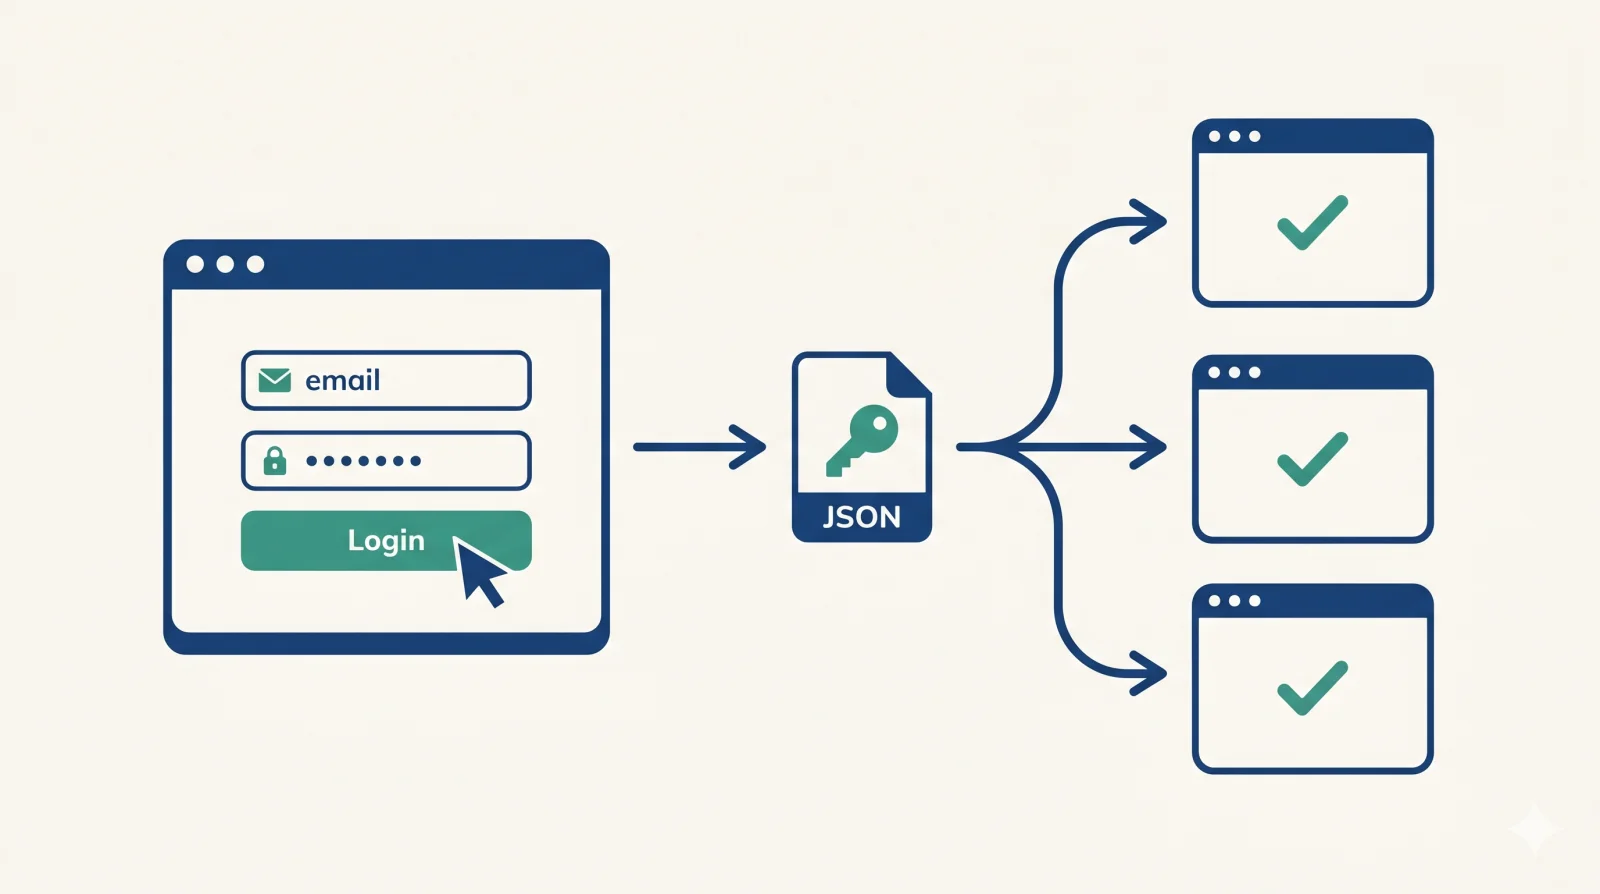
ログインを1回実行してstorageStateに保存し、複数のテストで再利用する構成図

ログインは1回だけ — Playwrightの globalSetup × storageState でE2Eテストを高速化する

本記事では、PlaywrightのE2Eテストで globalSetup と storageState を使い、ログイン状態を一度だけ取得して各テストで再利用する仕組みを解説します。 この方式により、ログインが必要なページのテストでも毎回ログイン操作を繰り返さずに済み、テスト全体を高速かつ安定的に実行できます。 この記事で得られること globalSetup+storageStateでログインを1回だけ実行し、全テストで再利用する実装 httpOnly Cookieを含むログイン状態が保存・注入されるしくみ 実際にログインするテストとログイン済み状態から開始するテストの使い分け globalSetup内で成功・失敗それぞれのトレースを記録するデバッグ手法 背景と課題 これまで、ログインが必要な画面のリグレッション確認を、リリースのたびに手動で実施していました。 対象画面が十数件にのぼり、毎回30分以上の確認工数がかかっていたうえ、ログインを伴う操作フローは手動では見落としが起きやすく、リリース後に不具合に気づくケースもありました。 機能追加のペースが上がり、確認対象もさらに増えてきたことをきっかけに、これらの確認をE2Eテストで自動化し、リグレッションを継続的に担保することにしました。 E2Eテストを導入するうえで課題になるのが認証の扱いです。 テストごとにログイン操作を繰り返すと、テスト数に比例して実行時間が増え、さらにログイン処理自体の不安定さがテスト全体の信頼性を下げます。 そこで、ログインを一度だけ実行してセッション情報を保存し、各テストで再利用する仕組みを globalSetup と storageState で構築しました。本記事はその構成と運用方法をまとめたものです。 前提環境 本記事は以下の環境で動作を確認しています。お使いの環境に合わせて読み替えてください。 ツール バージョン Node.js 20.18.0 (LTS) @playwright/test 1.49.1 Nuxt 3.14.0 TypeScript 5.6.3 実行OS macOS 14 / Ubuntu 22.04 (CI) ファイル構成 E2E専用の構成として、関連ファイルは次のように配置します。 1 2 3 4 5 6 7 8 9 10 11 src/ ├── package.json # test:e2e スクリプトを追加 ├── playwright.e2e.config.ts # E2E専用Playwright設定 ├── .env.e2e # 認証情報(gitignore済み・各自作成) ├── playwright/ │ └── .auth/ │ └── user.json # ログイン済みCookie(gitignore対象・テスト実行時に自動生成) └── tests/ └── e2e/ ├── global-setup.ts # ログイン・storageState保存 └── auth.spec.ts # 認証フローのテスト E2E専用の設定ファイルを分ける理由 E2Eテストは実APIを呼び出し、実際にログインしてセッションを取得します。スナップショット比較やユニットテストなど他の種類のテストとは、API・認証・実行タイミングの要件が異なります。 ...

2026年6月3日 · 読了時間: 7分 · 渡邊尚人
X(Twitter)のシェアカードに書影が表示されているブラウザウィンドウのイラスト

X(Twitter)シェアで書影が出ない問題を動的 OGP エンドポイントで解決した記録

問題と対応のまとめ 開発を担当しているサービスでは、作品詳細ページにX(旧Twitter)のシェアボタンを設置しています。ボタンを押すと書影(表紙画像)付きのTwitter Cardとしてツイートに表示されることを想定していました。しかしシェアボタンの動作確認中に実際にシェアしてみたところ、書影が表示されずテキストのみのカードになっていることを発見しました。 当初のシェアボタンは作品詳細ページのURLを直接参照しており、書影はページを開いた後にJavaScriptが内部APIを呼び出して動的に取得・表示する実装でした。 原因はこの構成にあります。フロントエンドはNext.jsの静的エクスポートで動いているため、初回のHTMLレスポンスには書影が含まれていません。Twitter Cardはページの静的HTMLに埋め込まれたメタタグを読み取る仕組みのため、CSR(クライアントサイドレンダリング)で取得した書影をOGPタグとして渡せません。 SSR(サーバーサイドレンダリング)への移行も検討しましたが、ホスティング構成の大幅な変更が必要なため見送りました。詳しくは後述の「なぜ専用エンドポイントを追加したか」で説明します。 解決策として、api-frontend にTwitterbot向けのOGP生成エンドポイントを新設しました。フロントエンドのXシェアURLをそこへ向けることで、書影付きのTwitter Cardが表示されるようになりました。この対応は調査・実装・動作確認を含めて約2週間で完了しました。 OGP と Twitter Card について OGP(Open Graph Protocol) とは、Webページの情報をSNSやメッセージアプリが正しく読み取れるよう構造化するための仕様です(ogp.me)。OGPタグを設定していない場合、SNSでシェアしてもURLがそのままテキストとして表示されます。HTMLの <head> に og:title・og:description・og:image などのタグを記述します。これにより、URLシェア時にタイトル・説明・画像のプレビューが自動生成されます。Facebookが策定し、現在は多くのSNS・チャットツールで対応しています。 Twitter Card はX(旧Twitter)が提供するURLシェア時のリッチリンクプレビュー機能です。OGPタグをベースに twitter:card・twitter:title・twitter:image などの専用タグを加えることで、ツイート内に画像・タイトル・説明文を含むカードが生成されます。 サービスの構成 このサービスのフロントエンドは2つのリポジトリに分かれています。ユーザー向け画面を担当する frontend と、決済・外部連携など動的なサーバー処理が必要なAPIを担当する api-frontend です。 本記事の実装は api-frontend の以下の環境で行いました。 技術 バージョン Next.js 13.4.12 TypeScript 5.1.6 graphql-request 6.1.0 Node.js 20.x frontend はNext.jsの静的エクスポートでHTML・CSS・JSをCDNで配信しています。書影の画像ファイルも別のCDN上に置かれており、Next.jsのコードには含まれていません。 api-frontend は決済・外部連携を担うAPIルートをホスティングしているNext.jsアプリです。サーバーサイドで動作するため、リクエスト時に動的な処理が可能です。 OGPエンドポイントはリクエスト時に内部APIから書影データを動的に取得する必要があります。静的エクスポートの frontend はビルド済みファイルを配信するだけでリクエスト時にコードを実行できないため、api-frontend に実装します。 対応前後のリクエスト経路の違いを示します。 【対応前:通常ユーザー・Twitterbot 共通】 シェア URL ─→ frontend(CDN)─→ HTML 配信(OGP タグに書影なし) ↑ Twitterbot はここで OGP を読む → 書影なし 【対応後:User-Agent で処理を分岐】 シェア URL ─→ api-frontend /api/ogp/titles/{slug} ├─ 一般 UA ────→ 302 ─→ /titles/{slug}/detail/(frontend) └─ Twitterbot ─→ 内部 GraphQL API で書影データ取得 ─→ CDN URL + origin_key で og:image 組み立て ─→ OGP タグ入り HTML を 200 で返す 静的エクスポートと Twitterbot の相性問題 静的エクスポートとは Next.jsには主に2つの出力方式があります。 ...

2026年5月31日 · 読了時間: 4分 · 鈴木愛麗
「Type Safety」のラベルが付いた盾アイコン、Orval のシンボル、「API Integration」のラベルが付いた合流矢印アイコンが横一列に並び、下部に「Orval で組む型安全 API 統合」のタイトルが配置されたカバー画像

Orval で組む型安全 API 統合 ── mutator 分離・Zod 二段防御・MSW 二層モックの実践

はじめに こんにちは。and factory フロントエンドエンジニアの青木です。 現在関わっているプロジェクトのフロントエンドで採用している、OpenAPI を Single Source of Truth とした型安全 API 統合パターン を紹介します。 Orvalでやっていることを並べると次のとおりです。 バックエンドの make openapi で生成されたYAMLをフロント側にコピー 1コマンドで 型定義 / TanStack Query Hook / Zodスキーマ / MSWモック までを一括生成 公開APIと認証APIで operationId 単位に mutator を切り替え、誤用を生成時点で防ぐ Zodの 二段防御 (coerce × transform) で unknown をコンポーネント層に到達させない 前提: Single Source of Truth とは Single Source of Truth (SSoT) は、ある情報の 「正しい定義を置く場所を 1 箇所に固定する」 設計原則です。日本語では「信頼できる唯一の情報源」と訳されます。 例えばAPIの「リクエスト/レスポンスの形」をプロジェクトのあちこちに書いていると、以下の問題が起きます。 バックエンドが型を変えたのにフロントのTypeScript型が古いまま動いてしまう ドキュメントとコードがズレて、新規参画者がどちらを信じればよいか分からなくなる 同じ情報を複数箇所で手書きするため、変更時の修正漏れが必ず発生する これを防ぐため、「APIの形」を openapi.yaml という1つのファイルに集約 しています。フロントの型・Hook・Zod・MSWモックは、すべてそこから自動生成する運用です。 flowchart TD A["openapi.yaml<br/>(唯一の「真実」)"]:::source A --> B[TypeScript 型] A --> C[TanStack Query Hook] A --> D[Zod 検証スキーマ] A --> E[MSW モックハンドラ] classDef source fill:#0ea5e9,color:#fff,stroke:#0369a1,stroke-width:2px これが「OpenAPIをSingle Source of Truthにする」の意味です。openapi.yaml を更新して pnpm run generate:api を実行すれば、全派生物が機械的に再生成されます。手作業の同期は不要です。 ...

2026年5月29日 · 読了時間: 9分 · 青木大地
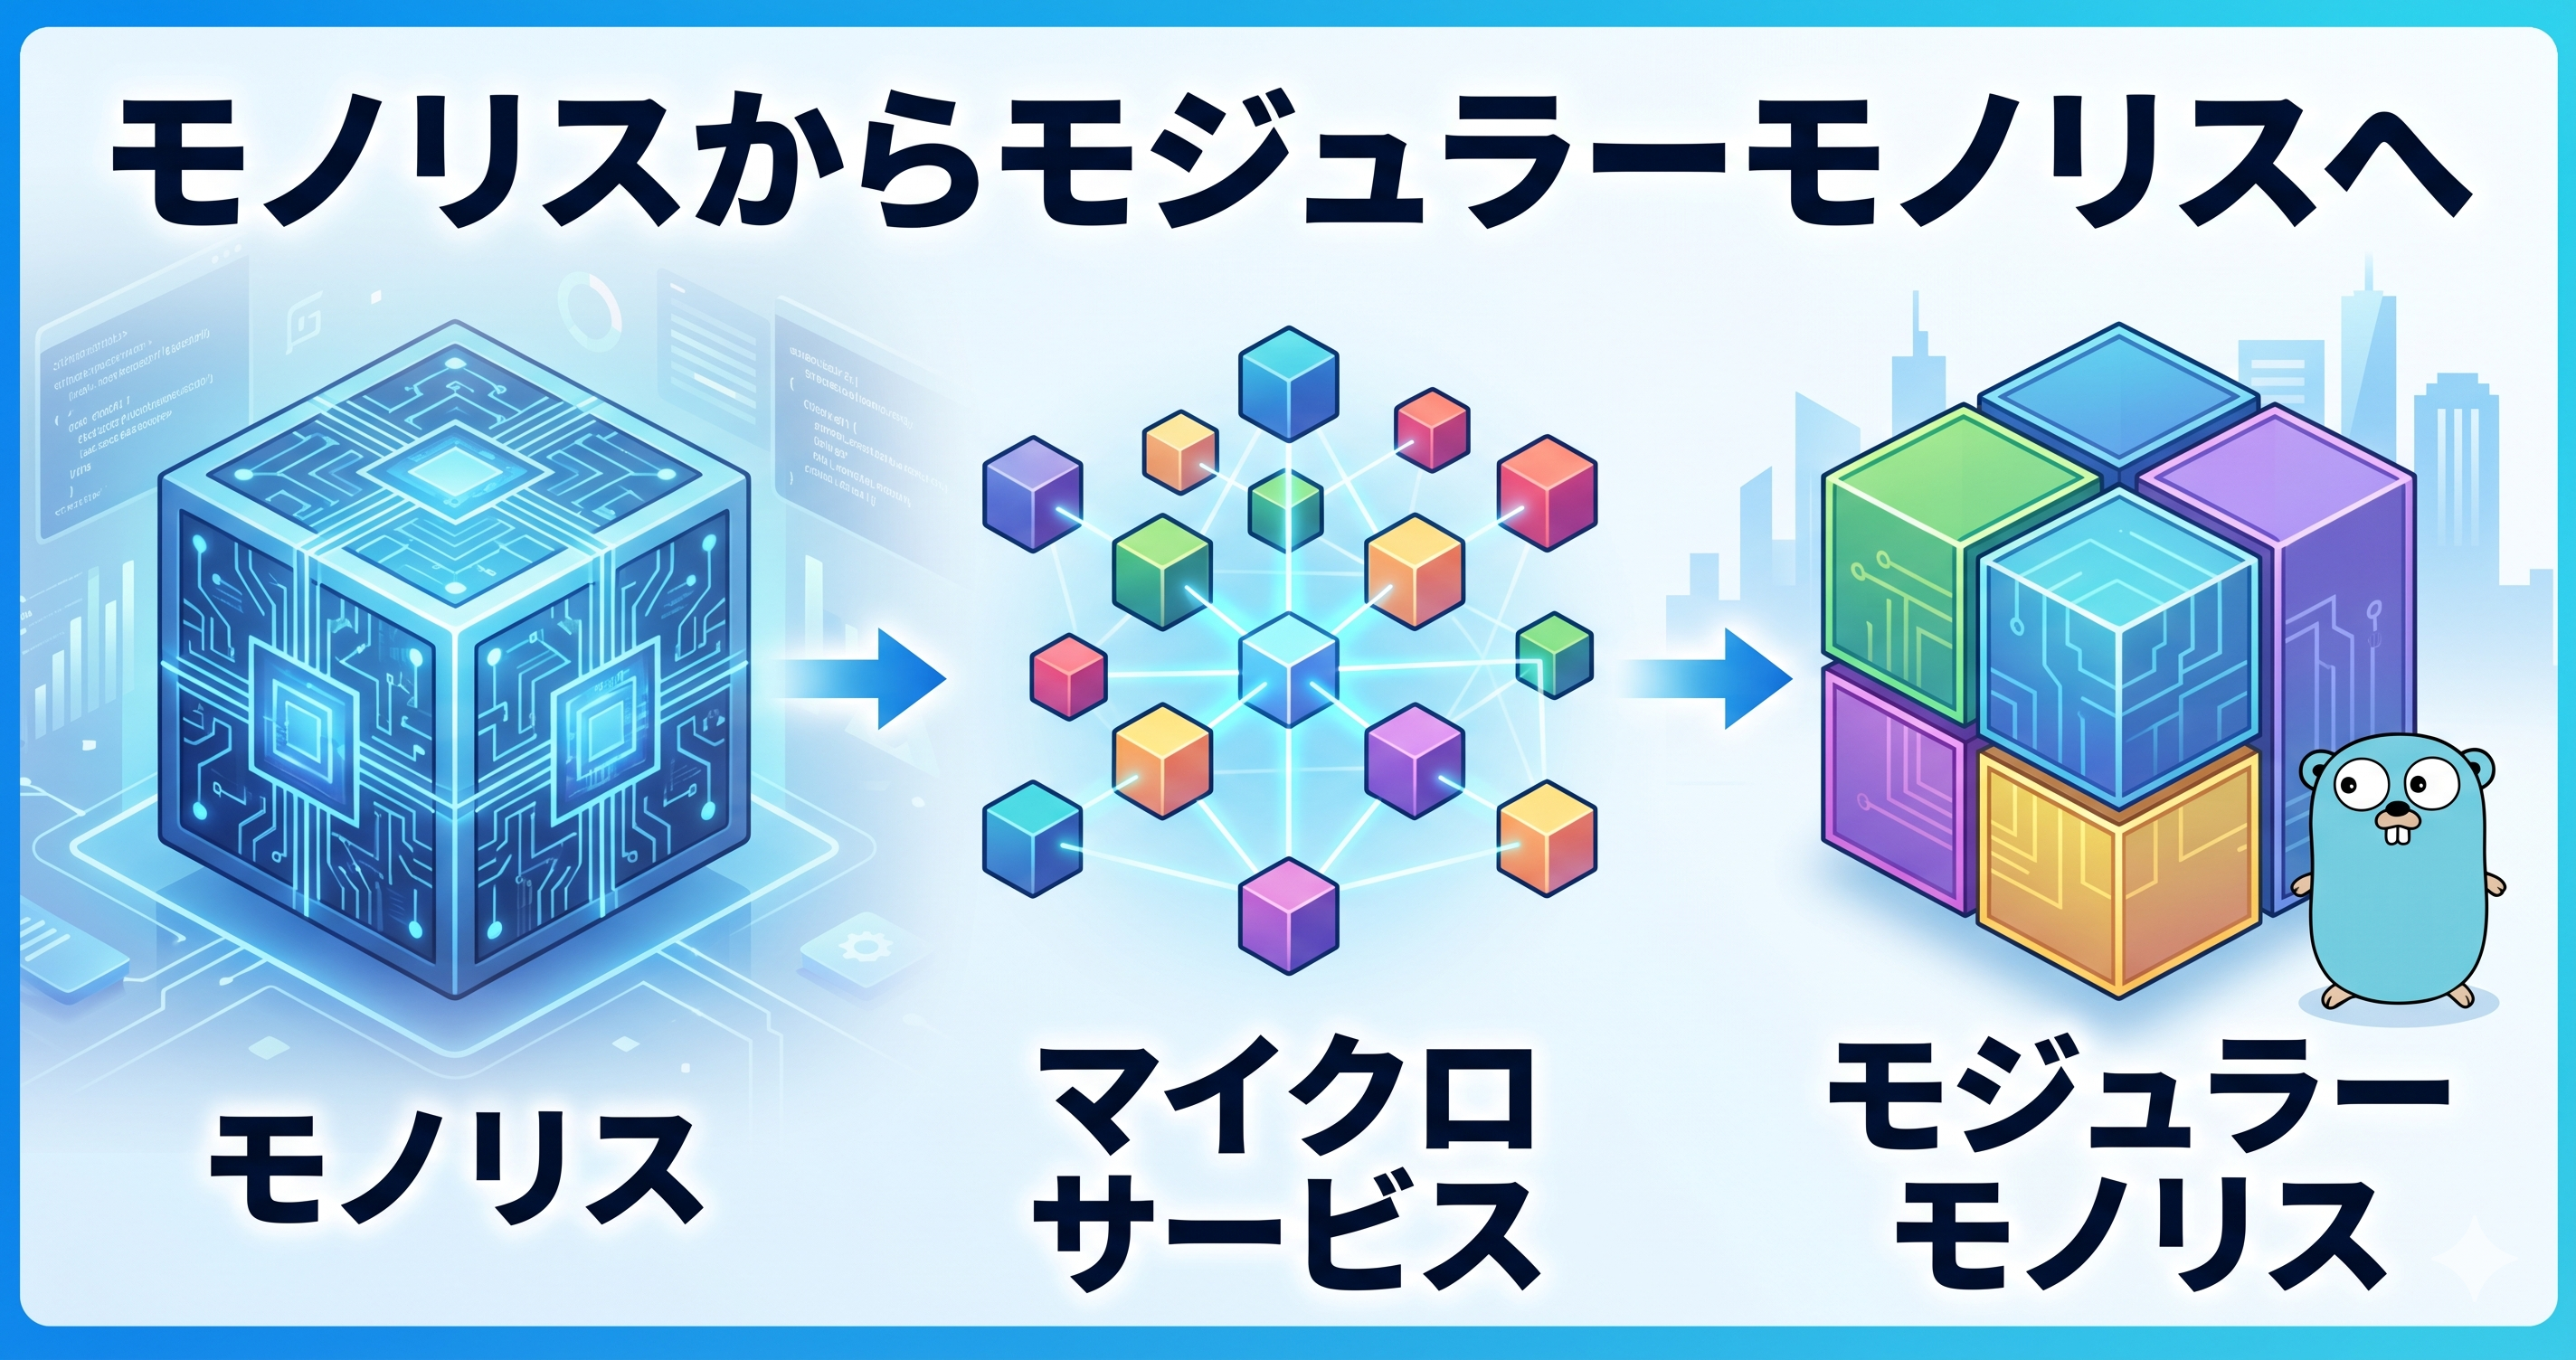
モノリスからマイクロサービス、モジュラーモノリスへの変遷を示す概念図

Goで実装するバックエンドのモジュラーモノリス構成

1. はじめに 私が担当しているサービスのバックエンドでは モジュラーモノリス を採用しています。本記事では、採用に至った判断軸、実際の構成、運用してみての所感を整理します。 以降の説明は、例として架空の オンラインレッスンプラットフォーム を題材に進めます。クライアントとしてはユーザー向けサイト・講師向けサイト・カスタマーサポート向けサイトを想定します。会員・講師・ポイント・レッスン予約・シフト・レビューといった共通のドメイン領域を、これら複数のクライアントが共有するサービスを思い浮かべてください。 クライアントごとに独立したバックエンドを並べる構成では、各バックエンドで類似の実装が増えがちです。ドメインの中核(会員管理、ポイント、受講履歴など)は本質的に1つしかないため、修正のたびに複数のリポジトリへ改修を加える必要があります。マイクロサービスとモジュラーモノリスの両方を比較した結果、最終的にモジュラーモノリスを採用する判断に至りました。 対象読者 複数のクライアント・チームから利用される中規模のバックエンドを設計し直そうとしている方 マイクロサービス化を検討しているが、本当に必要かを判断したい方 Goの go.work / go.mod でモジュール境界をどう引くかに興味がある方 TL;DR 対象は「ドメインは1つ、クライアントは複数」の構成。マイクロサービスのメリットより、単一トランザクションで処理できる利点のほうが大きかった 「業務モジュール群」と「クライアント別バックエンド」を分離した。業務モジュールは1つのリポジトリ(以降「コアモジュール群リポジトリ」と呼ぶ)の中で account / lesson / point / system などのサブモジュールに分けた。各バックエンドはそれらをGoの require 経由で取り込む モジュール単位で go.mod を切り、go.work で開発時だけ束ねる。本番ビルドではバージョン付きモジュールを取り込むので、依存方向と境界が物理的に強制される 将来マイクロサービス化したくなったら、モジュール単体を切り出しやすい構造にしておく、というのが導入時の合意事項 2. 当時の状況と課題 今回のアーキテクチャ刷新は、運用中のサービスを動かしながら行ったわけではなく、新規サービスの初期設計・実装を進めている途中で方針転換したものです。最初は従来どおり「クライアントごとに独立したバックエンドを並べる」構成で書き始めていました。しかし検討が深まるにつれて「このままリリースすると技術負債が制御できなくなる」と判断し、設計を全面的に見直しました。リリース後に修正するよりも、構築段階で構造を変えるほうが長期的に安いという見積もりです。 書き始めていた構成を具体的に示すと、次のとおりです。 ユーザー向けサイト用バックエンド・講師向けサイト用バックエンド・カスタマーサポート向けサイト用バックエンドがそれぞれ独立したリポジトリ 共通DBを直接参照する 共通処理は社内パッケージとして切り出していたが、ビジネスロジック層は各リポジトリ内に重複 この構成では、次のような状況が起きていました。 同じドメインルールが複数箇所に散らばる。「ポイント消費時の残高検証ロジック」のように、ユーザー向けサイトとカスタマーサポート向けサイトの双方から呼び出される処理が両リポジトリで似て非なる実装になりがち 修正の波及がレビューしきれない。テーブル定義を変えると、3〜4リポジトリでマイグレーションと修正をセットで進める必要がある トランザクション境界が曖昧。同じテーブルを別アプリから書き込むため、整合性は実質的にアプリ側の実装規律に依存 「サービスを分ける」方向に振るか、「中身を共通化する」方向に振るかをここで決める必要がありました。 3. マイクロサービスを比較対象として置いた 最初に検討したのはマイクロサービス化です。会員・講師・ポイント・レッスンをそれぞれ独立したサービスにして、gRPC経由で通信させる構成です。 マイクロサービスのメリット(私たちのケースで) 責任が分割されるので各サービスのソースコードはシンプルに保てる 将来、特定ドメインだけスケールアウトしたい場合に独立してスケーリングできる マイクロサービスのデメリット(私たちのケースで) 単一トランザクションで処理できない。ポイント残高・予約・受講履歴など同時に整合していないと厳しい業務が多く、課金系で部分失敗が起きた場合の運用設計をすべて自前で用意する必要がある ユーザー名やニックネームでの横断検索が一気に難しくなる。カスタマーサポートから「この名前で会員と講師を横断検索したい」というニーズは日常的にあり、サービス境界をまたいで実装するコストが大きい proto 定義に思いのほか時間がかかる。共通protoリポジトリにpush → 各サービスの go.mod を更新 → 反映、という流れがユースケース追加のたびに発生する そもそも私たちは複数チームで大規模な並列開発をするほどの規模ではない。マイクロサービス本来のメリットである「組織のスケール」が享受しにくい 「単純なモノリス」では戻したくない理由 一方で「全部1つの大きなアプリに戻す」という選択も適切ではありません。前述のとおり、アーキテクチャ刷新前の状態はまさに「重複のあるモノリス的運用」で、ドメインの境界が曖昧なまま規模だけ大きくなることの痛みは身をもって知っていたからです。 その中間として現実的なのは、1つのデプロイ単位の中で内部を明確に分割するモジュラーモノリスです。 4. モジュラーモノリスを選んだ判断軸 §2で挙げた課題と、本節で照らし合わせる観点は次のように対応します。 ...

2026年5月18日 · 読了時間: 5分 · 瀬戸敏文